공통 · 하드웨어 · 2026-09-18
여러 GPU를 어떻게 배치할까?
먼저 작업을 실행할 수 있게 모델을 나누고, 그 구성을 복제한 뒤, 응답 시간과 처리량에 맞춰 GPU 배치를 조정합니다.
여러 GPU를 사용할 때 먼저 해결할 문제는 모델을 올리고, 실제 작업을 처리할 수 있는 구성을 만드는 것입니다. 이 구성이 마련되면 같은 모델을 실행하는 그룹을 더 두어 서로 다른 입력을 처리할 수 있습니다. 그다음에는 한 모델의 계산에 GPU를 더 쓸지, 독립적인 복제본을 더 둘지 조정합니다.
이 글에서는 고정된 가중치로 서로 다른 요청을 처리하는 Dense 모델의 추론을 예시로, TP로 나눈 모델을 DP로 복제하는 구성을 살펴보겠습니다.
먼저 작업을 실행할 공간 확보하기
GPU에 모델 가중치를 올렸다고 바로 작업을 처리할 수 있는 것은 아닙니다. 입력을 계산하면서 생기는 활성값, 요청별로 유지하는 상태, 통신 버퍼 등에도 메모리가 필요합니다. 목표 입력을 처리할 때 필요한 값들이 각 GPU에 들어가야 실행 가능한 구성입니다.
가중치가 너무 크다면 모델을 여러 GPU에 나누어 배치할 수 있습니다. TP는 가중치와 그 연산을 나누고, PP는 모델의 층을 나눕니다. MoE 모델이라면 EP로 Expert 가중치를 나눌 수 있습니다. 실행 중 활성값이나 긴 문맥이 메모리를 많이 차지한다면 SP나 CP도 함께 검토할 수 있습니다. 한 GPU에서 필요한 작업을 충분히 처리할 수 있다면, 이 분할부터 적용할 필요는 없습니다.
그림에서는 가중치가 24 GiB인 모델과, GPU마다 사용할 수 있는 메모리가 24 GiB인 환경을 생각하겠습니다. GiB는 2의 거듭제곱 기준의 용량 단위입니다. 요청 상태·활성값·버퍼 등 가중치 이외의 실행 공간을 GPU마다 8 GiB로 가정합니다.
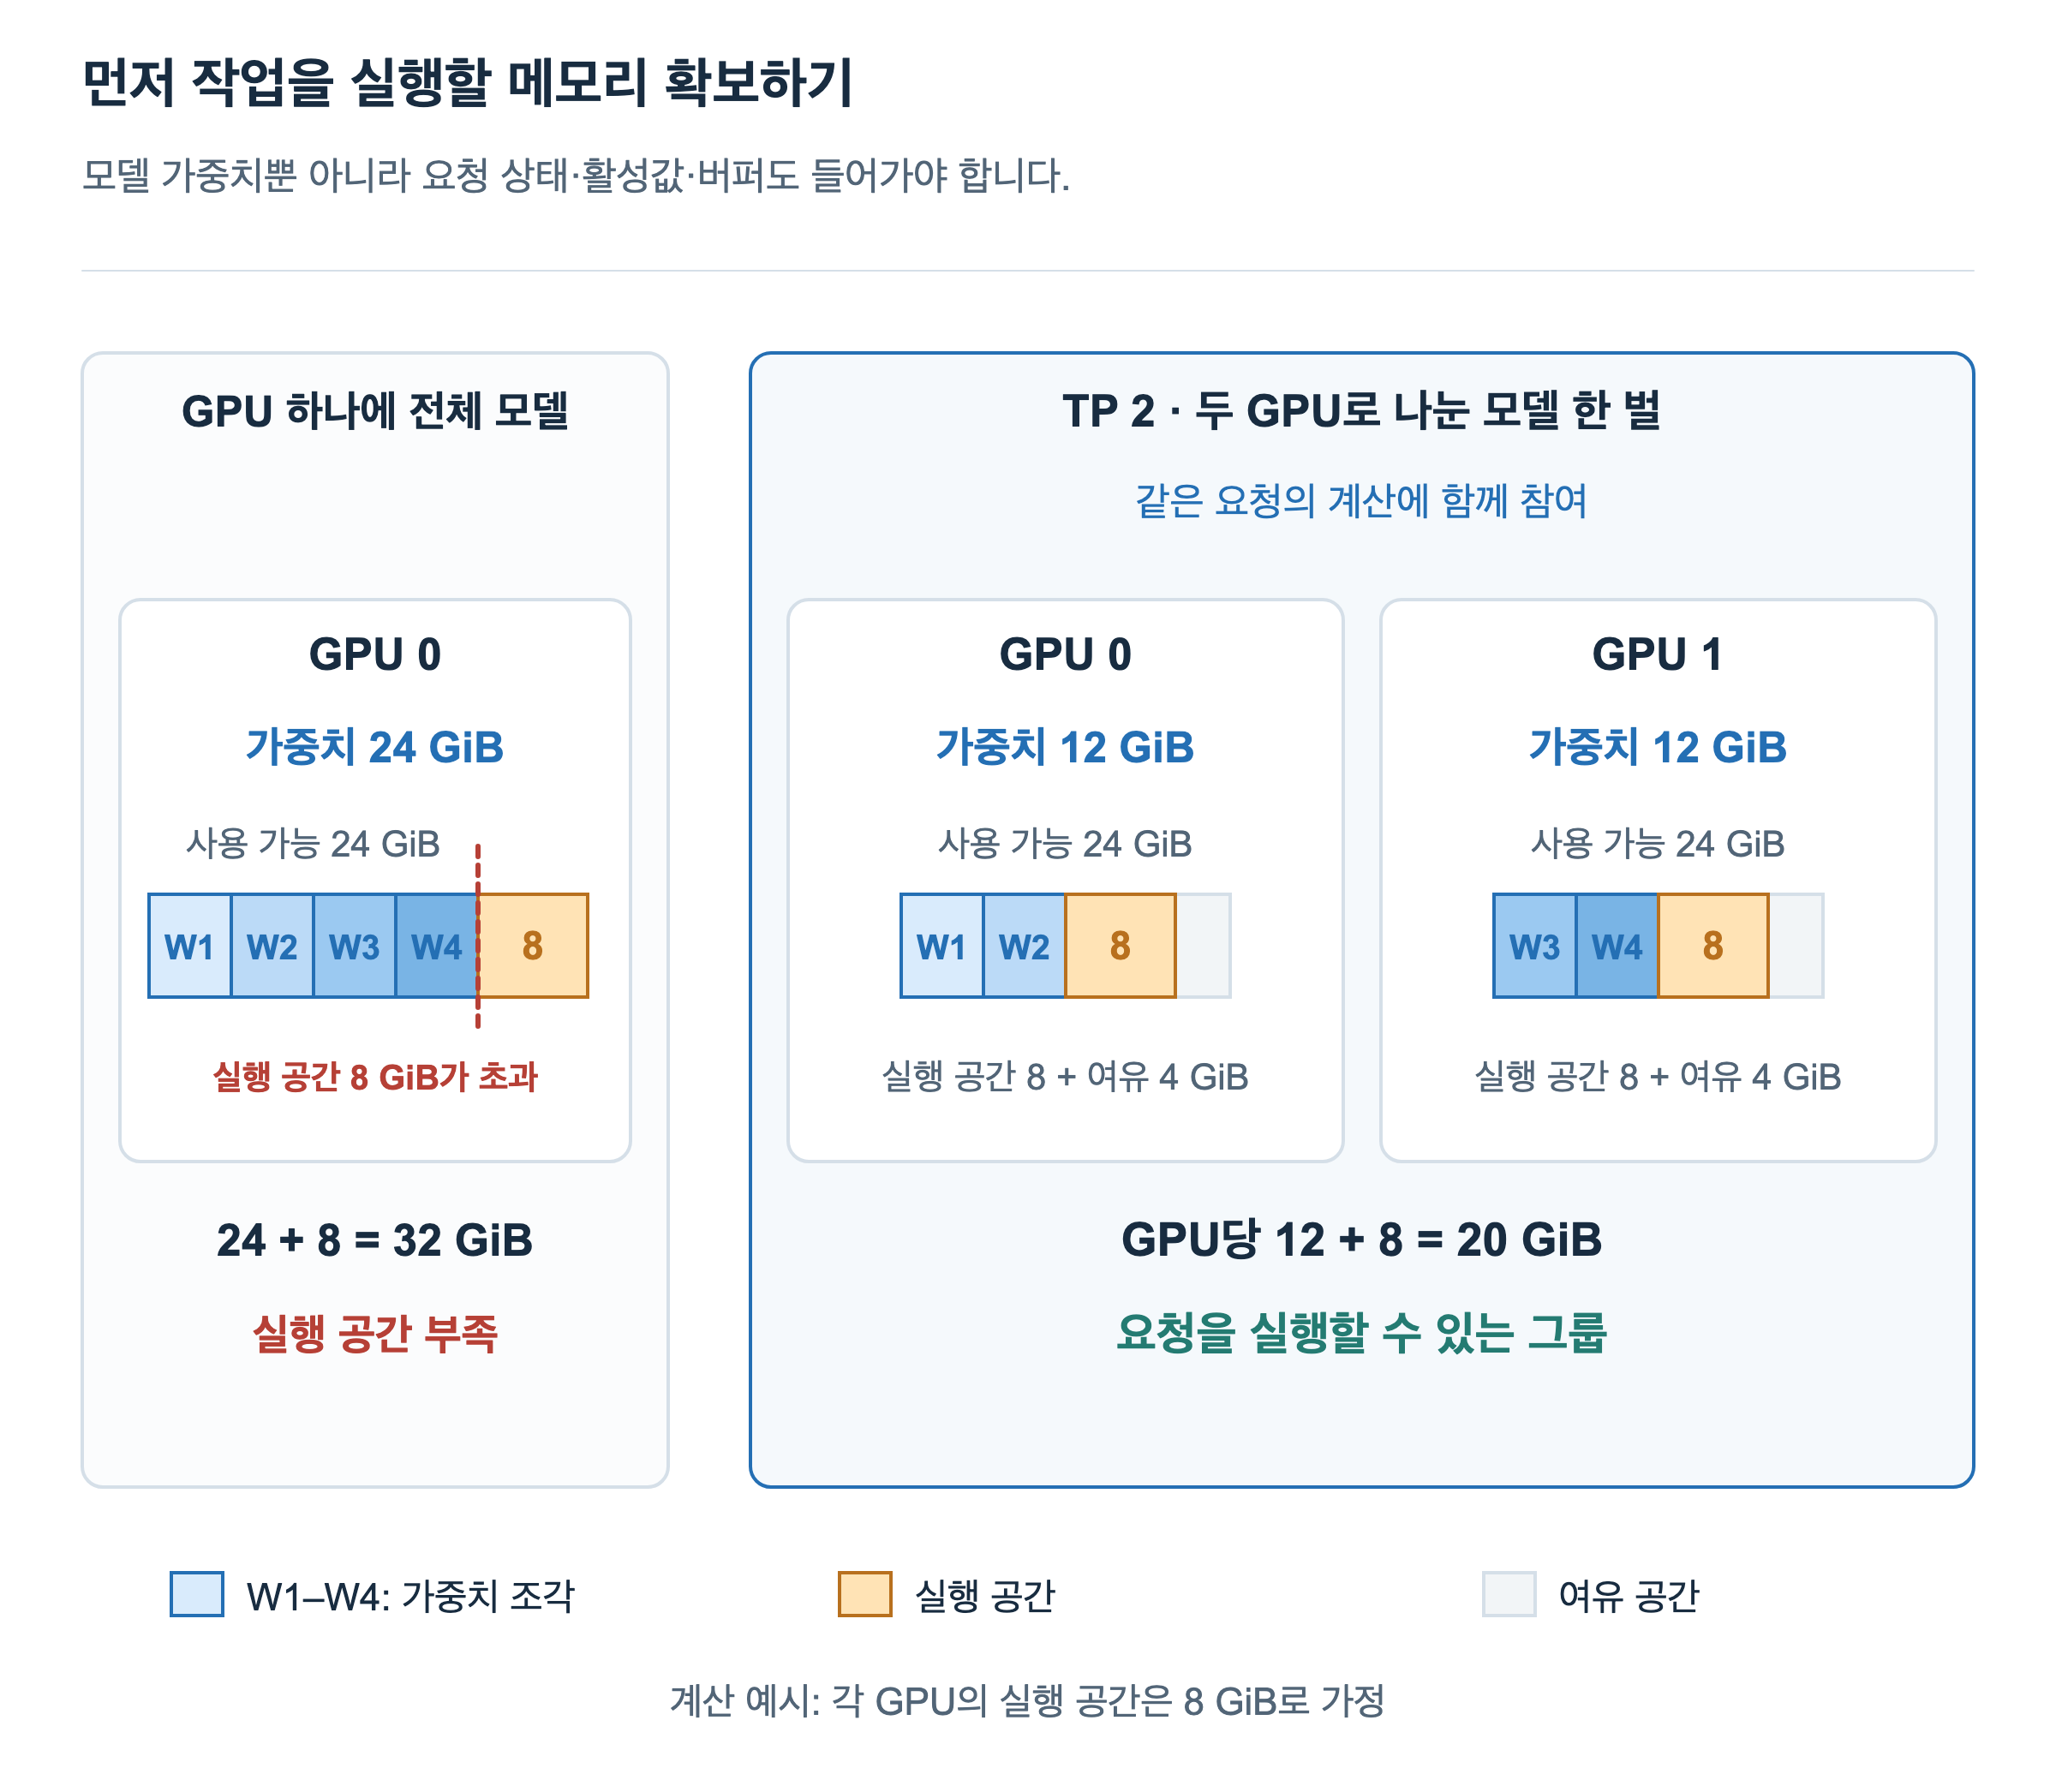
왼쪽에서는 가중치만으로 24 GiB를 모두 사용합니다. 작업에 필요한 8 GiB까지 더하면 32 GiB이므로 메모리가 부족합니다. GPU를 더 연결해도 메모리가 자동으로 하나의 큰 공간이 되지는 않으므로, 실제로 가중치나 실행 중 데이터를 나누는 구성이 필요합니다.
오른쪽에서는 TP로 가중치를 두 GPU에 나눕니다. W1부터 W4까지는 가중치를 네 조각으로 나타낸 것입니다. GPU 0이 W1·W2를, GPU 1이 W3·W4를 보관하여 GPU당 가중치가 12 GiB가 됩니다. 실행 공간 8 GiB를 더해도 20 GiB이므로 4 GiB가 남습니다. 이제 두 GPU가 한 요청의 계산을 함께 맡는 그룹을 만들 수 있습니다.
이 수치는 용량 관계를 보여주는 예시입니다. 실제로는 모든 가중치를 균등하게 나누지 못할 수 있고, 실행 공간도 입력 길이·함께 처리하는 요청 수·TP 크기에 따라 달라집니다. 따라서 목표 작업을 실행하면서 최고 메모리 사용량과 여유를 확인해야 합니다.
실행 가능한 그룹을 복제해 처리량 늘리기
두 GPU로 작업을 처리할 수 있게 되었고, GPU가 두 개 더 있다고 하겠습니다. 이제 GPU 0·1의 가중치 배치를 GPU 2·3에도 동일하게 두어 모델 한 벌을 더 구성할 수 있습니다. 모델 하나를 더 실행하는 데도 GPU 두 개가 필요한 것입니다.
다음 그림에서 그룹 1에는 요청 A·B를, 그룹 2에는 요청 C·D를 배정합니다. 같은 이름과 색의 W 조각은 동일한 가중치를 뜻합니다. 양방향 화살표는 그룹 내부의 통신 관계를 나타냅니다.
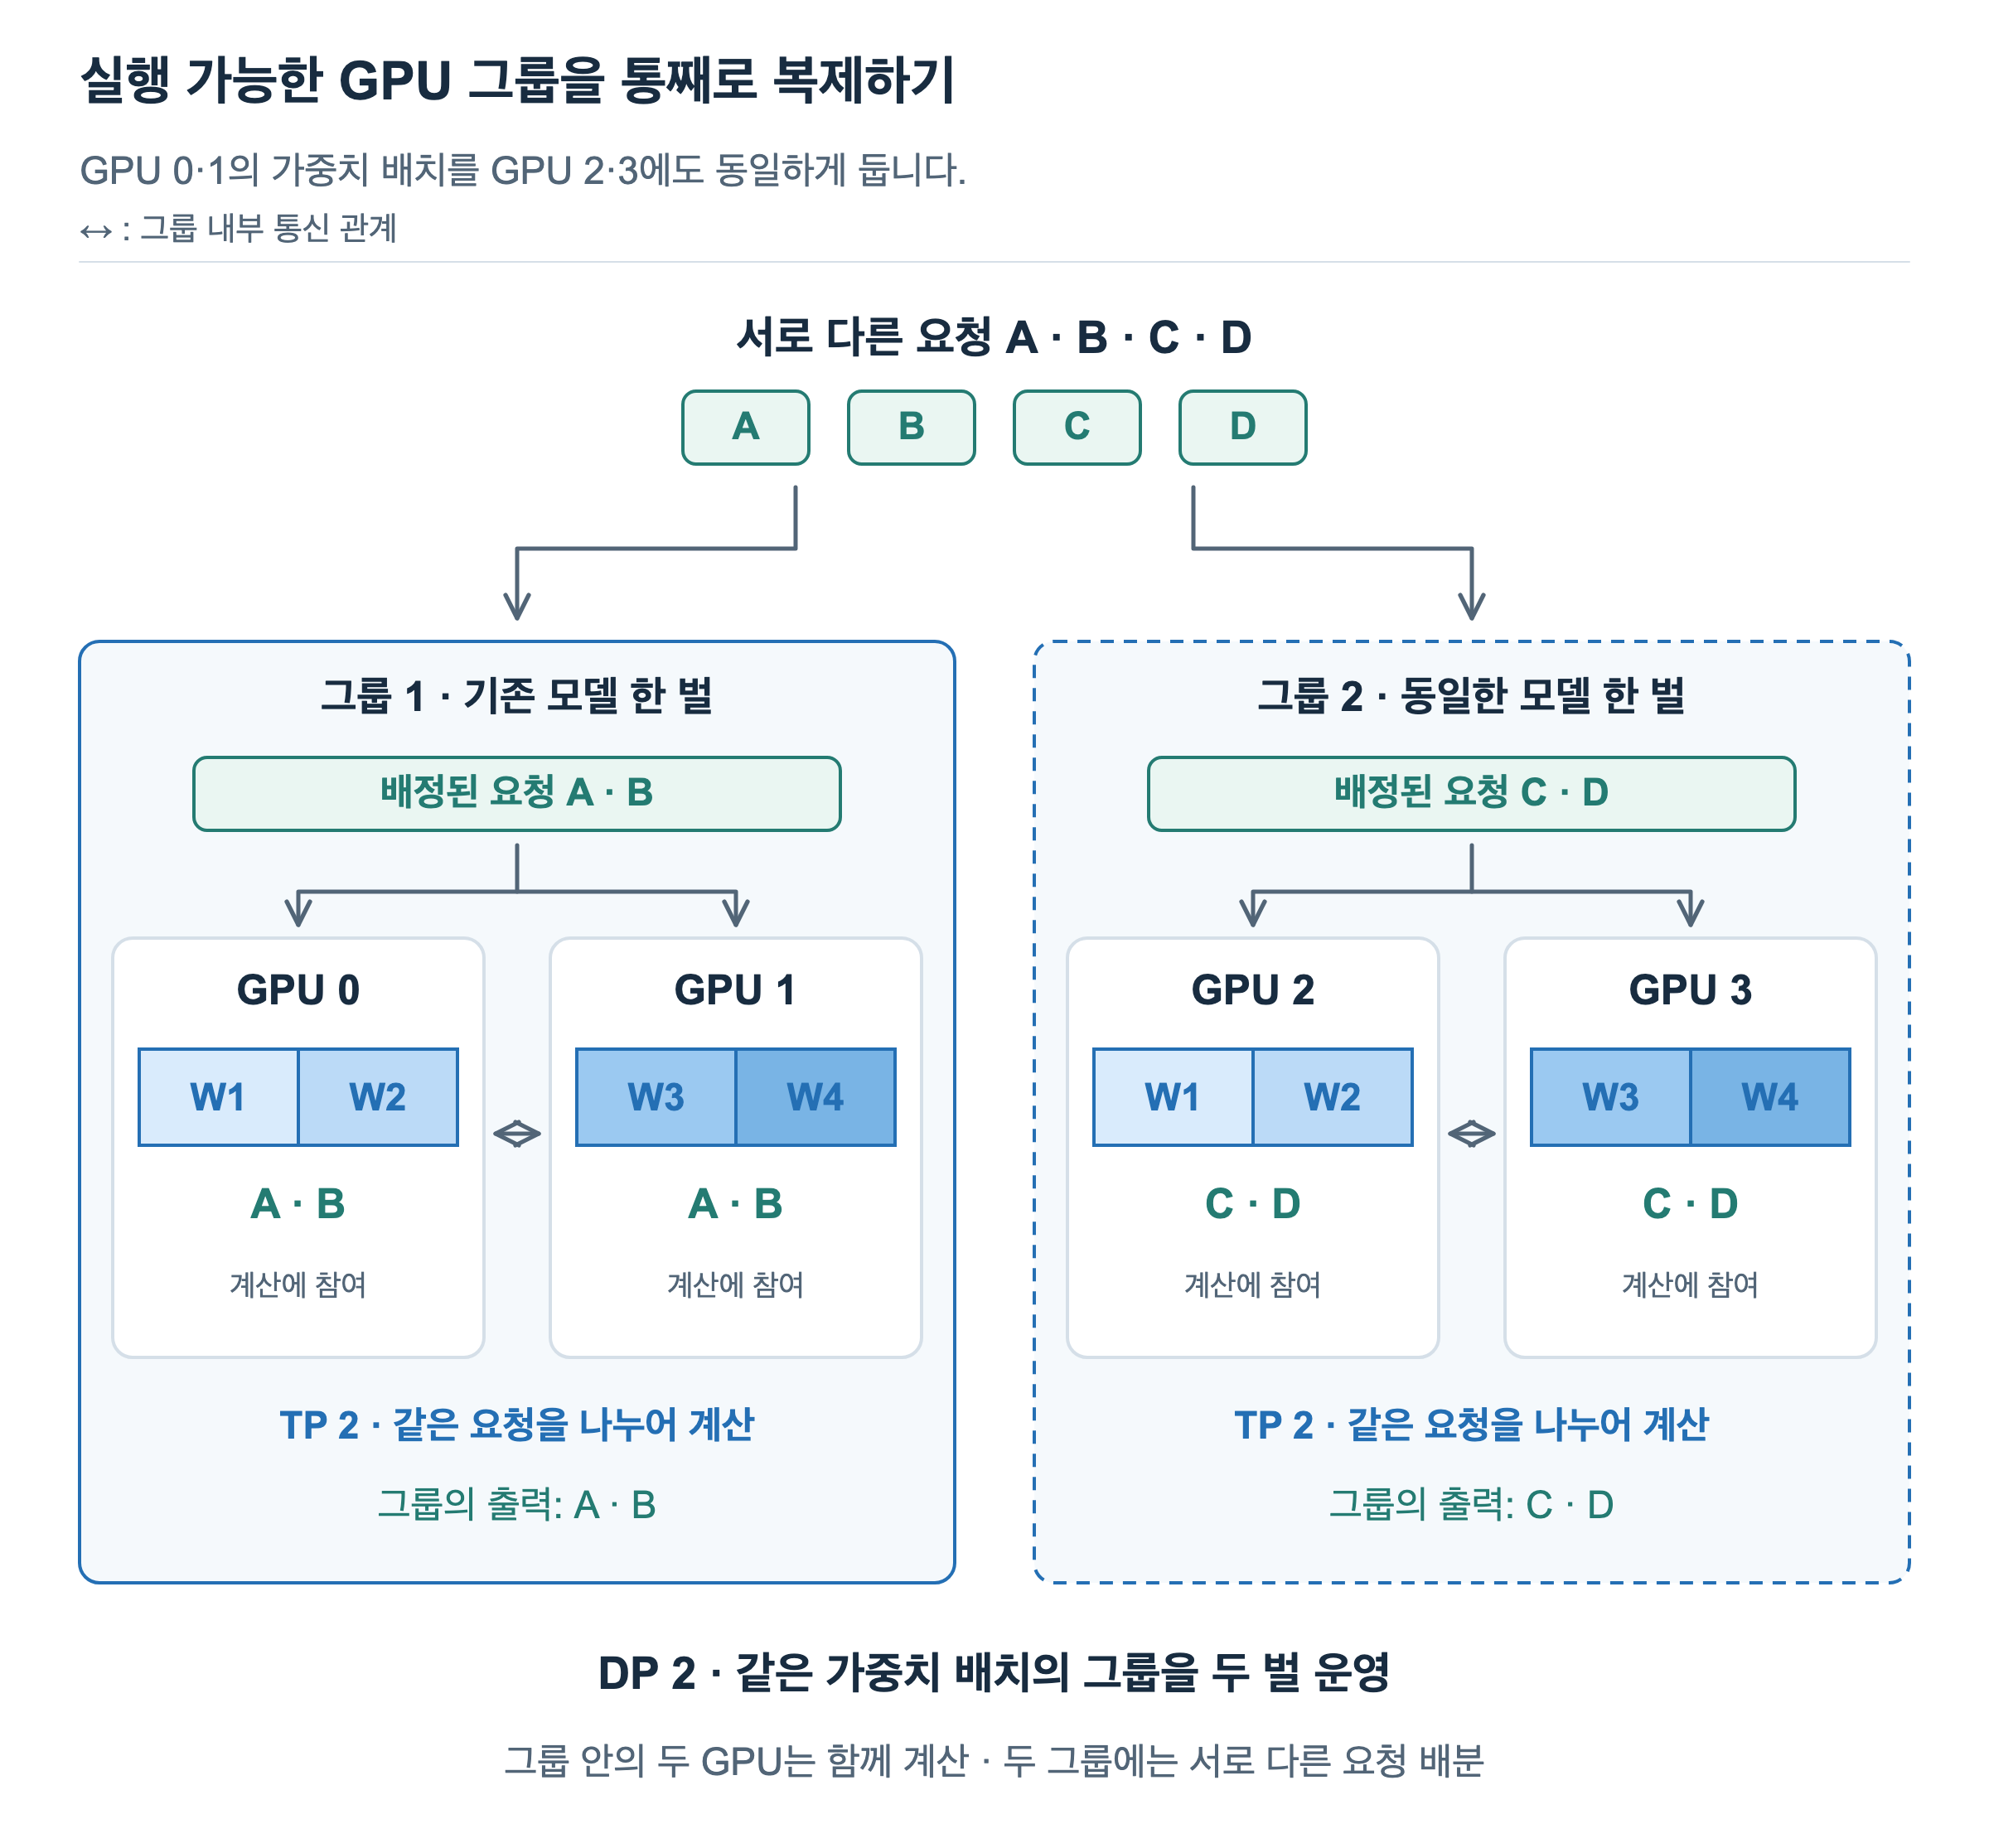
그룹 1 안에서는 GPU 0과 GPU 1이 모두 A·B의 계산에 참여합니다. 두 GPU가 가중치의 서로 다른 부분을 보관하므로, 각자 맡은 계산을 수행하고 필요한 결과를 주고받습니다. GPU 0이 A만 맡고 GPU 1이 B만 맡는 배치가 아닙니다. 그룹 2에서도 같은 방식으로 두 GPU가 C·D를 함께 계산합니다.
반면 두 그룹은 서로 다른 요청을 독립적으로 처리합니다. 각 그룹은 자신이 맡은 요청의 상태를 유지하며, 다른 그룹과 중간 계산 결과를 합칠 필요는 없습니다. 이것이 TP 2 × DP 2입니다. TP 2는 모델 한 벌을 두 GPU가 나누어 처리한다는 뜻이고, DP 2는 그 구성을 두 벌 운영한다는 뜻입니다. DP로 복제하는 대상은 GPU 하나일 수도 있고, 여러 GPU로 이루어진 모델 한 벌일 수도 있습니다.
복제본을 늘리면 같은 시간에 더 많은 요청을 처리할 여지가 생깁니다. 한 요청에 참여하는 GPU 수는 그대로지만, 다른 요청을 맡을 그룹이 늘어나기 때문입니다. 충분한 요청이 들어오고 두 그룹에 일이 고르게 배분될 때 처리량 증가를 기대할 수 있습니다.
한 모델에 쓸 GPU 수와 복제본 수 조정하기
두 GPU로 실행할 수 있다고 해서 나머지 GPU를 복제에 쓰는 것이 항상 최적은 아닙니다. 같은 네 GPU로 두 GPU짜리 모델을 두 벌 둘 수도 있고, 네 GPU짜리 모델을 한 벌 둘 수도 있습니다. 앞에서는 작업이 실행되는 구성을 먼저 찾았고, 이제는 가능한 구성들 사이에서 성능을 비교합니다.
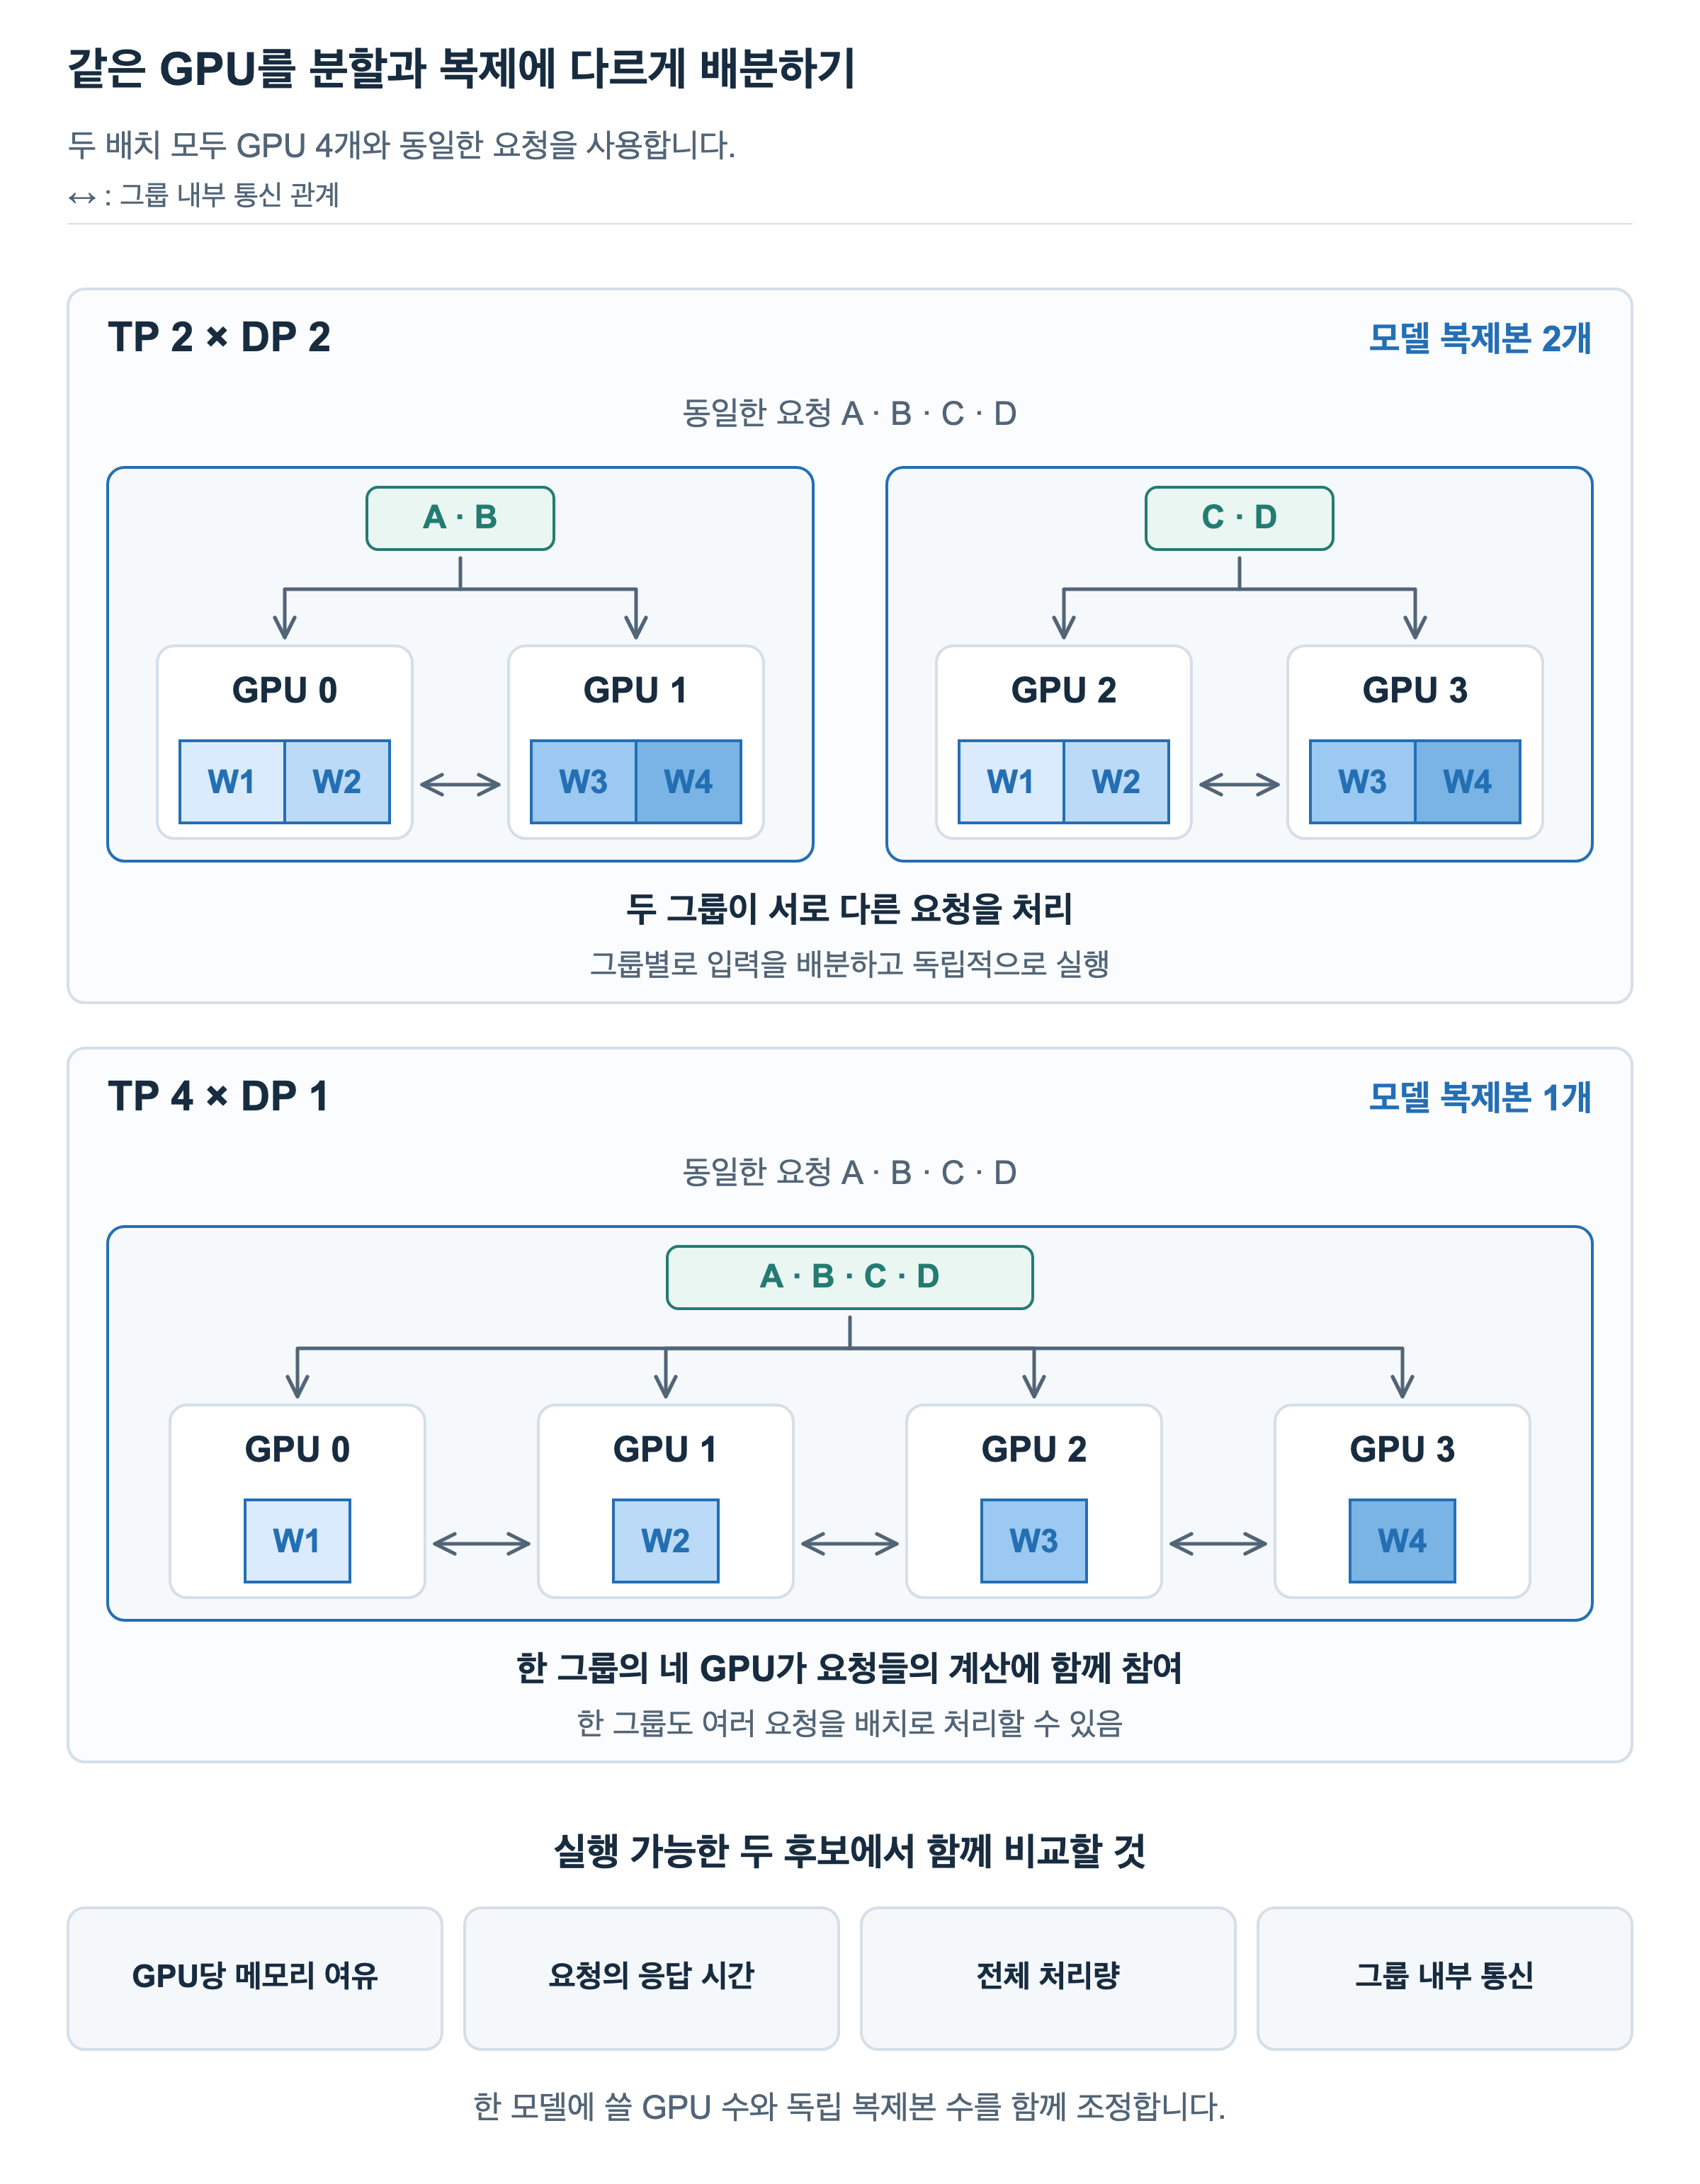
위쪽의 TP 2 × DP 2에서는 두 그룹에 요청을 나누어 줍니다. 아래쪽의 TP 4 × DP 1에서는 네 GPU가 한 그룹으로 요청들의 계산에 참여합니다. 그룹 하나도 여러 요청을 배치로 함께 처리할 수 있습니다. 따라서 복제본이 한 개라고 요청도 한 개씩만 처리하는 것은 아닙니다.
TP 크기를 키우면 가중치와 나눌 수 있는 계산을 더 분산할 수 있습니다. 한 요청의 실행 시간을 줄이거나 메모리 여유를 늘리는 데 도움이 될 수 있지만, 연산 사이에 필요한 통신과 대기도 함께 봐야 합니다. GPU 네 개가 참여한다고 두 개보다 항상 빠르지는 않습니다.
반대로 TP 그룹을 작게 두면 같은 GPU 수로 복제본을 더 운영할 수 있습니다. 서로 다른 요청을 맡을 그룹은 늘지만, 각 그룹이 일을 처리하는 속도와 함께 묶을 수 있는 요청 수가 전체 처리량에 영향을 줍니다. 복제본이 두 배라는 이유만으로 전체 처리량도 두 배라고 결론 내릴 수는 없습니다.
비교할 때는 응답 시간과 처리량을 함께 놓습니다. 응답 시간은 요청이 도착해서 완료될 때까지이며 대기열에서 기다린 시간도 포함합니다. 처리량은 단위 시간에 완료한 작업량입니다. 같은 모델·정밀도·입력과 출력 길이·요청 도착 조건에서, 허용할 응답 시간을 만족하는 범위의 지속 처리량을 비교해야 합니다. 평균뿐 아니라 늦게 끝나는 요청들도 확인합니다.
어느 GPU를 한 그룹으로 묶을지도 중요합니다. GPU 0·1 사이와 2·3 사이의 연결이 빠르고 두 묶음 사이의 연결은 상대적으로 느리다면, 반복 통신이 많은 TP를 연결이 빠른 묶음 안에 두는 구성이 유리할 수 있습니다.
먼저 작업이 실행되게 만들고, 그 구성을 복제한 뒤, 실제 목표에 맞춰 분할과 복제를 조정합니다. 이는 판단을 시작하는 순서입니다. 배치를 바꾸면 계산·통신·요청 대기 중 무엇이 전체 실행을 제한하는지도 달라질 수 있으므로, 바뀐 구성에서 메모리와 응답 시간, 처리량을 다시 확인해야 합니다.