공통 · 하드웨어 · 2026-09-18
집합 통신의 조합과 확장
All-Gather, All-Reduce, Reduce-Scatter, All-to-All을 다음 계산에 필요한 데이터와 결과 배치로 이해합니다.
집합 통신의 기본 동작에서는 같은 데이터를 복사하는 Broadcast, 조각을 나누는 Scatter, 조각을 모으는 Gather, 대응하는 값을 합치는 Reduce를 살펴봤습니다. 이제 이 동작들을 바탕으로 계산을 이어갈 GPU에 어떤 형태의 결과가 필요한지를 생각해보겠습니다.
한 GPU에 모은 결과가 다음 계산을 위해 모든 GPU에도 필요할 수 있습니다. 반대로 값을 합치는 데는 모두의 입력이 필요하지만, 합친 결과는 각자 일부만 맡아도 될 수 있습니다. 각 GPU가 만든 조각을 서로 다른 목적지로 보내야 하는 경우도 있습니다.
이 글에서는 먼저 모으거나 합친 결과를 모두가 갖는 All-Gather와 All-Reduce를 살펴봅니다. 이어서 합친 결과를 나눠 갖는 Reduce-Scatter, 목적지별 조각을 교환하는 All-to-All로 확장합니다. 새로운 이름을 각각 외우기보다, 입력에 어떤 처리를 하고 결과를 어디에 두는지를 따라가겠습니다.
그림은 앞선 글과 같이 네 GPU를 하나의 통신 그룹으로 두고, GPU 번호와 rank를 같게 표시합니다. 입력과 출력은 별도 버퍼입니다. 데이터의 색은 입력의 출처를 따라가며, 여러 줄로 접어 그린 값도 순서대로 이어지는 하나의 배열입니다.
모은 결과를 공유하는 All-Gather
Gather에서는 각 GPU의 배열을 이어 붙인 결과가 root 한곳에 놓였습니다. All-Gather는 그렇게 모은 전체 배열을 모든 참여자가 갖게 합니다.
GPU 0부터 3까지 각각 [1, 2], [10, 20], [100, 200], [1000, 2000]을 갖고 있다고 해보겠습니다. All-Gather가 끝나면 네 GPU 모두 [1, 2, 10, 20, 100, 200, 1000, 2000]을 갖습니다.
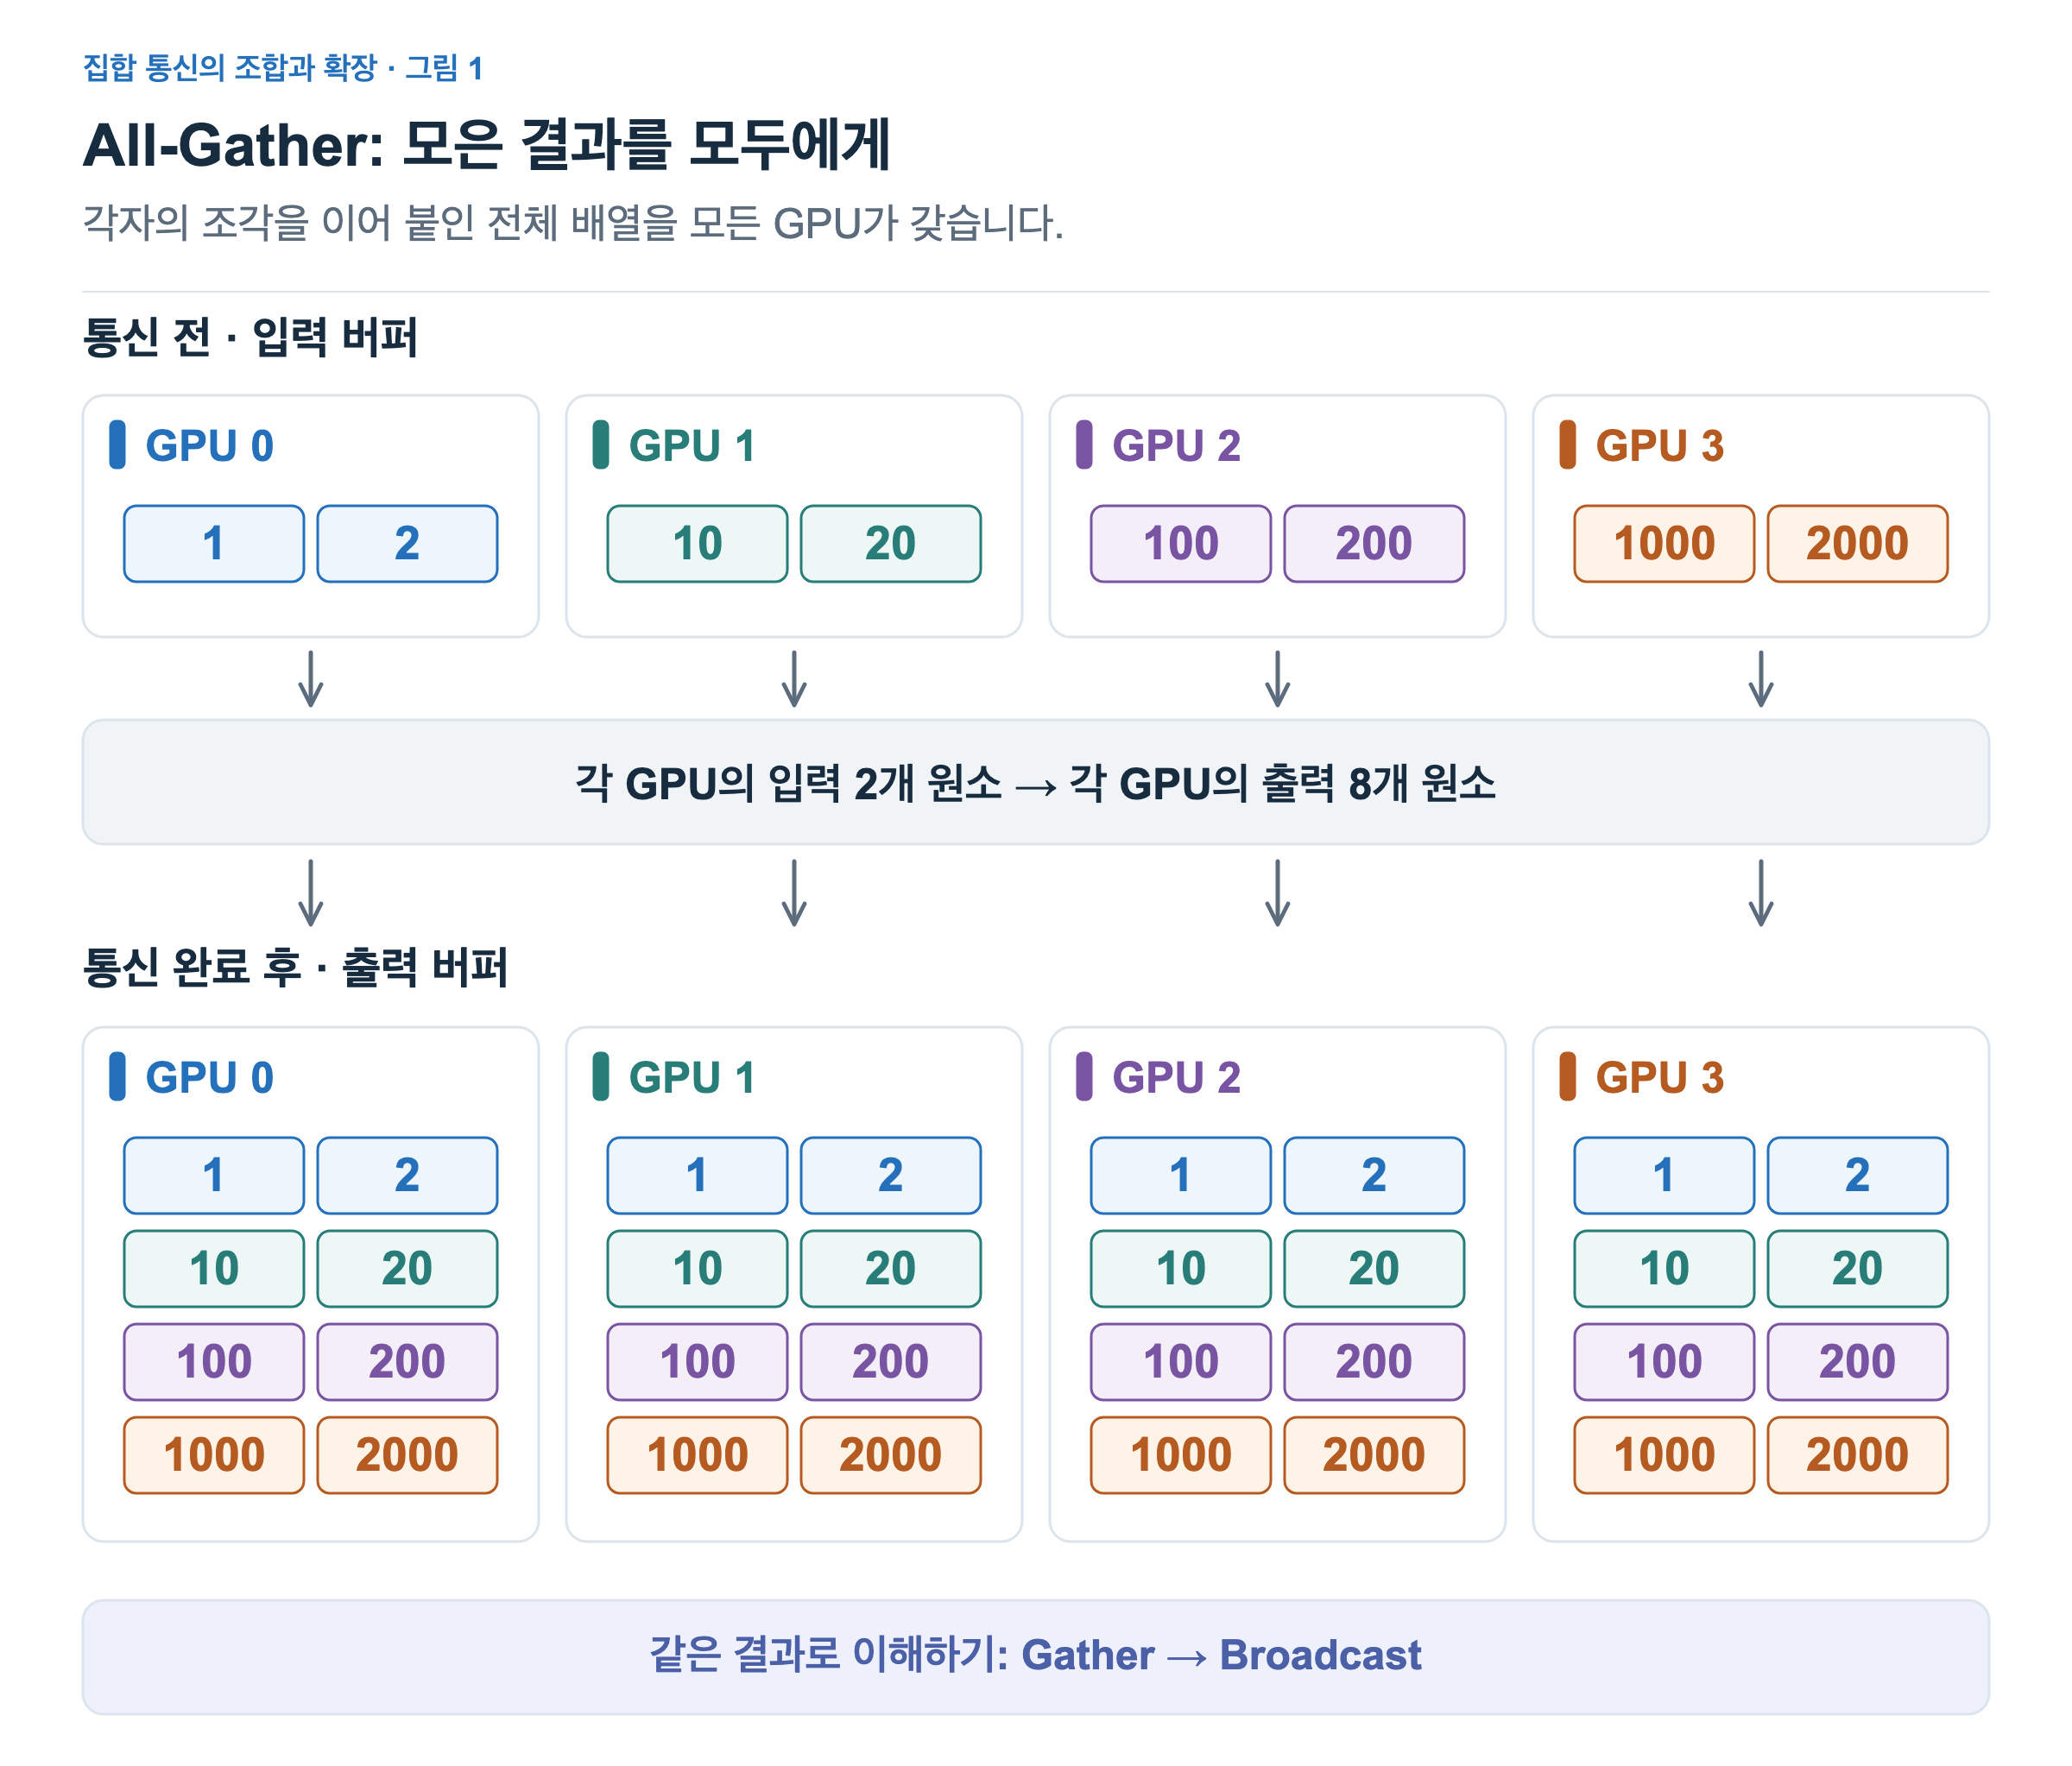
배열을 이어 붙이는 규칙은 Gather와 같습니다. rank 0의 조각 다음에 rank 1, 2, 3의 조각이 놓입니다. 어느 GPU에서 결과를 읽어도 순서가 같고, 자신의 입력도 전체 배열에 포함됩니다.
All-Gather는 Gather로 한곳에 모은 뒤 Broadcast로 모두에게 복사하면 어떤 결과가 생길까를 생각하면 이해하기 쉽습니다. 그 결과가 All-Gather의 결과와 같습니다. 하지만 이 관계는 데이터의 결과를 설명하는 방법입니다. 실제 라이브러리가 반드시 한 GPU에 전부 모은 뒤 다시 뿌리는 두 단계를 실행한다는 뜻은 아닙니다. All-Gather 요청에는 결과를 독점해서 받을 root를 지정할 필요가 없습니다. NCCL의 집합 통신 동작
여기서 이름의 ‘All’을 “이제부터 모두 참여한다”로 읽으면 혼동하기 쉽습니다. Gather도 그룹의 참여자들이 함께 수행합니다. All-Gather에서 달라지는 것은 모은 결과를 모두가 갖는다는 점입니다.
각 GPU의 입력은 두 원소지만 출력은 여덟 원소입니다. 다음 계산에 다른 GPU의 조각까지 전부 필요하다면 유용한 배치입니다. 그만큼 각 GPU는 전체 결과를 담을 공간이 필요합니다.
합친 결과를 공유하는 All-Reduce
각 GPU가 다른 GPU의 입력을 그대로 전부 알아야 하는 것은 아닙니다. 같은 위치끼리 합친 값만 있으면 다음 계산을 진행할 수 있는 경우도 있습니다. All-Reduce는 위치별로 합친 결과를 모든 참여자가 갖게 합니다.
입력을 그대로 두고 덧셈을 적용해보겠습니다. 첫째 원소끼리 더하면 1111, 둘째 원소끼리 더하면 2222입니다. All-Reduce의 결과는 모든 GPU에 같은 [1111, 2222]가 놓이는 것입니다.
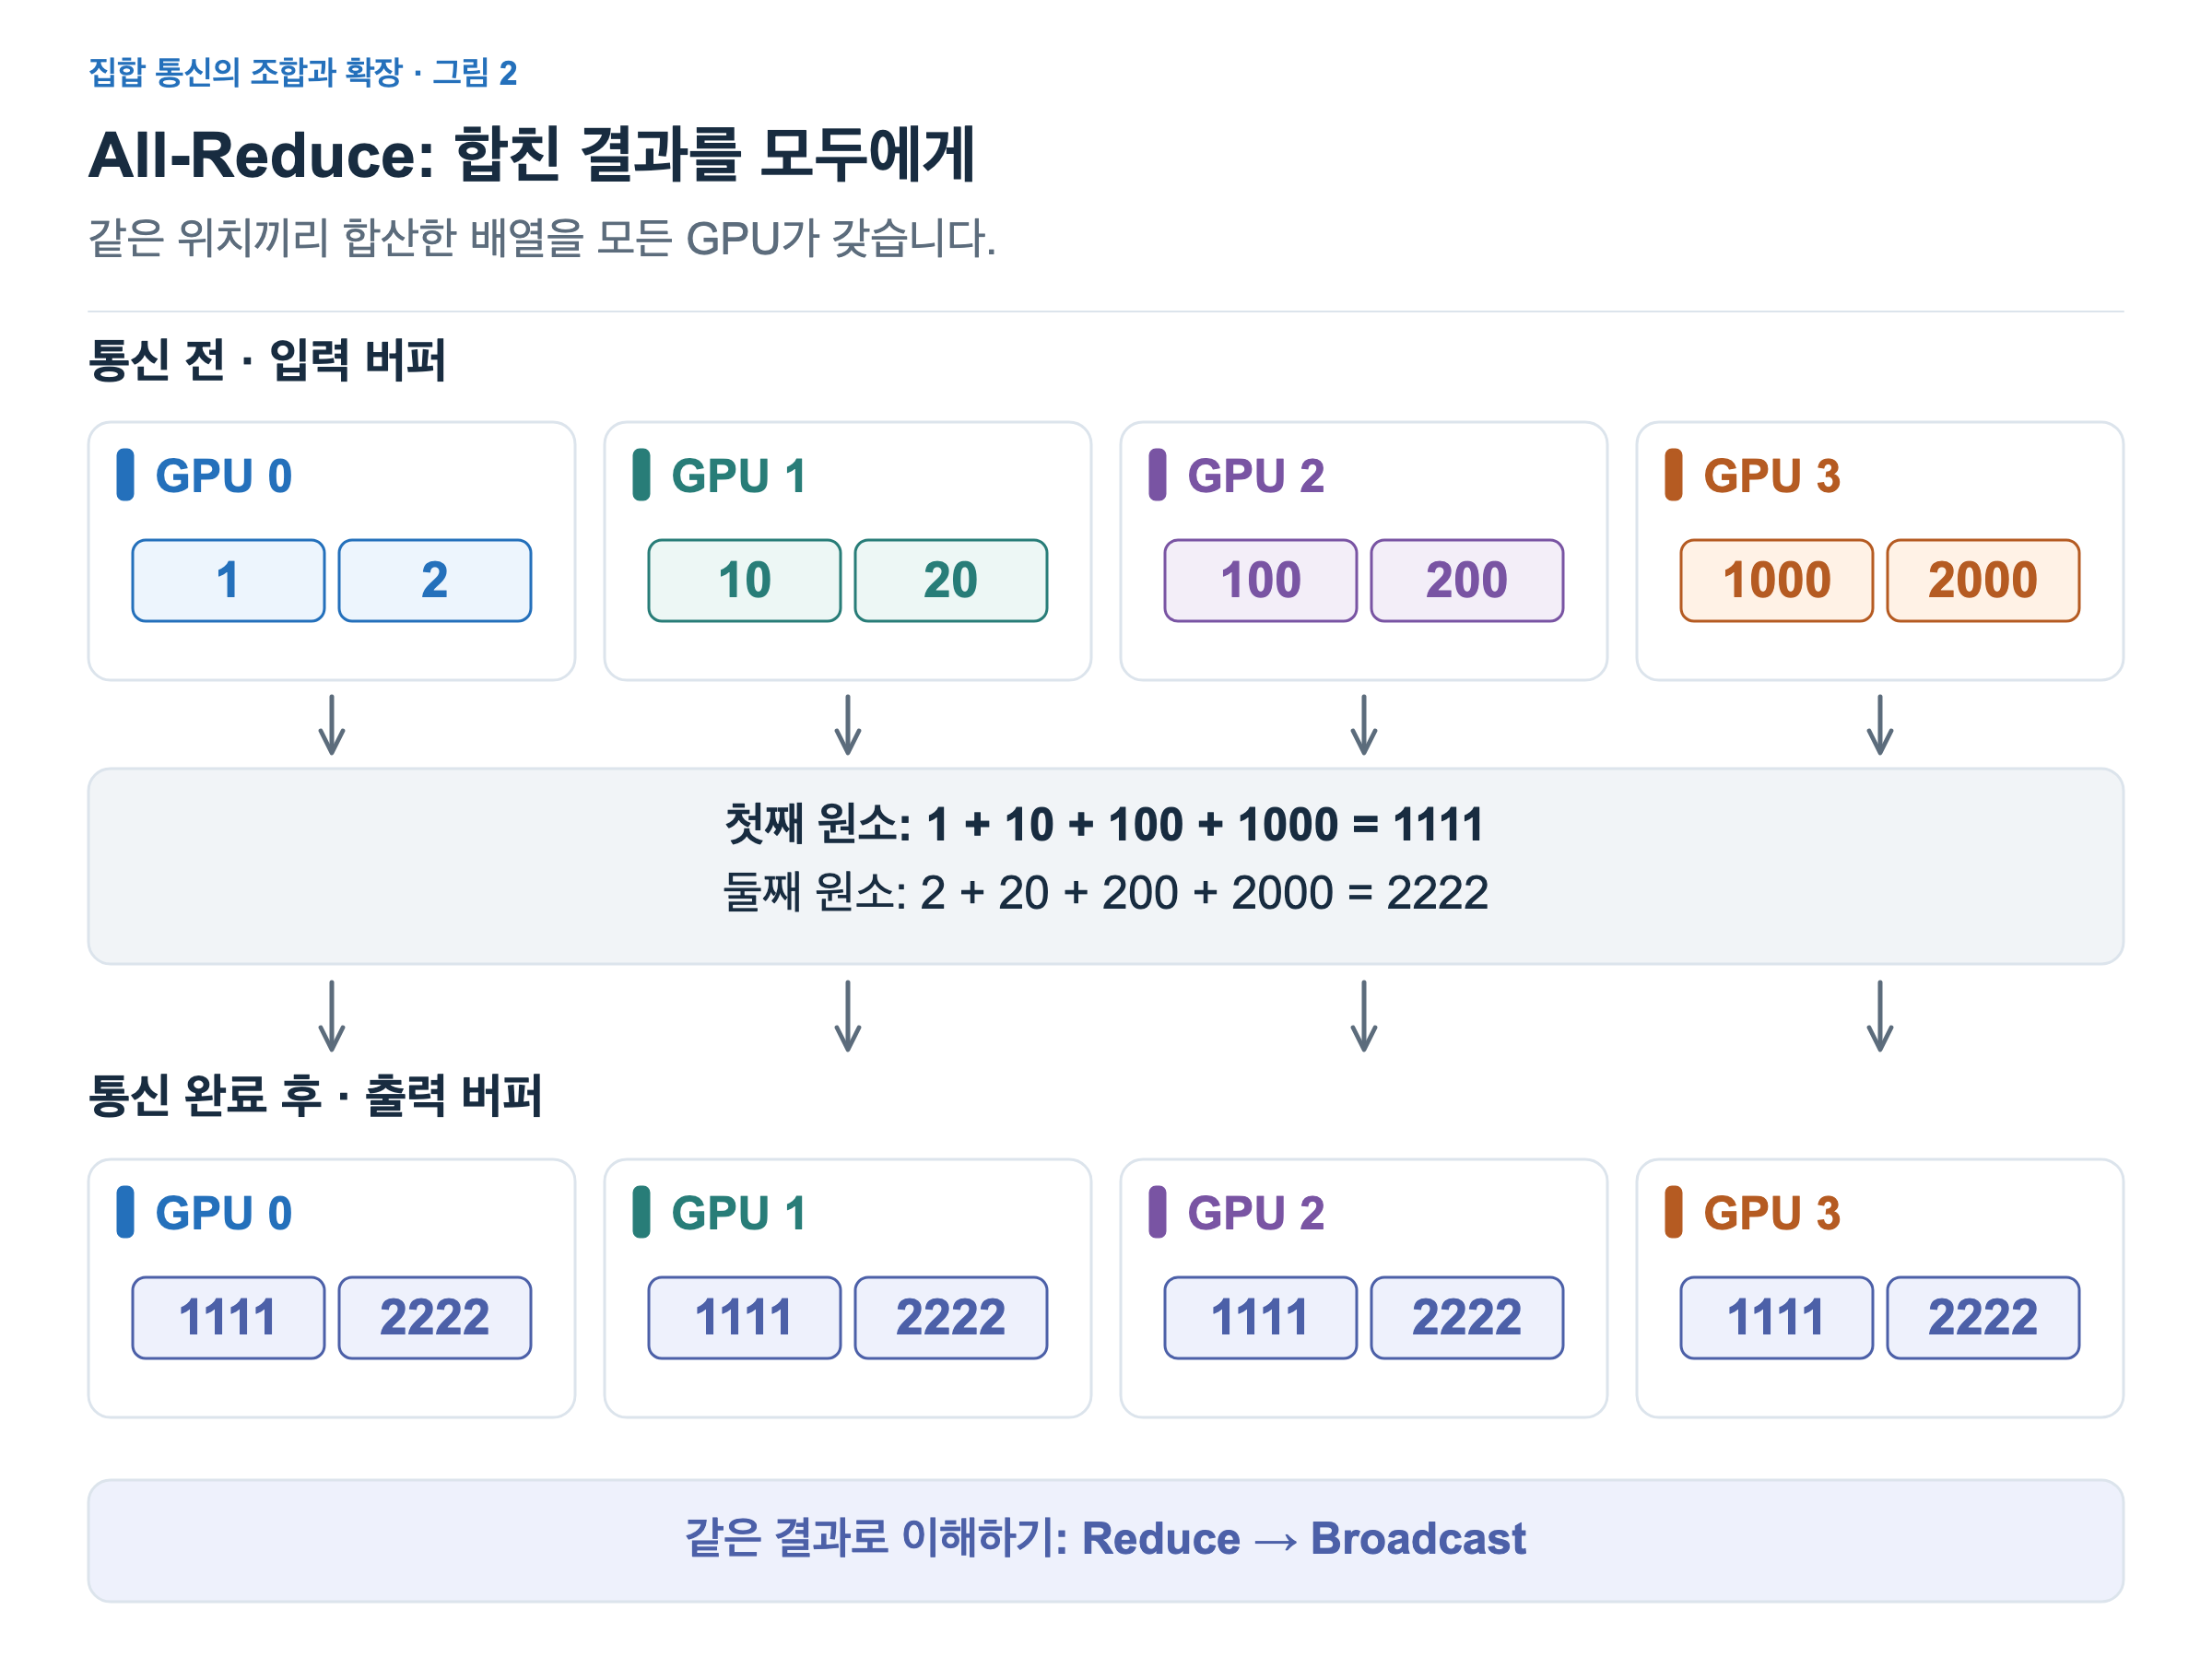
All-Gather와 All-Reduce는 모두 결과를 모든 GPU에 두지만, 결과를 만드는 방법이 다릅니다. All-Gather는 원소를 이어 붙이므로 이 예시의 출력이 여덟 원소입니다. All-Reduce는 같은 위치끼리 합치므로 출력은 두 원소입니다. 각 GPU는 다른 GPU의 개별 입력 대신, 모든 입력이 기여한 합을 갖습니다.
이 동작은 Reduce로 root에 합을 만든 뒤 Broadcast로 그 결과를 복사한 경우와 연결해서 이해할 수 있습니다. 역시 같은 수학적 결과를 설명하는 관계이며, 실제 실행 방법을 지정하는 것은 아닙니다.
All-Reduce의 ‘All’도 합친 결과를 모두가 갖는다는 뜻으로 읽으면 됩니다. 원소를 모두 더해 숫자 하나로 만든다는 뜻이 아닙니다. 배열의 각 위치마다 합친 값을 만들고, 그 배열 전체를 공유합니다. Reduce와 마찬가지로 덧셈 이외의 연산을 사용할 수도 있습니다.
합친 결과를 나누는 Reduce-Scatter
All-Reduce에서는 모든 GPU가 합산 결과 전체를 갖습니다. 그런데 다음 계산을 각 GPU가 분담한다면, 자신이 맡은 부분의 합만 필요할 수 있습니다. Reduce-Scatter는 같은 위치끼리 합친 결과를 조각으로 나눠 각 참여자에게 배분합니다.
네 GPU가 한 원소씩 나눠 갖는 모습을 보기 위해, 이번에는 각 GPU의 입력을 네 원소로 바꿉니다.
GPU 0: [   1,    2,    3,    4]
GPU 1: [  10,   20,   30,   40]
GPU 2: [ 100,  200,  300,  400]
GPU 3: [1000, 2000, 3000, 4000]
같은 위치끼리 더한 전체 값은 [1111, 2222, 3333, 4444]입니다. 이 결과를 rank 순서대로 나누면 GPU 0은 [1111], GPU 1은 [2222], GPU 2는 [3333], GPU 3은 [4444]를 받습니다.
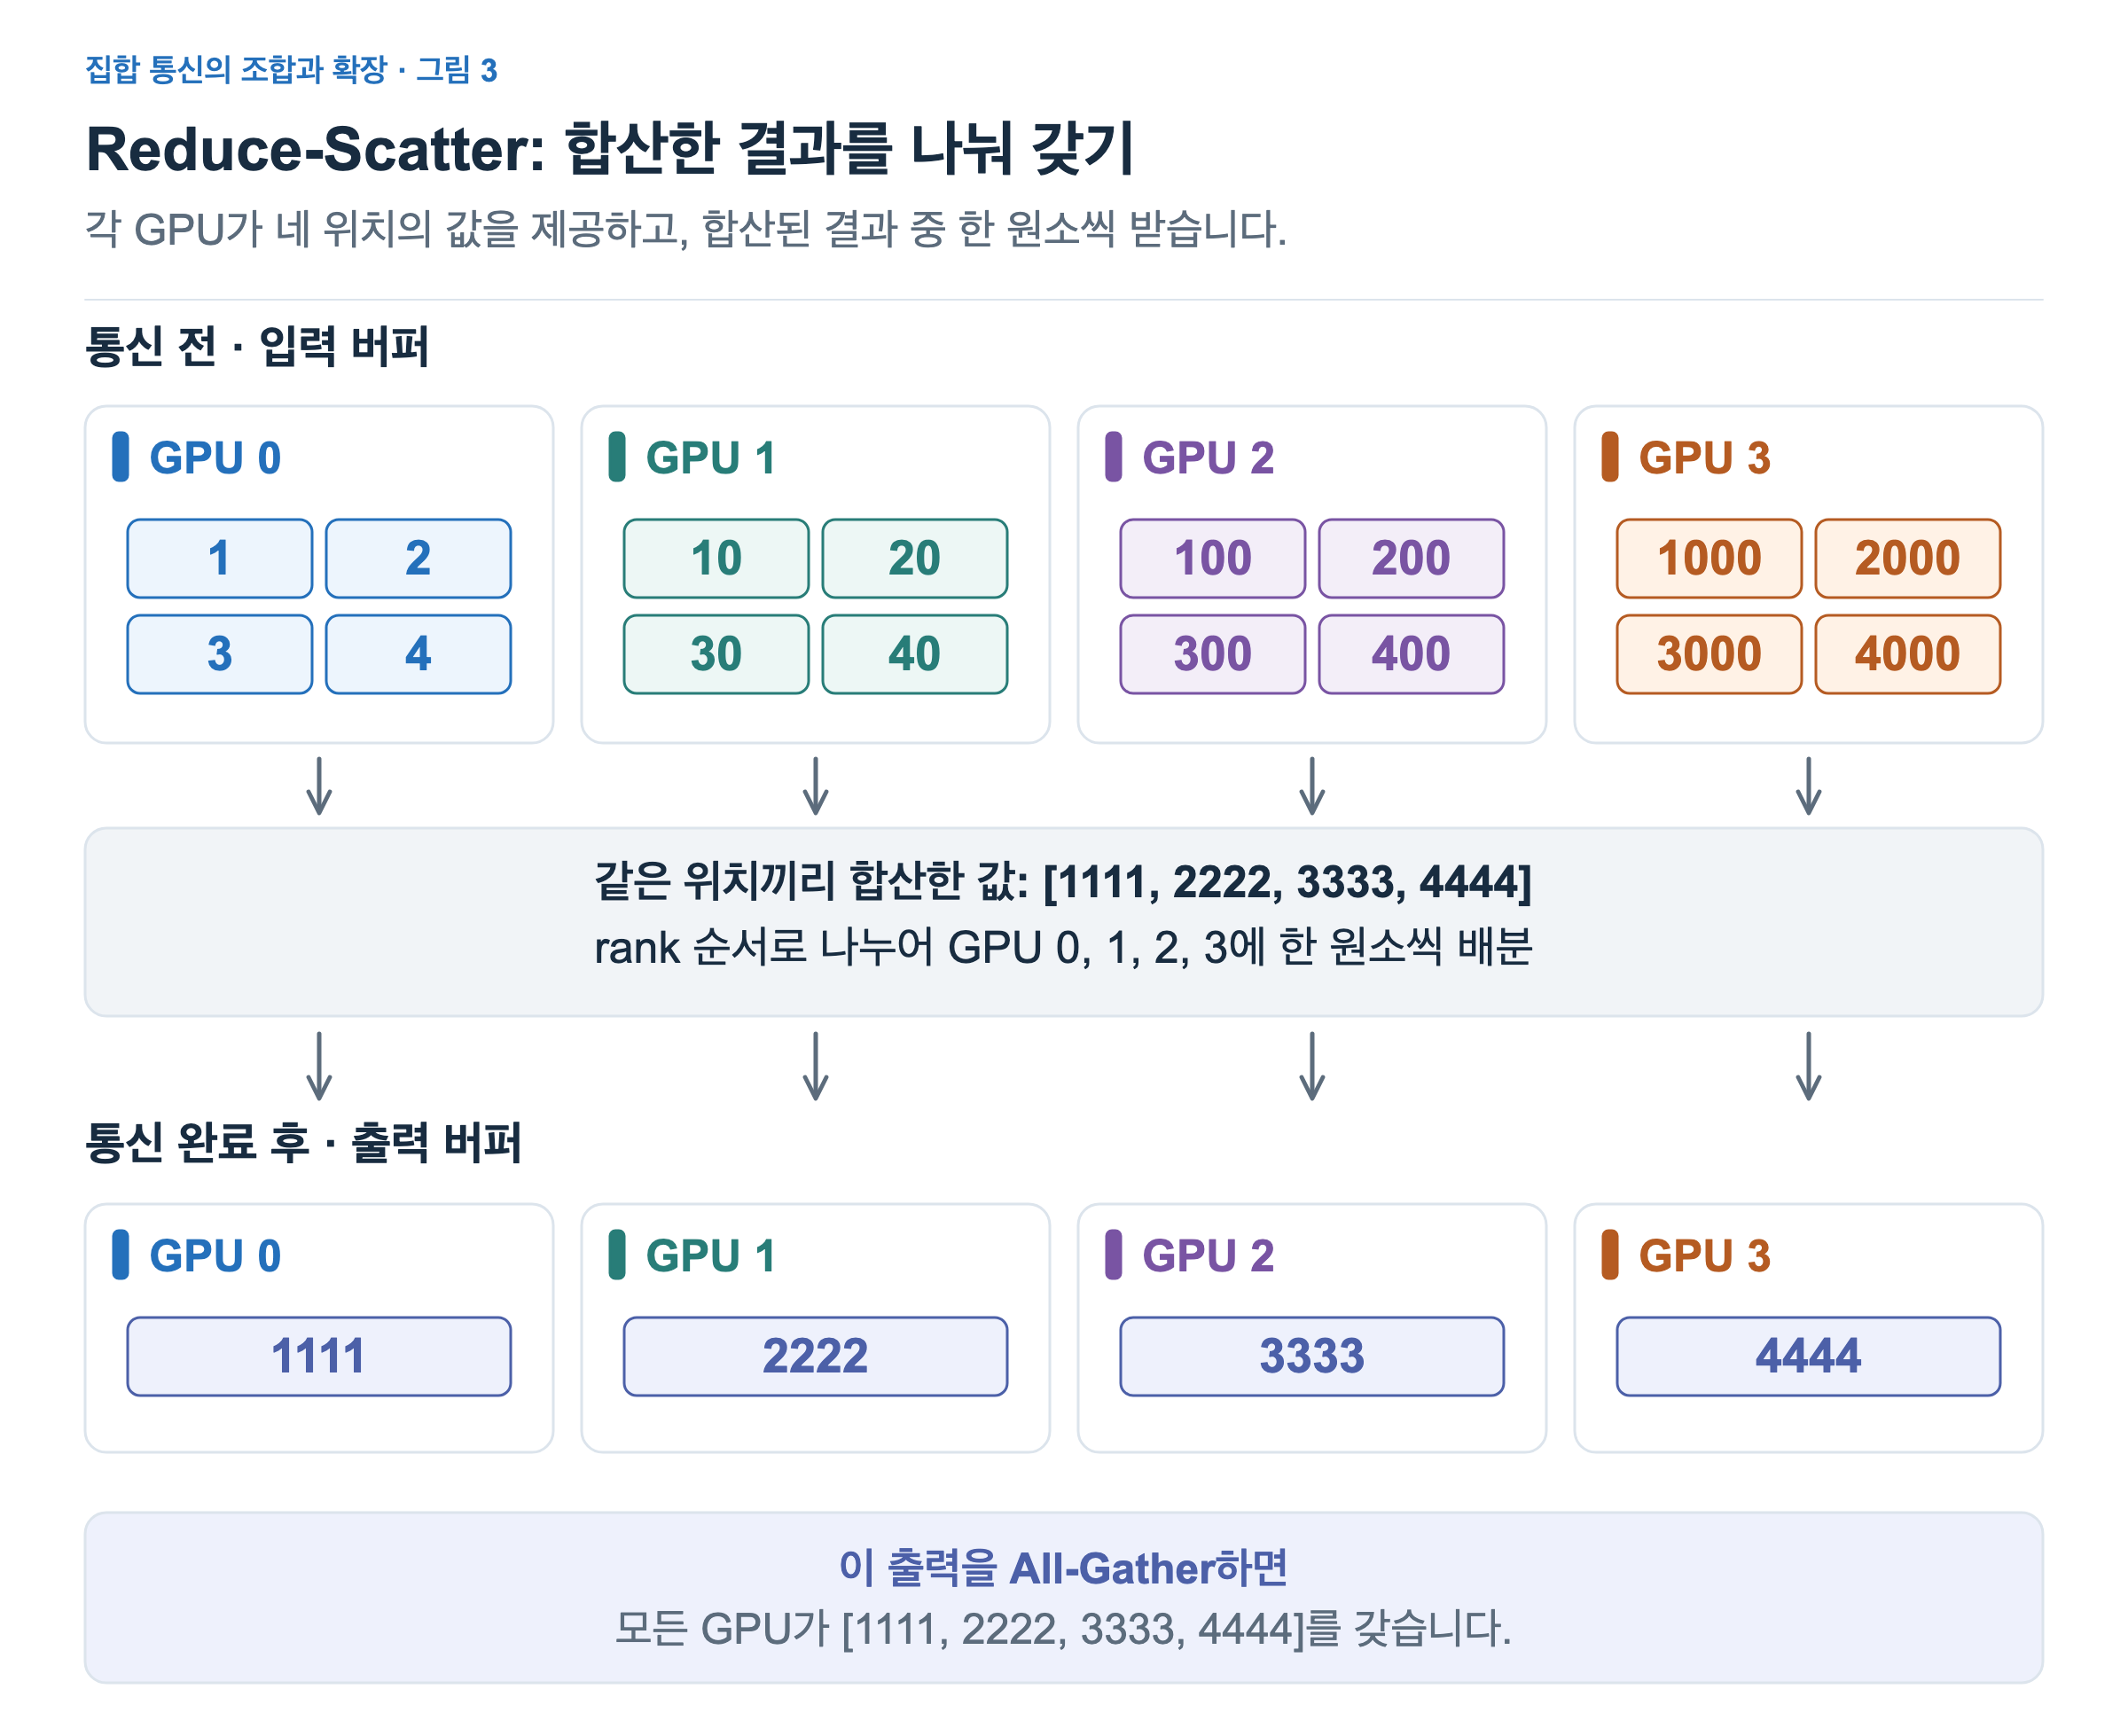
각 GPU가 받는 것은 한 원소지만, 그 원소에는 모든 GPU의 입력이 기여합니다. 예를 들어 GPU 2의 결과 3333은 GPU 2의 입력 300만으로 만든 값이 아닙니다. 네 GPU의 셋째 원소인 3, 30, 300, 3000을 더한 값입니다.
Scatter와 비교해도 차이가 보입니다. Scatter는 root에 이미 있는 배열을 나눠 줍니다. Reduce-Scatter는 여러 GPU의 입력을 위치별로 합치고, 그 합산 결과를 나눠 갖습니다. 이름을 Reduce와 Scatter로 나눠 읽으면 이 관계를 이해하는 데 도움이 됩니다.
그림 가운데의 전체 합은 계산 결과를 설명하기 위한 표현입니다. 실제로 특정 GPU에 전체 합을 먼저 완성한 다음 나눠야 한다는 뜻은 아닙니다. 결과 조각을 받을 GPU를 중심으로 통신과 계산을 진행하는 등 구체적인 수행 방법은 달라질 수 있습니다.
이 출력들을 다시 All-Gather하면 어떻게 될까요? [1111], [2222], [3333], [4444]를 같은 rank 순서로 모으므로 모든 GPU가 [1111, 2222, 3333, 4444]를 갖습니다. 같은 입력을 All-Reduce한 것과 같은 수학적 결과입니다.
Reduce-Scatter → All-Gather
합산 결과를 나눠 갖기 → 나뉜 결과를 모아 모두 갖기
이 관계는 두 동작을 왜 함께 사용하는지 이해하는 출발점이 됩니다. 결과 전체가 필요하면 다시 모을 수 있고, 각자 맡은 조각만으로 다음 계산을 진행할 수 있다면 나눠 가진 상태를 유지할 수도 있습니다. 전체를 모든 GPU에 둘지, 조각으로 나눠 둘지는 다음 계산이 요구하는 데이터에 달려 있습니다.
목적지별로 교환하는 All-to-All
지금까지는 같은 결과 전체를 공유하거나, 하나의 합산 결과를 나눠 갖는 경우를 살펴봤습니다. 이번에는 각 GPU가 다른 GPU마다 보낼 서로 다른 조각을 갖고 있는 상황을 생각해보겠습니다. 이 조각들을 목적지에 맞게 교환하는 동작이 All-to-All입니다.
그림의 각 칸은 데이터 조각 하나입니다. 칸 안의 0 → 2는 숫자 0과 2를 계산한다는 뜻이 아니라, GPU 0이 준비했고 GPU 2로 보낼 조각이라는 표식입니다. 여기서는 모든 조각의 크기가 같다고 가정합니다.
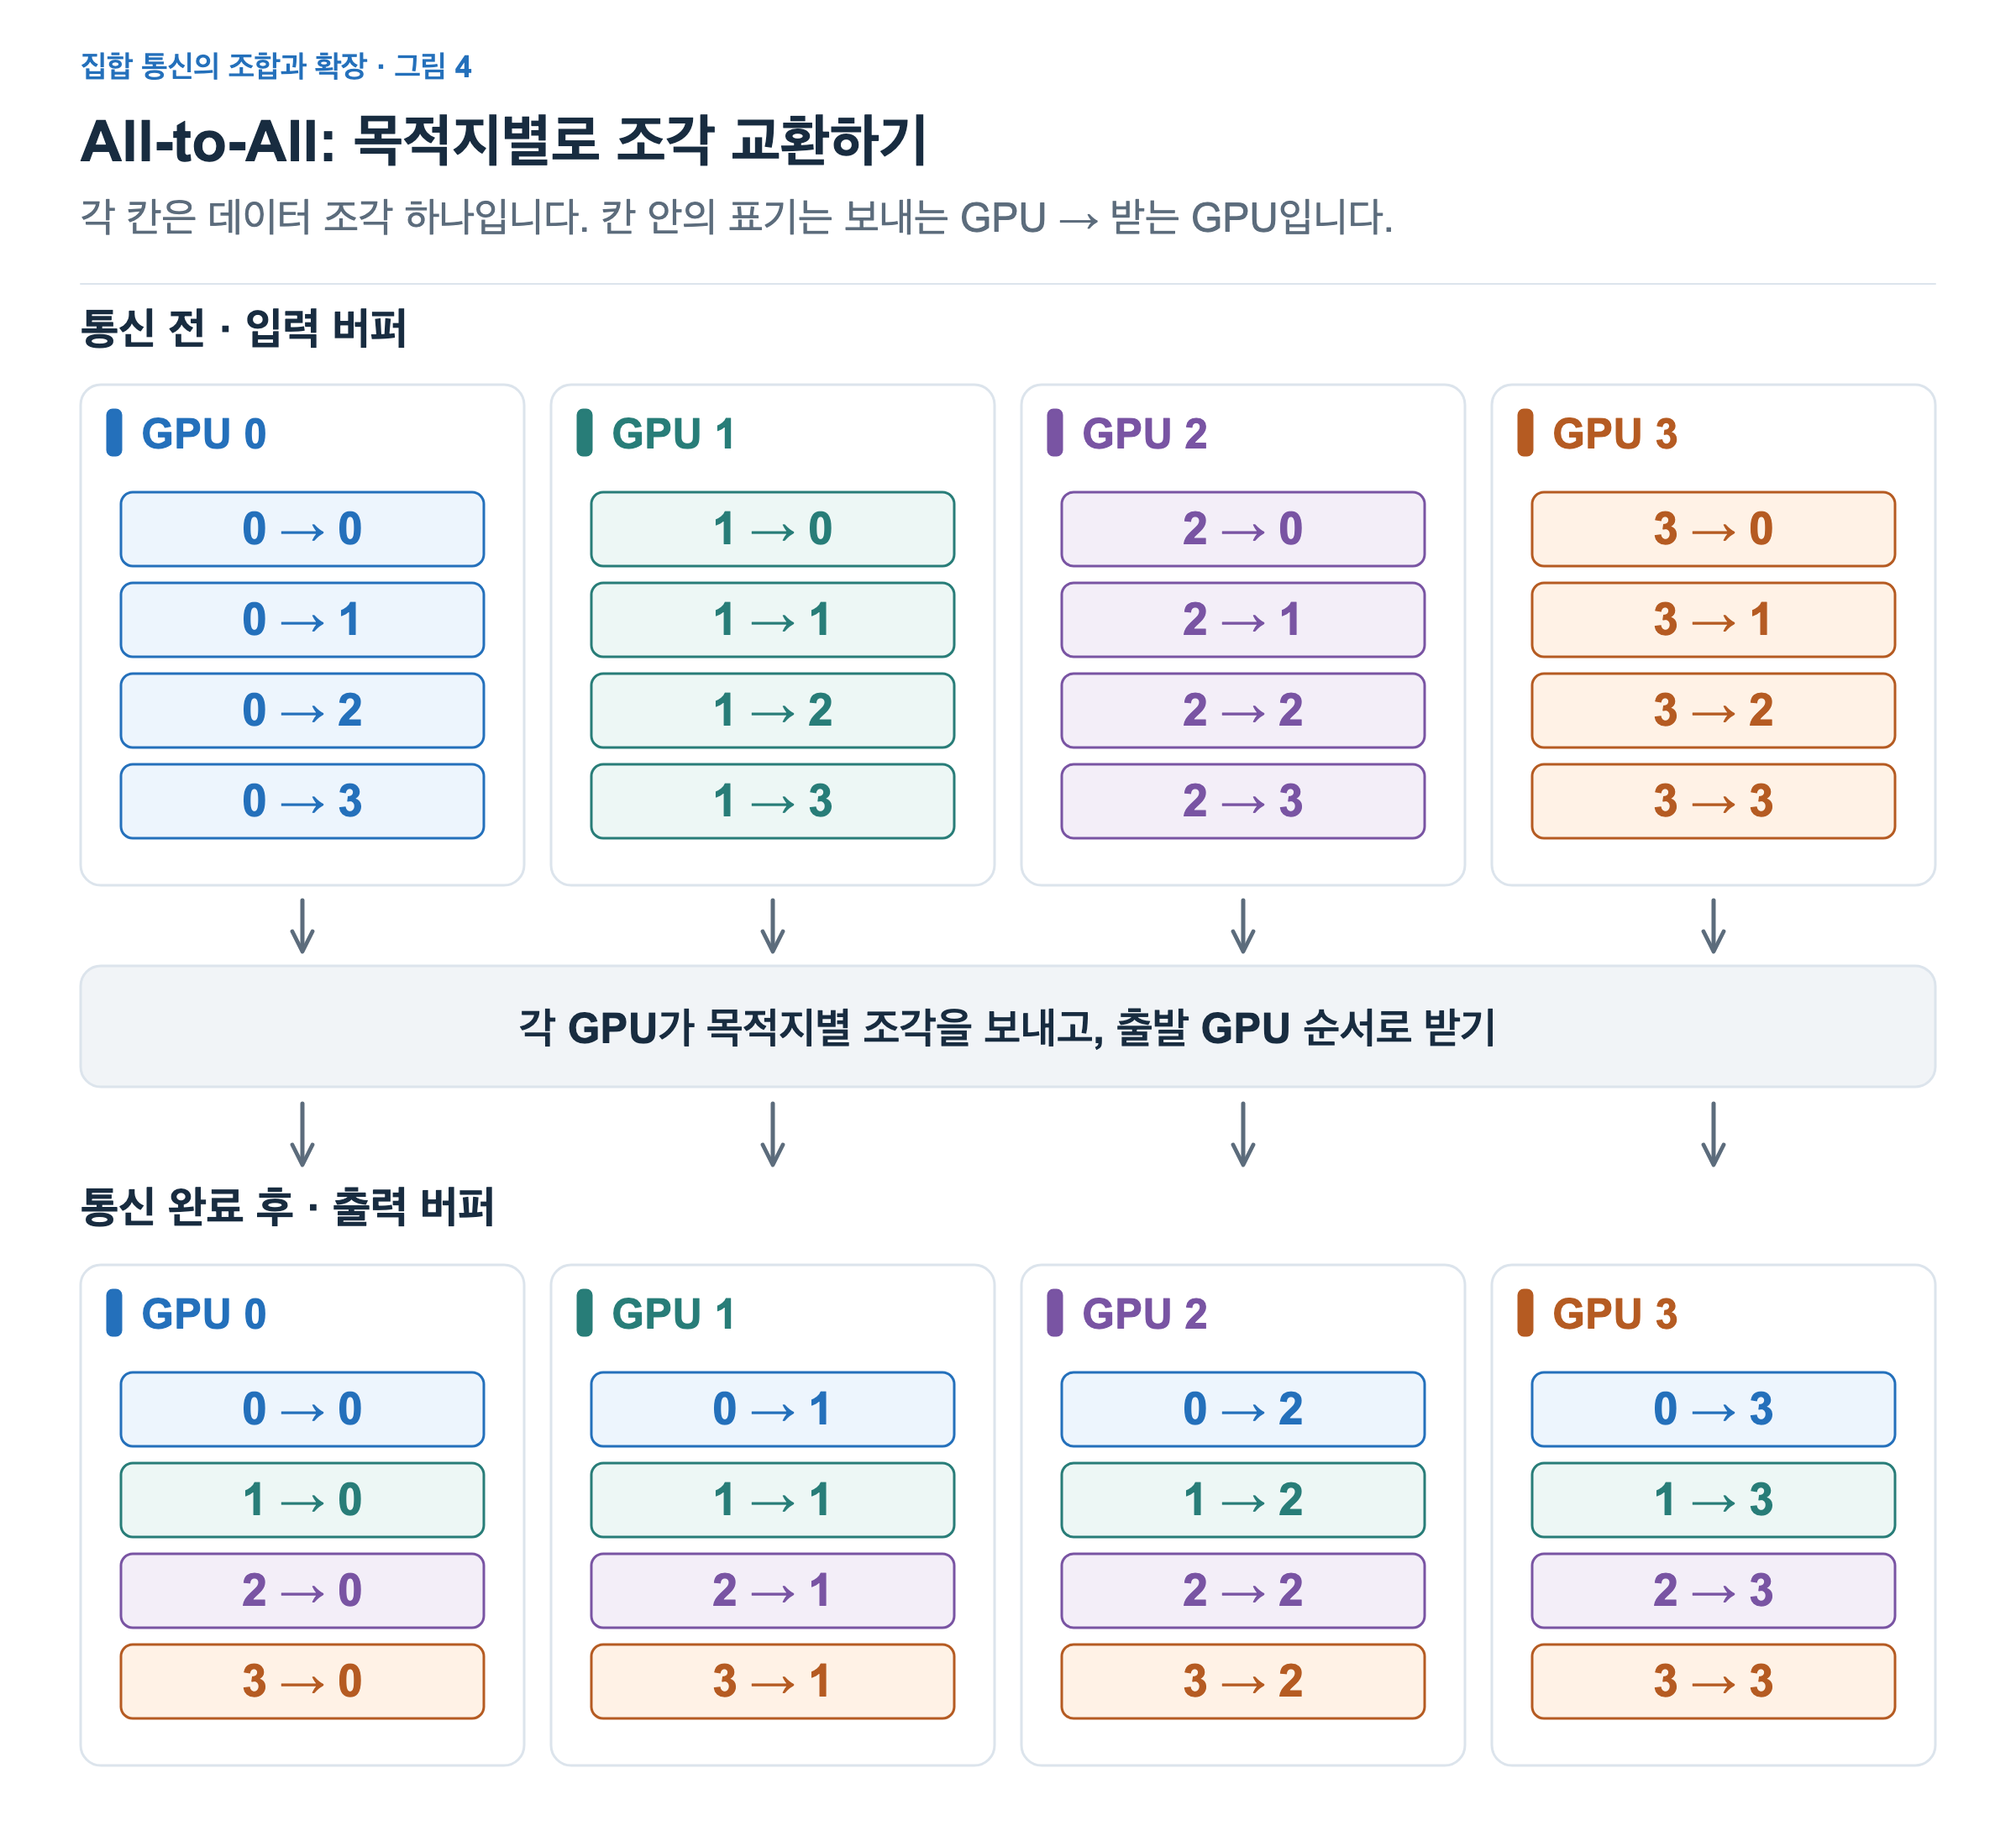
입력 쪽에서 GPU 0은 0 → 0, 0 → 1, 0 → 2, 0 → 3을 갖습니다. 다른 GPU도 목적지 0, 1, 2, 3에 해당하는 조각을 하나씩 갖고 있습니다.
출력 쪽에서는 GPU 2를 따라가 보겠습니다. GPU 2는 0 → 2, 1 → 2, 2 → 2, 3 → 2를 갖습니다. 각각 GPU 0, 1, 2, 3이 GPU 2를 위해 준비한 조각입니다. 출발 GPU 순서대로 결과에 배치되며, GPU 2 자신에게 배정된 조각도 포함됩니다. 자기 몫의 조각까지 반드시 다른 GPU와의 연결을 지나야 하는 것은 아닙니다.
All-Gather와 비교하면 차이가 분명해집니다. All-Gather에서는 각 GPU의 입력 전체가 모든 GPU에 복제되므로, 모두 같은 전체 배열을 갖습니다. All-to-All에서는 각 입력의 조각이 지정된 목적지로 가므로, GPU마다 받는 내용이 다릅니다. 각 GPU가 모든 상대와 교환하지만, 모든 입력을 전부 받는 것은 아닙니다.
이 그림에서는 GPU마다 입력이 네 조각이고 출력도 네 조각입니다. 원래는 ‘한 GPU가 여러 목적지에 보낼 조각’끼리 모여 있었다면, 완료 후에는 ‘여러 GPU가 한 목적지에 보낸 조각’끼리 모입니다. 각 조각의 값에 덧셈을 하지는 않습니다.
이러한 교환도 목적지별 Send와 출발지별 Recv를 조합해 구성할 수 있습니다. 집합 통신으로 표현하면 그룹 전체가 수행할 교환 규칙이 드러납니다. NCCL의 Send/Recv 조합 예시
네 동작을 선택할 때 확인할 것은 다음 계산이 필요로 하는 결과입니다.
| 다음 계산에 필요한 데이터 | 집합 통신 |
|---|---|
| 각 GPU의 조각을 이어 붙인 전체 배열 | All-Gather |
| 같은 위치끼리 합친 결과 전체 | All-Reduce |
| 같은 위치끼리 합친 결과 중 각자 맡은 조각 | Reduce-Scatter |
| 각 GPU가 내 목적지에 맞춰 보낸 조각들 | All-to-All |
여기까지는 입력과 출력의 관계를 살펴봤습니다. 같은 결과를 만들더라도 데이터를 누구에게 먼저 보내고, 어떤 순서로 전달하며, 어디에서 합칠지는 여러 방식으로 정할 수 있습니다. Ring과 Tree를 통해 집합 통신의 결과를 실제 전달 과정으로 만드는 방법을 살펴보겠습니다.