공통 · 2026-09-17
GPU 사이에서 데이터를 전달하기
통신 참여자와 버퍼를 준비하고, CPU의 송수신 등록과 GPU 실행을 연결하며, 독립 계산의 동시 진행과 안전한 버퍼 재사용을 설명합니다.
지난 글에서는 여러 GPU를 사용해 더 큰 모델을 담거나, 처리 시간을 줄이거나, 처리량을 늘릴 수 있다는 점을 살펴봤습니다. 계산을 여러 GPU에 나누면 한 GPU가 만든 결과를 다른 GPU가 받아야 하는 순간이 생깁니다. 이때 데이터를 어디에 준비하고, 누가 전달을 요청하며, 받는 쪽의 계산은 언제 시작할 수 있을까요?
이번 글에서는 한 GPU가 만든 값을 다른 GPU가 받아 다음 계산에 사용하는 과정을 따라가겠습니다. 먼저 통신할 참여자와 데이터를 담을 공간을 준비합니다. 이어서 계산과 송수신을 등록하고, 두 GPU의 실행 순서가 어떻게 이어지는지 살펴봅니다. 마지막으로 통신 중에 독립적인 계산을 진행하는 방법과, 사용한 공간에 다음 값을 써도 되는 시점을 알아보겠습니다.
예시는 간단합니다. GPU 0의 계산 A가 x = [1, 2, 3, 4]를 만들고, GPU 1의 계산 B는 전달받은 x의 각 원소를 두 배로 만들어 y = [2, 4, 6, 8]을 얻습니다. 이번 글에서 A는 전달할 값을 만드는 계산, B는 그 값을 사용하는 계산입니다.
5편에서 배운 실행 방식을 잠깐 떠올려보겠습니다. CPU 코드는 GPU 작업을 요청하고, GPU는 등록된 작업을 실행합니다. 같은 스트림에 등록한 작업은 순서대로 진행되며, CPU의 호출이 끝나는 시점과 GPU의 작업이 끝나는 시점은 다릅니다. 이번에는 그 실행 흐름을 두 GPU에 걸쳐 연결합니다.
통신에 참여할 GPU 정하기
그림에서는 한 서버, 즉 한 컴퓨터에 GPU 0과 GPU 1이 있다고 가정합니다. 이 컴퓨터에서 프로그램을 두 개 실행해, 각각 GPU 하나를 맡기겠습니다. 프로세스는 이렇게 실행 중인 프로그램의 단위입니다. 같은 프로그램을 두 번 실행하더라도 각 실행은 별도의 프로세스가 될 수 있습니다.
프로세스 0의 CPU 코드는 GPU 0에 작업을 요청하고, 프로세스 1의 CPU 코드는 GPU 1에 작업을 요청합니다. 프로세스가 두 개라는 말이 물리적인 CPU도 두 개라는 뜻은 아닙니다. 두 프로세스의 CPU 코드가 같은 CPU의 코어들에서 실행될 수도 있습니다.
GPU 통신에는 NVIDIA의 통신 라이브러리인 NCCL을 사용하겠습니다. 이번 예시는 CPU 쪽에서 송신과 수신 함수를 호출하는 방식입니다. 프로그램이 NCCL에 통신을 요청하면, 라이브러리가 그 요청을 수행하는 데 필요한 작업을 구성합니다.
먼저 두 GPU를 같은 통신 그룹의 참여자로 설정합니다. 통신 그룹은 함께 통신할 참여자를 묶은 것입니다. 그룹 안에서는 각 참여 GPU에 rank라는 번호를 부여합니다. 이번에는 GPU 0을 rank 0, GPU 1을 rank 1로 정하겠습니다. GPU 번호는 어떤 장치인지, rank는 해당 통신 그룹에서 누구인지를 가리킵니다. 여기서는 두 번호를 같게 정했지만 항상 같아야 하는 것은 아닙니다.
두 프로세스가 서로 다른 소스 코드 파일을 실행해야 하는 것은 아닙니다. 같은 프로그램을 두 번 실행하고, 각 실행에 주어진 번호에 따라 한쪽은 송신 역할을, 다른 쪽은 수신 역할을 맡도록 작성할 수 있습니다. 프로세스는 프로그램의 실행 단위이고, rank는 통신 그룹 안에서 참여자를 구별하는 번호입니다. 어떤 계산과 데이터를 맡길지는 프로그램이나 프레임워크의 분할 규칙으로 정합니다.
각 프로세스는 자신이 사용할 통신 객체인 communicator를 준비합니다. 그림의 comm₀와 comm₁이 이에 해당합니다. 각각 담당 GPU와 rank에 연결되어 있으며, 같은 그룹에서 통신하는 데 사용됩니다. 서로 같은 그룹이라는 것을 맞추기 위해 초기화 과정에서는 두 프로세스가 공통 식별자를 공유합니다. 이후 송수신할 때 이 통신 객체와 상대 rank를 지정합니다. NCCL 통신 그룹과 communicator 준비
이렇게 누가 어떤 GPU를 맡고, 어느 그룹의 누구와 통신할지 정하는 것이 통신 환경 준비의 출발점입니다. 이번에는 두 프로세스가 GPU 하나씩 맡지만, 하나의 프로세스가 여러 GPU를 담당할 수도 있고 통신 그룹이 여러 서버에 걸칠 수도 있습니다.
데이터를 담을 송수신 버퍼 준비하기
상대를 정했다면 데이터를 담을 공간이 필요합니다. 데이터를 읽고 쓰는 메모리 공간을 버퍼라고 합니다. GPU 0에는 보낼 x를 담는 송신 버퍼를, GPU 1에는 받은 x를 담는 수신 버퍼를 마련합니다. GPU 1에는 계산 B의 결과 y를 저장할 별도 공간도 필요합니다.
이 공간을 확보하는 요청은 각 프로세스의 CPU 코드에서 합니다. 확보된 공간은 GPU 메모리에 있으며, GPU 0의 계산 A가 송신 버퍼에 [1, 2, 3, 4]를 써넣습니다. CPU가 메모리 확보를 요청했다고 해서 이 값도 CPU에서 만들어야 하는 것은 아닙니다.
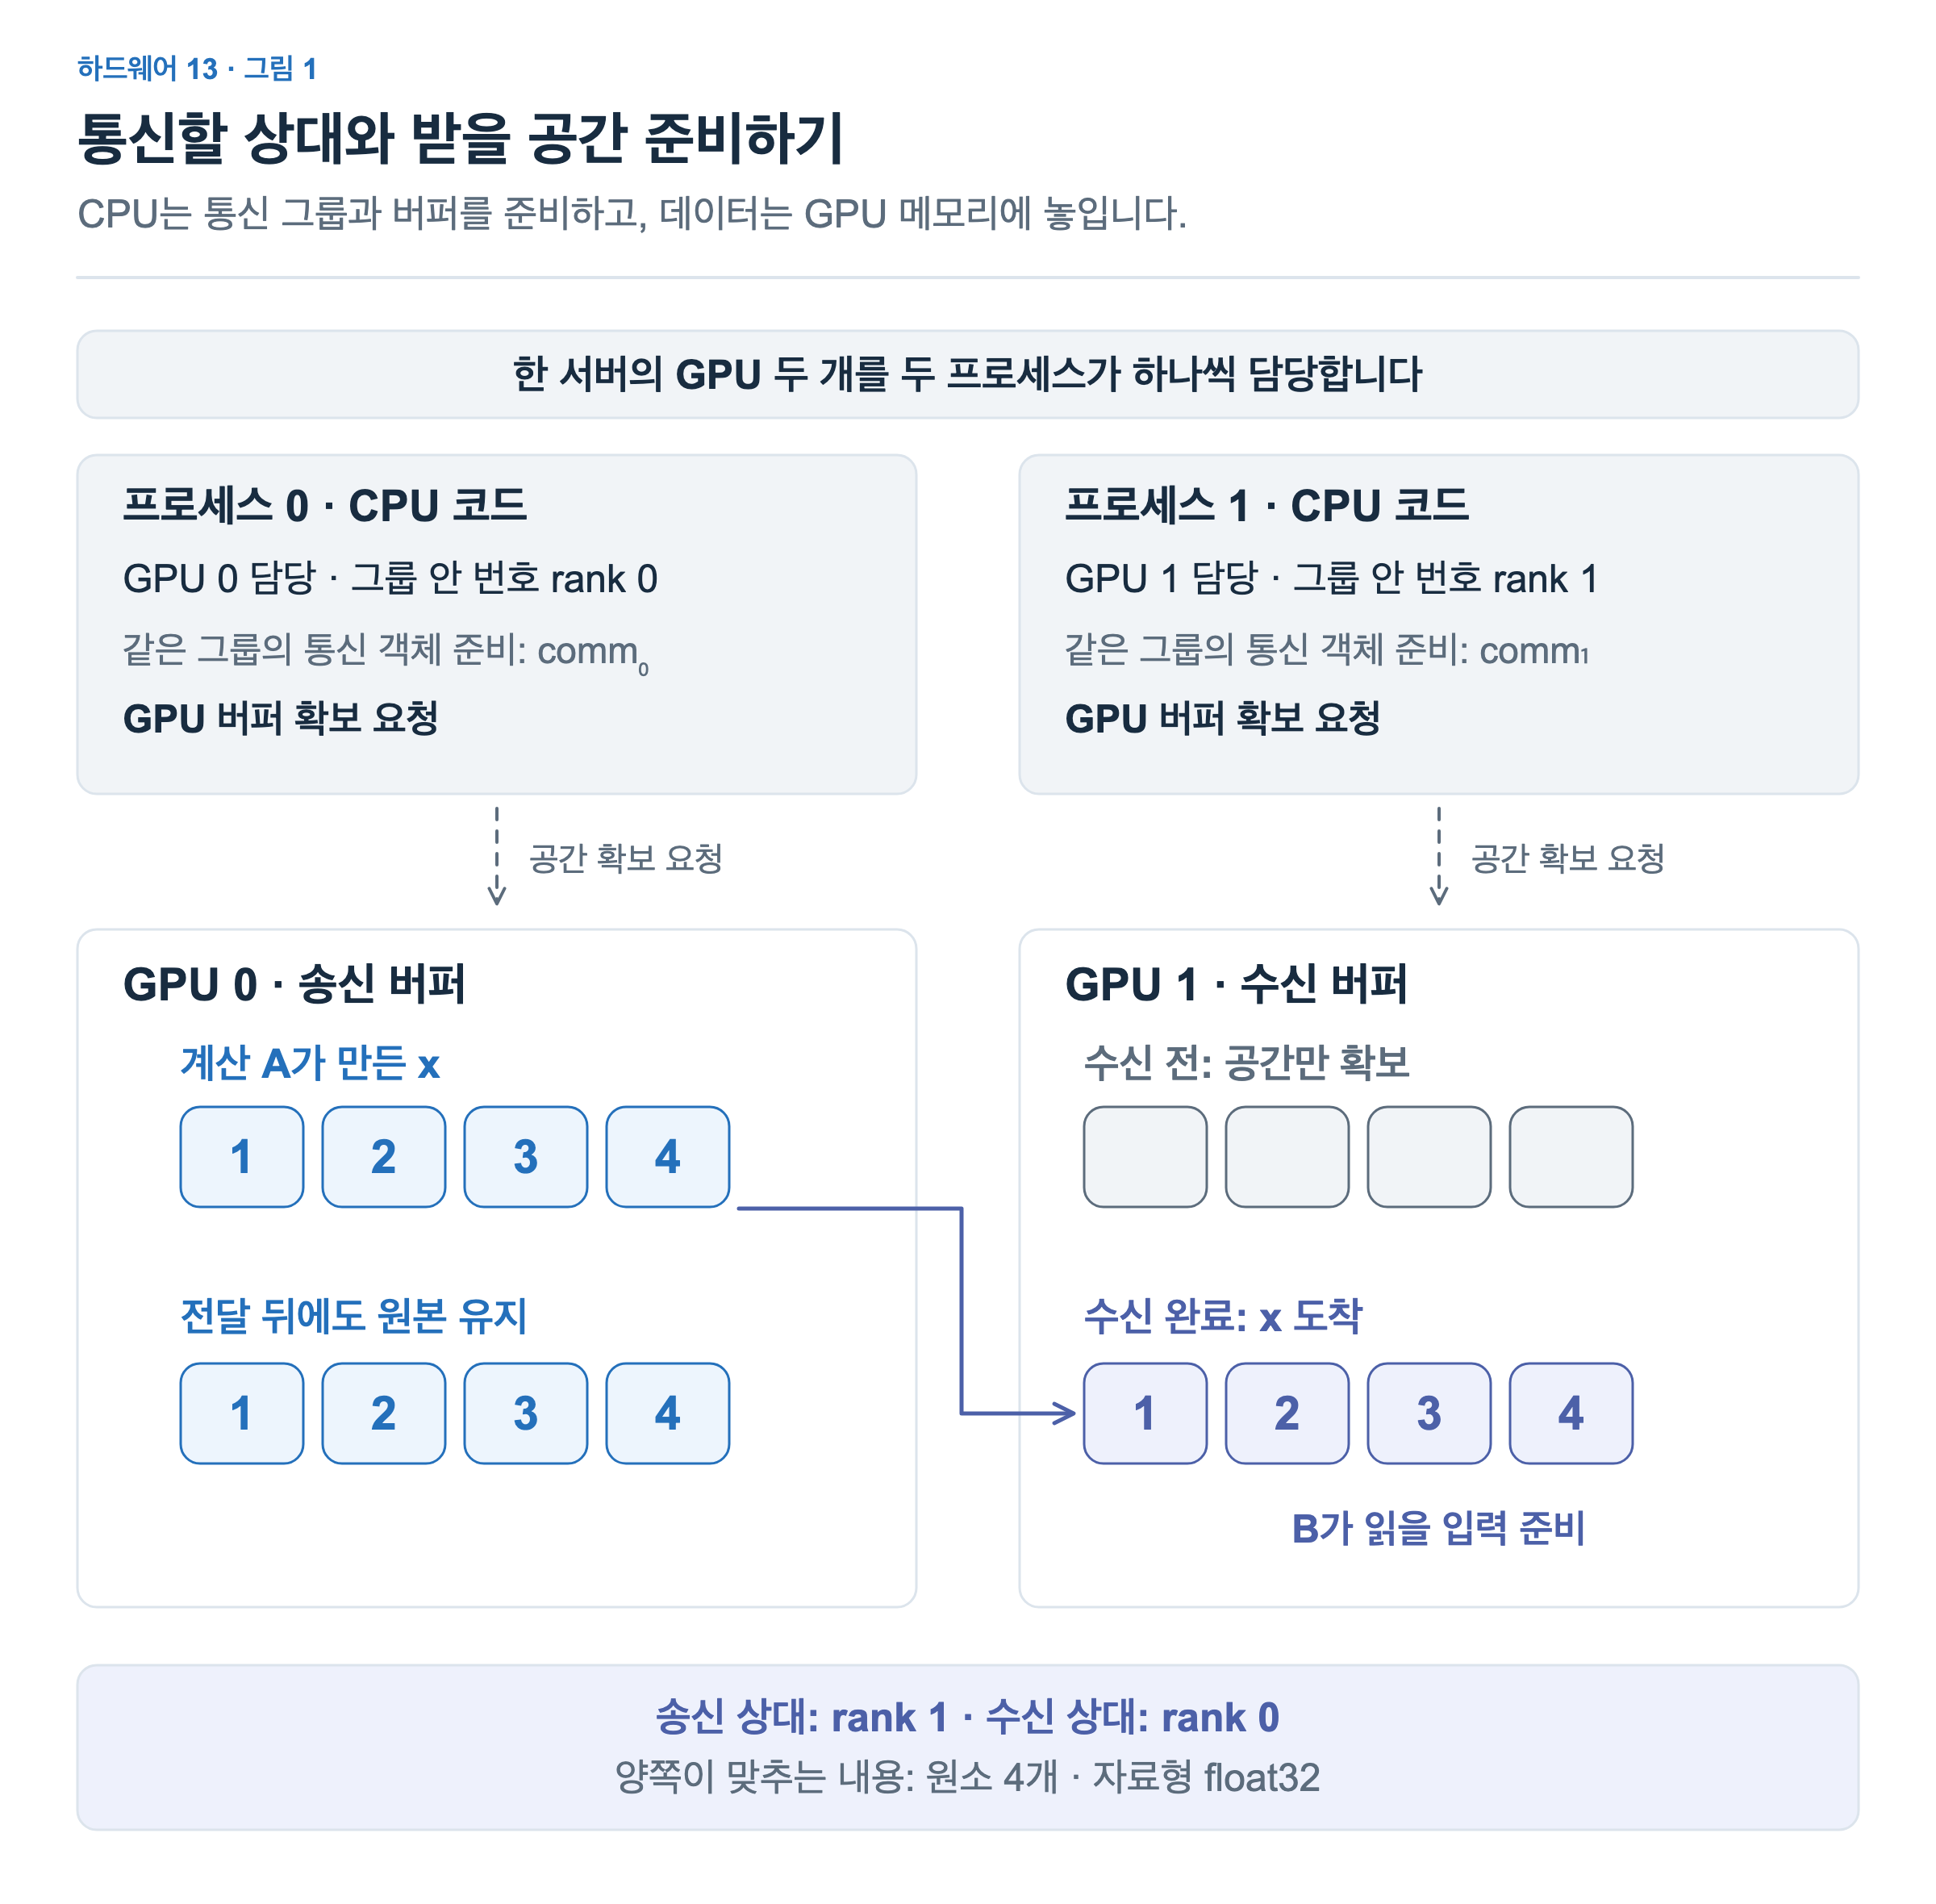
그림 1에서 GPU 1의 빈 칸은 수신할 공간만 준비된 상태입니다. 아직 GPU 0의 x가 도착한 것은 아닙니다. 수신이 끝나면 이곳에 [1, 2, 3, 4]가 들어 있고, B가 입력으로 사용할 수 있습니다. 이 전달은 GPU 0의 원본을 없애지 않습니다. 송신 뒤에는 두 GPU의 버퍼에 같은 값이 들어 있습니다.
송수신 양쪽은 상대와 전달할 데이터의 크기·자료형을 맞춰야 합니다. GPU 0은 rank 1로 원소 네 개를 보내고, GPU 1은 rank 0에서 원소 네 개를 받도록 요청합니다. 자료형은 양쪽 모두 32비트 실수인 float32로 정하겠습니다. NCCL의 원소 수 count는 바이트 수가 아니므로, 이 예시의 count는 4이고 데이터 크기는 16바이트입니다. NCCL 송신·수신 함수
CPU에서 계산과 송수신 등록하기
이제 두 프로세스가 각자의 GPU에 작업을 등록합니다. GPU 0에는 계산 A → 송신, GPU 1에는 수신 → 계산 B를 같은 스트림 안에 차례로 놓겠습니다. 여기서 GPU 0의 스트림 S₀와 GPU 1의 스트림 S₁은 서로 다른 GPU에 속한 별개의 실행 흐름입니다.
NCCL에서 송신을 요청하는 함수는 ncclSend, 수신을 요청하는 함수는 ncclRecv입니다. 이 예시에서는 두 함수 모두 GPU 커널 안이 아닌 CPU 쪽 코드에서 호출합니다. 함수에 자신이 준비한 버퍼와 통신 객체, 상대 rank, 사용할 스트림 등을 전달합니다.
아래 코드는 등록 순서만 보이도록 세부 내용을 생략했습니다. CUDA나 NCCL 문법을 해석할 필요는 없습니다. 주석을 따라 어느 GPU에 무엇을 먼저 요청하는지 보면 충분합니다. ...은 인자를 생략한 표시이며, 그대로 실행하는 완성된 프로그램은 아닙니다. 각 프로세스의 GPU 선택, 통신 객체·버퍼·스트림 준비는 이미 끝났다고 가정합니다.
// 프로세스 0의 CPU 코드 — GPU 0의 스트림 S₀ 사용

// 1. A를 등록합니다: 송신 버퍼에 x를 만듭니다.
A<<<...>>>(...);

// 2. 같은 스트림에 송신을 등록합니다.
//    A가 만든 x를 rank 1로 보냅니다.
ncclSend(...);
// 프로세스 1의 CPU 코드 — GPU 1의 스트림 S₁ 사용
// 1. rank 0에서 x를 받을 수신 작업을 등록합니다.
ncclRecv(...);
// 2. 같은 스트림에 B를 등록합니다.
// 수신한 x를 읽고, 두 배의 값을 결과 버퍼 y에 씁니다.
B<<<...>>>(...);이 두 코드는 각각의 프로세스에서 실행됩니다. 프로세스 0의 코드를 전부 실행한 뒤 프로세스 1의 코드를 실행한다는 뜻은 아닙니다. 두 프로세스가 같은 시각에 송수신 함수를 호출해야 하는 것도 아닙니다. 다만 보내는 요청과 그에 대응하는 받는 요청이 모두 필요합니다. 한쪽의 요청만으로 이 송수신이 완료되지는 않습니다. NCCL의 양쪽 참여 방식 송수신
CPU는 이런 호출을 통해 작업을 등록합니다. 실제 데이터 전달과 GPU 계산은 등록된 작업이 실행되면서 진행됩니다. 따라서 ncclRecv 호출에서 다음 줄로 돌아왔다고 해서 받은 x를 이미 사용할 수 있다고 판단하면 안 됩니다. 통신 호출은 내부 준비에 시간이 들 수도 있지만, 호출의 반환 자체가 GPU 통신 완료를 보장하지는 않습니다. NCCL과 CUDA 스트림
송수신으로 두 GPU의 실행 연결하기
그렇다면 CPU가 수신 완료를 직접 확인하지 않고 B까지 등록해도 괜찮을까요? B를 수신과 같은 스트림에 그 뒤로 등록했다면, B는 앞선 수신 작업이 끝난 뒤에 실행됩니다. 이 관계를 그림 2의 시간축에서 보겠습니다.
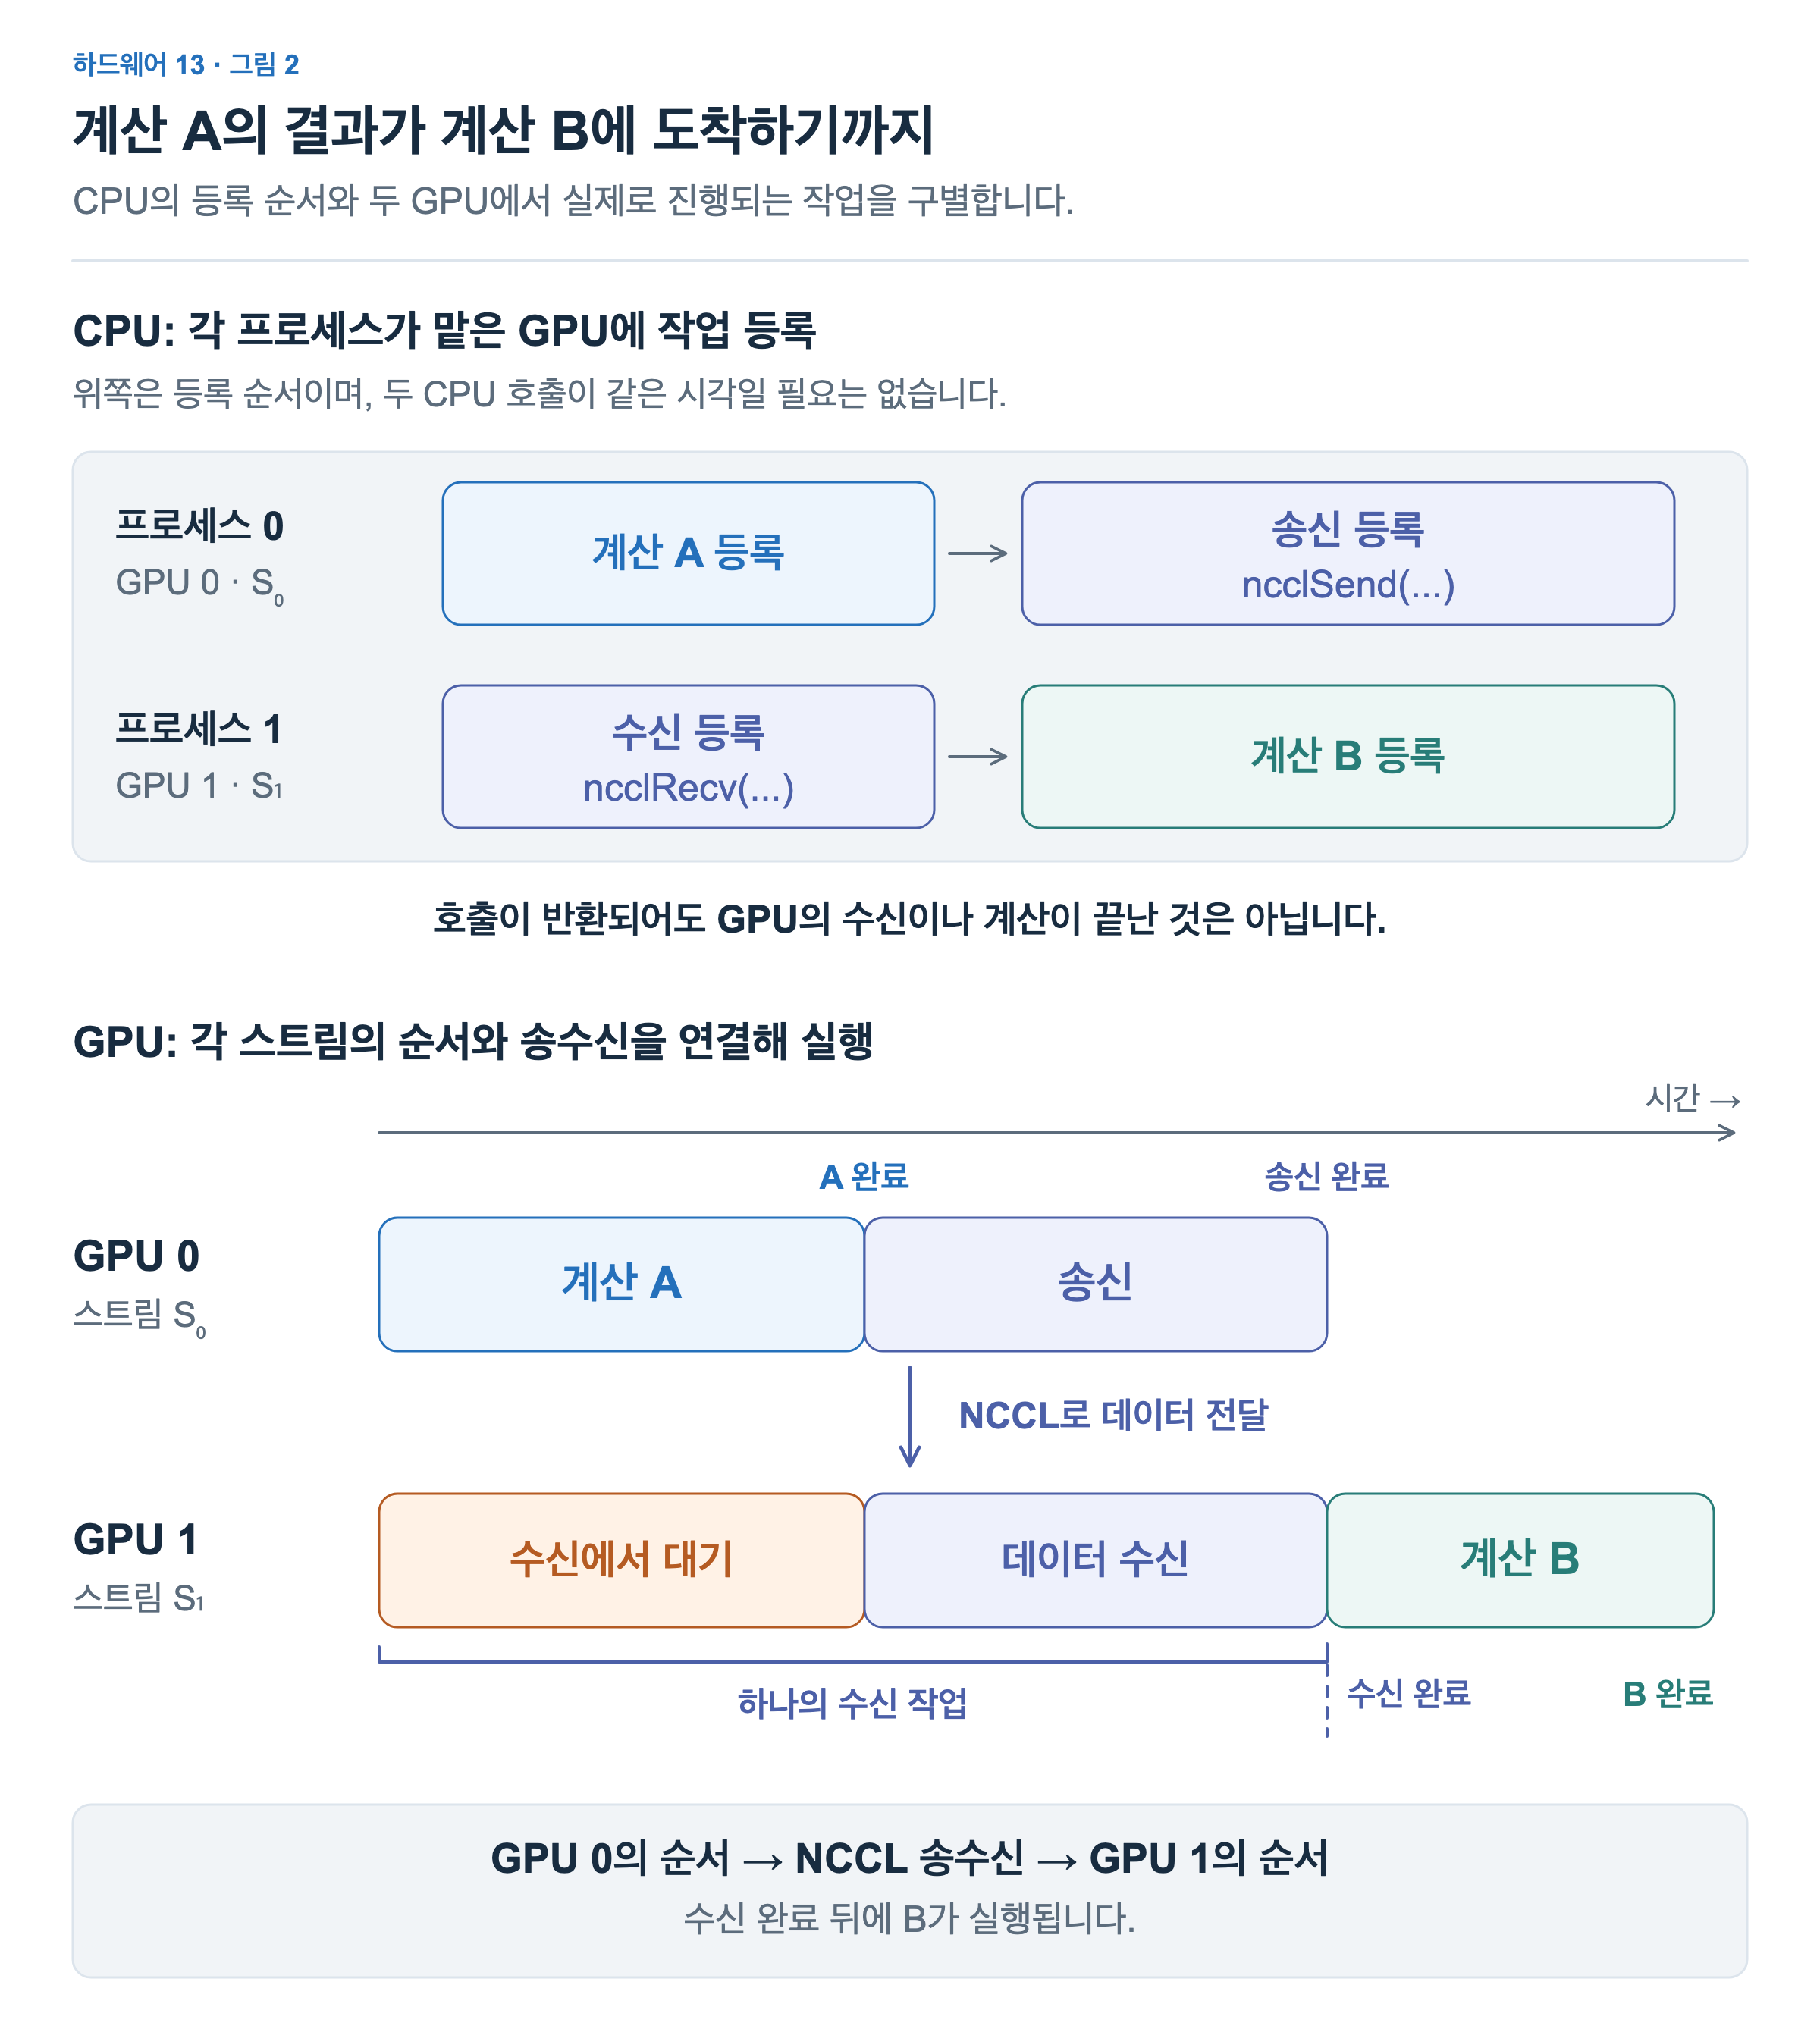
위쪽은 각 CPU 코드가 등록하는 순서이고, 아래쪽은 두 GPU의 실제 실행입니다. 아래 시간축은 GPU 1의 수신 작업이 먼저 시작된 경우를 보여줍니다. 다음 순서로 읽으면 됩니다.
- GPU 0에서 A가 실행되어 송신 버퍼의 x를 만듭니다. GPU 1에서는 수신 작업이 시작되었지만, 아직 전달받을 데이터가 준비되지 않아 기다립니다.
- A가 끝나면 GPU 0의 같은 스트림에서 송신이 진행됩니다. NCCL의 대응하는 송수신 작업을 통해 x가 GPU 1의 수신 버퍼에 전달됩니다.
- GPU 1의 수신이 완료되면 같은 스트림의 다음 작업인 B가 실행됩니다. B는 완성된 x를 읽고 y를 만듭니다.
여기에는 각 GPU 안의 순서와 GPU 사이의 전달이 함께 필요합니다. GPU 0의 스트림은 A 뒤에 송신하도록 하고, NCCL은 두 참여자의 송수신을 연결합니다. GPU 1의 스트림은 수신 뒤에 B를 실행하도록 합니다. 두 스트림을 만드는 것만으로 서로 다른 GPU의 데이터 전달까지 해결되는 것은 아닙니다.
그림의 송신 구간과 수신의 데이터 전달 구간은 같은 전달에 참여하는 시간입니다. ‘보내는 시간을 모두 쓰고 나서, 받는 시간을 다시 모두 쓴다’고 더하지 않습니다. 먼저 시작한 수신의 시간에는 상대 데이터가 준비되기를 기다리는 시간도 포함될 수 있습니다.
이 예시에서 CPU가 A 완료, 송신 완료, 수신 완료를 하나씩 기다린 뒤 다음 작업을 요청할 필요는 없습니다. 필요한 순서는 스트림과 송수신 관계로 연결되어 있습니다. GPU 1의 수신 뒤 작업이 기다린다고 해서 CPU의 다음 코드나 모든 GPU의 모든 작업까지 함께 멈춰야 하는 것도 아닙니다.
통신 중에 독립적인 계산 진행하기
B는 받은 x가 필요하므로 수신을 기다려야 합니다. 하지만 GPU 1에 별도 입력과 출력 공간을 사용하는 계산 C가 있다고 해보겠습니다. C는 x를 읽지 않고, 송수신이나 B가 사용하는 데이터도 변경하지 않습니다. 그러면 C는 x가 도착하기 전에 진행할 여지가 있습니다.
수신·C·B를 한 스트림에 차례로 놓으면 C도 수신이 끝날 때까지 기다립니다. 이번에는 GPU 1에 스트림 두 개를 준비해, 수신을 통신 스트림에 놓고 C와 B를 계산 스트림에 놓겠습니다. 어떤 스트림을 만들고 작업을 어디에 등록할지는 개발자나 프레임워크·라이브러리가 정합니다. 여기서는 프로세스 1이 GPU 1의 두 스트림에 작업을 등록합니다. 스트림을 두 개 만든다고 CPU 프로세스가 두 개 더 생기는 것은 아닙니다.
스트림을 나눈 뒤에도 B가 수신 완료 후에 실행되어야 한다는 조건은 유지해야 합니다. 이를 위해 5편에서 배운 이벤트를 사용합니다. 프로세스 1의 CPU 코드는 먼저 통신 스트림의 수신 뒤에 이벤트 E 기록을 등록합니다. 이어 계산 스트림에는 C, 이벤트 E 완료 대기, B를 차례로 등록합니다.
GPU 1의 통신 스트림: 수신 → 이벤트 E 기록
GPU 1의 계산 스트림: 계산 C → 이벤트 E 완료 대기 → 계산 B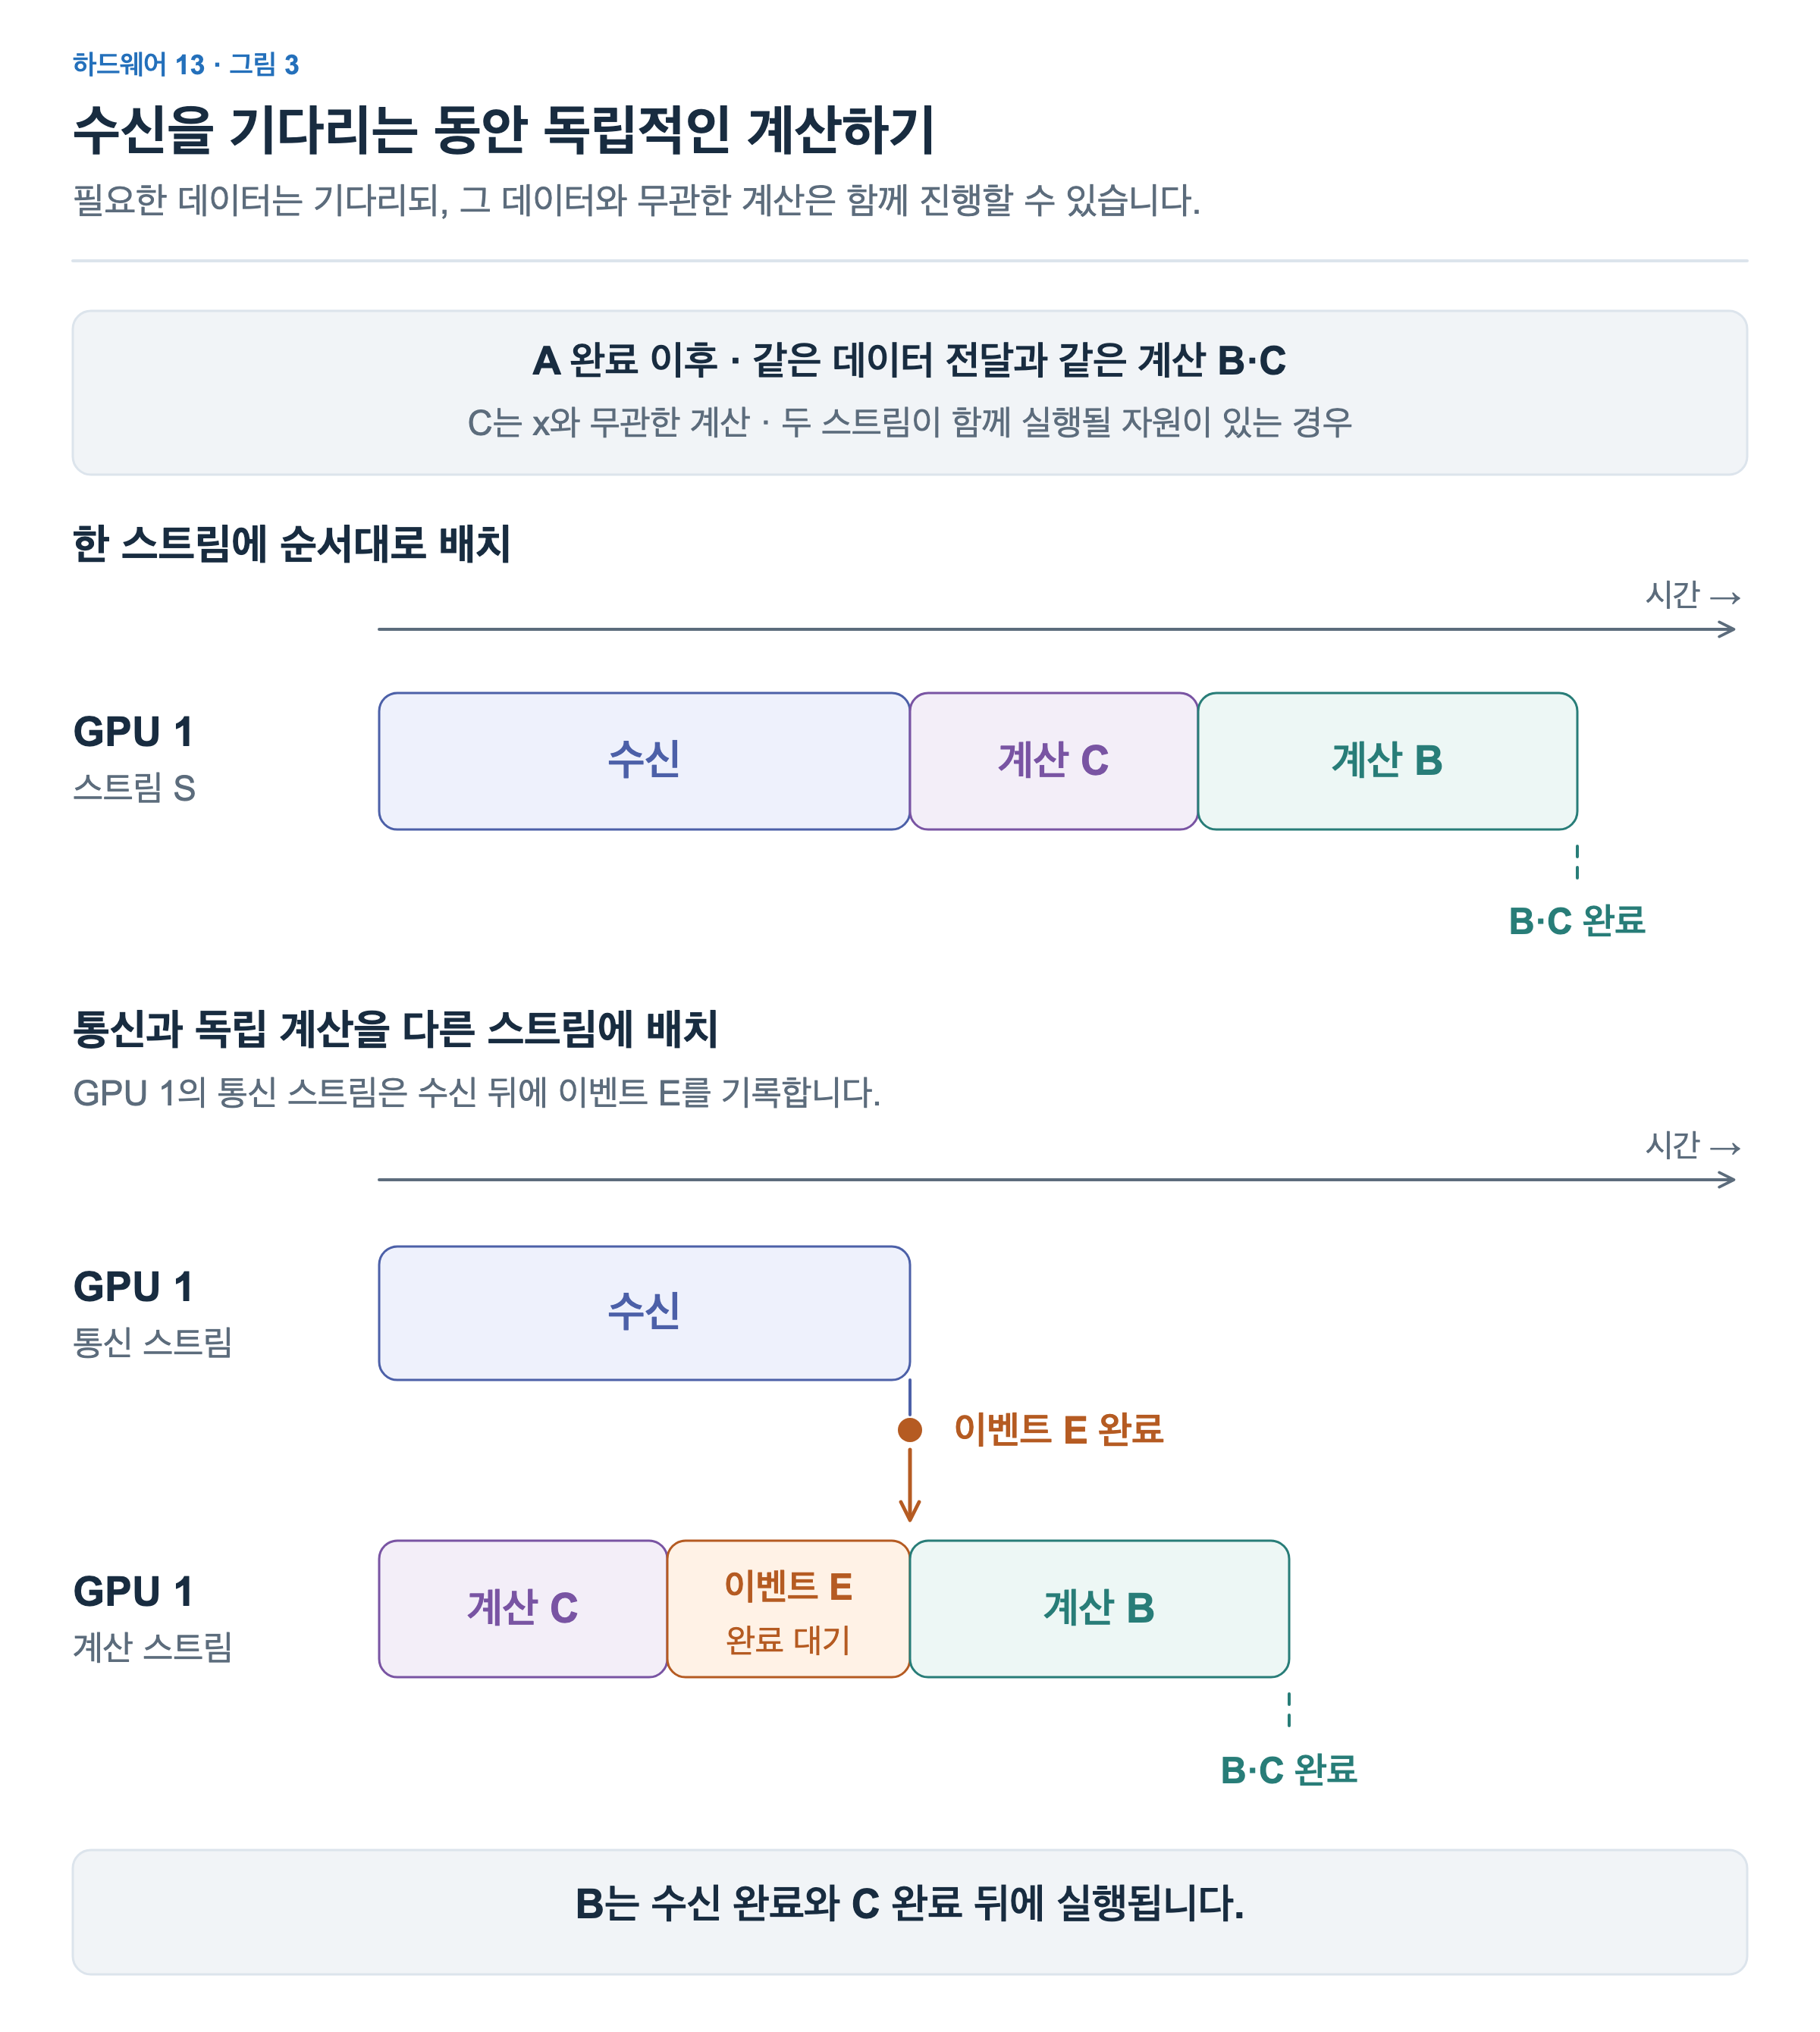
그림 3은 A가 완료된 뒤의 구간을 비교합니다. 위아래에서 전달할 데이터와 계산 B·C는 같습니다. 아래쪽에서는 수신이 진행되는 동안 C가 실행됩니다. C가 먼저 끝나더라도 이벤트 E가 아직 완료되지 않았다면 B는 기다립니다. 수신 뒤에 기록한 이벤트 E가 완료되면 이 대기 조건이 충족됩니다. CUDA 이벤트로 스트림 사이의 순서 연결하기
여기서 ‘이벤트 E 완료 대기’는 계산 스트림에서 뒤따르는 B의 실행을 늦추는 조건입니다. CPU가 이벤트 완료까지 멈춰서 기다린다는 뜻은 아닙니다. 또 이 이벤트는 GPU 1의 수신 완료를 계산 스트림에 연결합니다. GPU 0에서 GPU 1로 데이터를 보내는 일은 앞서 등록한 NCCL 송수신이 담당합니다.
수신과 C가 겹쳐 실행되려면 하드웨어와 실행 자원이 이를 허용해야 합니다. 스트림 두 개가 GPU 자원을 절반씩 예약하는 것은 아니며, 두 작업이 자원을 경쟁하면 각각의 시간이 길어질 수도 있습니다. 그림은 겹쳐 실행할 수 있는 경우를 보여줍니다. 실제 개선 여부는 수신과 B·C를 모두 마치는 시간이 줄었는지로 확인해야 합니다.
마지막 사용이 끝난 버퍼 재사용하기
같은 계산을 여러 입력에 반복한다면 다음 데이터를 위해 버퍼를 다시 사용하게 됩니다. 이때 송신 버퍼와 수신 버퍼를 같은 시점에 덮어써도 될까요? 각 버퍼를 마지막으로 사용하는 작업이 다르므로, 다시 쓸 수 있는 시점도 다릅니다.
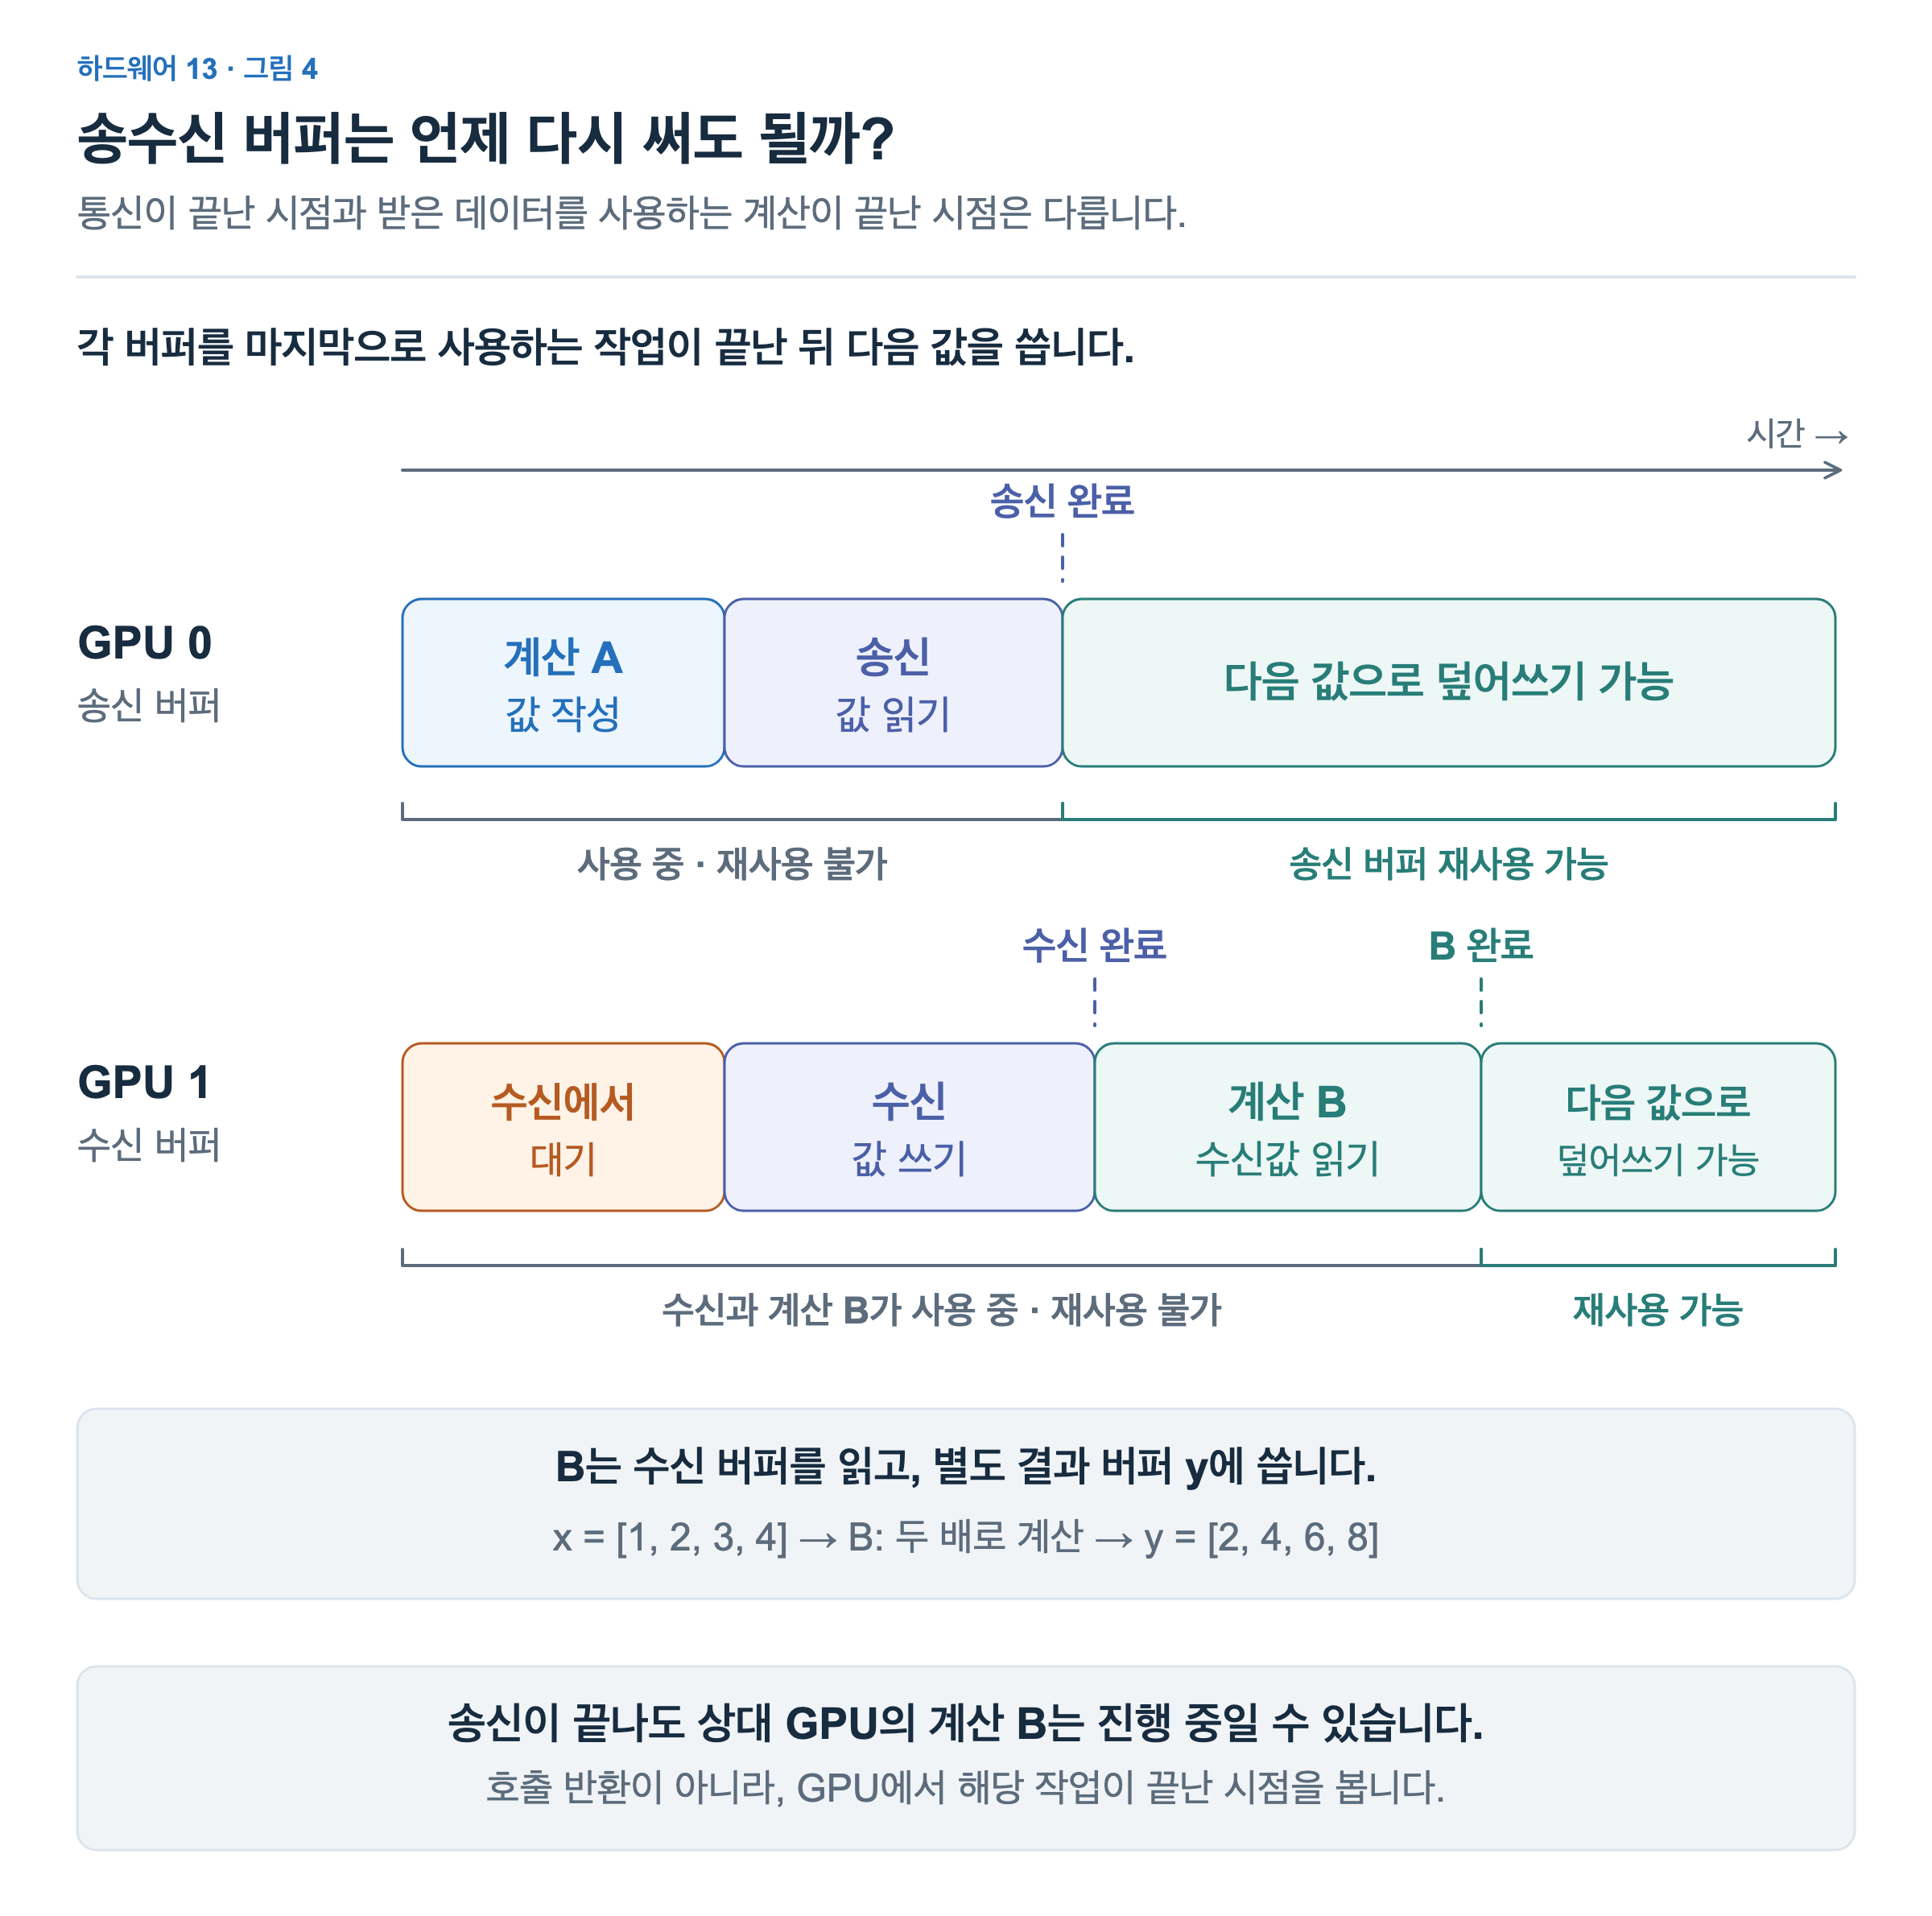
GPU 0의 송신 버퍼는 A가 값을 쓰고 송신 작업이 읽습니다. 송신이 이 버퍼를 사용하는 동안 다음 입력의 A가 값을 덮어쓰면 전달해야 할 내용이 바뀔 수 있습니다. 따라서 GPU에서 송신 작업이 완료된 뒤 다음 값을 씁니다. CPU의 ncclSend 호출이 반환된 것만으로는 충분하지 않습니다.
GPU 1의 수신 버퍼는 수신 작업이 값을 쓰고, 이어서 B가 읽습니다. 수신 완료는 B가 값을 사용하기 시작할 수 있는 시점입니다. 다음 데이터를 같은 공간에 받을 수 있는 시점은 B가 그 값을 다 사용한 뒤입니다. 이번 예시에서는 B가 완료된 뒤 수신 버퍼를 재사용합니다. B의 출력은 별도 결과 버퍼 y에 저장하므로, 이 설명에서는 입력 x의 사용 기간을 보고 있습니다.
이 때문에 GPU 0의 송신이 끝났어도 GPU 1의 B까지 끝났다고 볼 수 없습니다. 송신 완료, 수신 완료, 받은 데이터를 사용하는 계산 완료는 구별해야 합니다. 그림 4의 위아래 행은 각각의 버퍼를 더 이상 사용하는 작업이 없는 시점을 표시합니다.
재사용할 때마다 CPU가 반드시 기다려야 하는 것은 아닙니다. GPU 0의 같은 스트림에 ‘A → 송신 → 다음 A’를 등록하면 다음 A는 송신 뒤에 실행됩니다. GPU 1도 같은 스트림에 ‘수신 → B → 다음 수신’을 등록하면 순서로 버퍼 사용을 보호할 수 있습니다. 서로 다른 스트림에서 다음 쓰기를 진행한다면, 앞서 본 이벤트처럼 필요한 완료 관계를 따로 연결해야 합니다.
CPU가 작업 완료를 확인해야 할 때도 있습니다. 예를 들어 GPU 작업을 모두 끝내고 버퍼와 통신 자원을 정리하려면, 해당 자원을 사용하는 작업의 완료를 보장해야 합니다. CPU에서 특정 스트림의 완료를 기다리는 방법으로는 cudaStreamSynchronize가 있습니다. B 뒤까지 등록한 스트림을 기다리면 B의 완료도 확인할 수 있습니다. CUDA 스트림 완료 대기
CPU가 y의 실제 값을 읽으려면 한 단계가 더 필요합니다. B가 끝났어도 y는 여전히 GPU 메모리에 있으므로, 5편에서 본 것처럼 결과를 CPU 메모리로 복사하고 그 복사의 완료까지 보장해야 합니다. 완료를 기다리는 일과 데이터를 옮기는 일은 별개의 동작입니다.
반복하는 동안에는 준비한 통신 그룹과 버퍼를 유지하고, 각 버퍼의 마지막 사용이 끝난 뒤 다음 작업에 사용할 수 있습니다. 이번 글에서는 이렇게 CPU의 준비와 등록, 두 GPU의 송수신과 계산, 마지막 사용 뒤 재사용까지 연결했습니다. 다음 글에서는 송수신 호출 아래로 내려가, 어떤 실행 장치가 데이터를 옮기고 어떤 연결을 통과하는지 살펴보겠습니다.