추론 · 워크로드 · 2026-09-19
추론과 KV 캐시
반복적인 토큰 생성에서 같은 계산이 되풀이되는 이유와 KV 캐시의 재사용 과정을 살펴보고, 출력 토큰 선택과 KV 계산의 경계를 구별합니다.
같은 모델, 다른 워크로드: 추론과 학습에서는 추론이 가중치를 유지한 채 다음 토큰을 생성하는 과정임을 살펴보았습니다. 선택한 토큰은 다시 입력이 되고, 모델은 그 뒤에 이어질 토큰을 예측합니다. 이때 문맥 전체를 매번 처음부터 계산하면 이미 처리한 앞부분의 계산도 반복됩니다.
이번 글에서는 한 요청이 토큰을 하나씩 생성하는 과정을 따라가겠습니다. 먼저 어떤 계산이 반복되는지 살펴보고, 과거의 K/V를 저장해 그 계산을 줄이는 방법으로 연결하겠습니다. 마지막에는 출력으로 선택한 토큰과 KV 계산이 끝난 위치를 구별하겠습니다.
토큰을 하나씩 생성하는 과정
입력 토큰이 p0 p1 p2라고 하겠습니다. p는 처음 주어진 입력, x는 생성 중 선택한 출력 토큰을 나타냅니다. 설명을 위한 기호이며, 토큰 하나가 반드시 단어 하나에 대응하는 것은 아닙니다.
입력을 모델에 통과시키면 각 위치의 표현이 계산됩니다. LM Head는 이 표현으로 어휘에 속한 토큰들의 예측 점수인 logits를 만듭니다. 다음 토큰을 생성할 때는 마지막 입력 위치의 점수를 사용합니다. 여기서는 p2 위치의 점수로 첫 출력 x0를 선택합니다. 가장 점수가 높은 토큰을 고르거나, 점수로 만든 확률 분포에서 하나를 뽑을 수 있습니다.
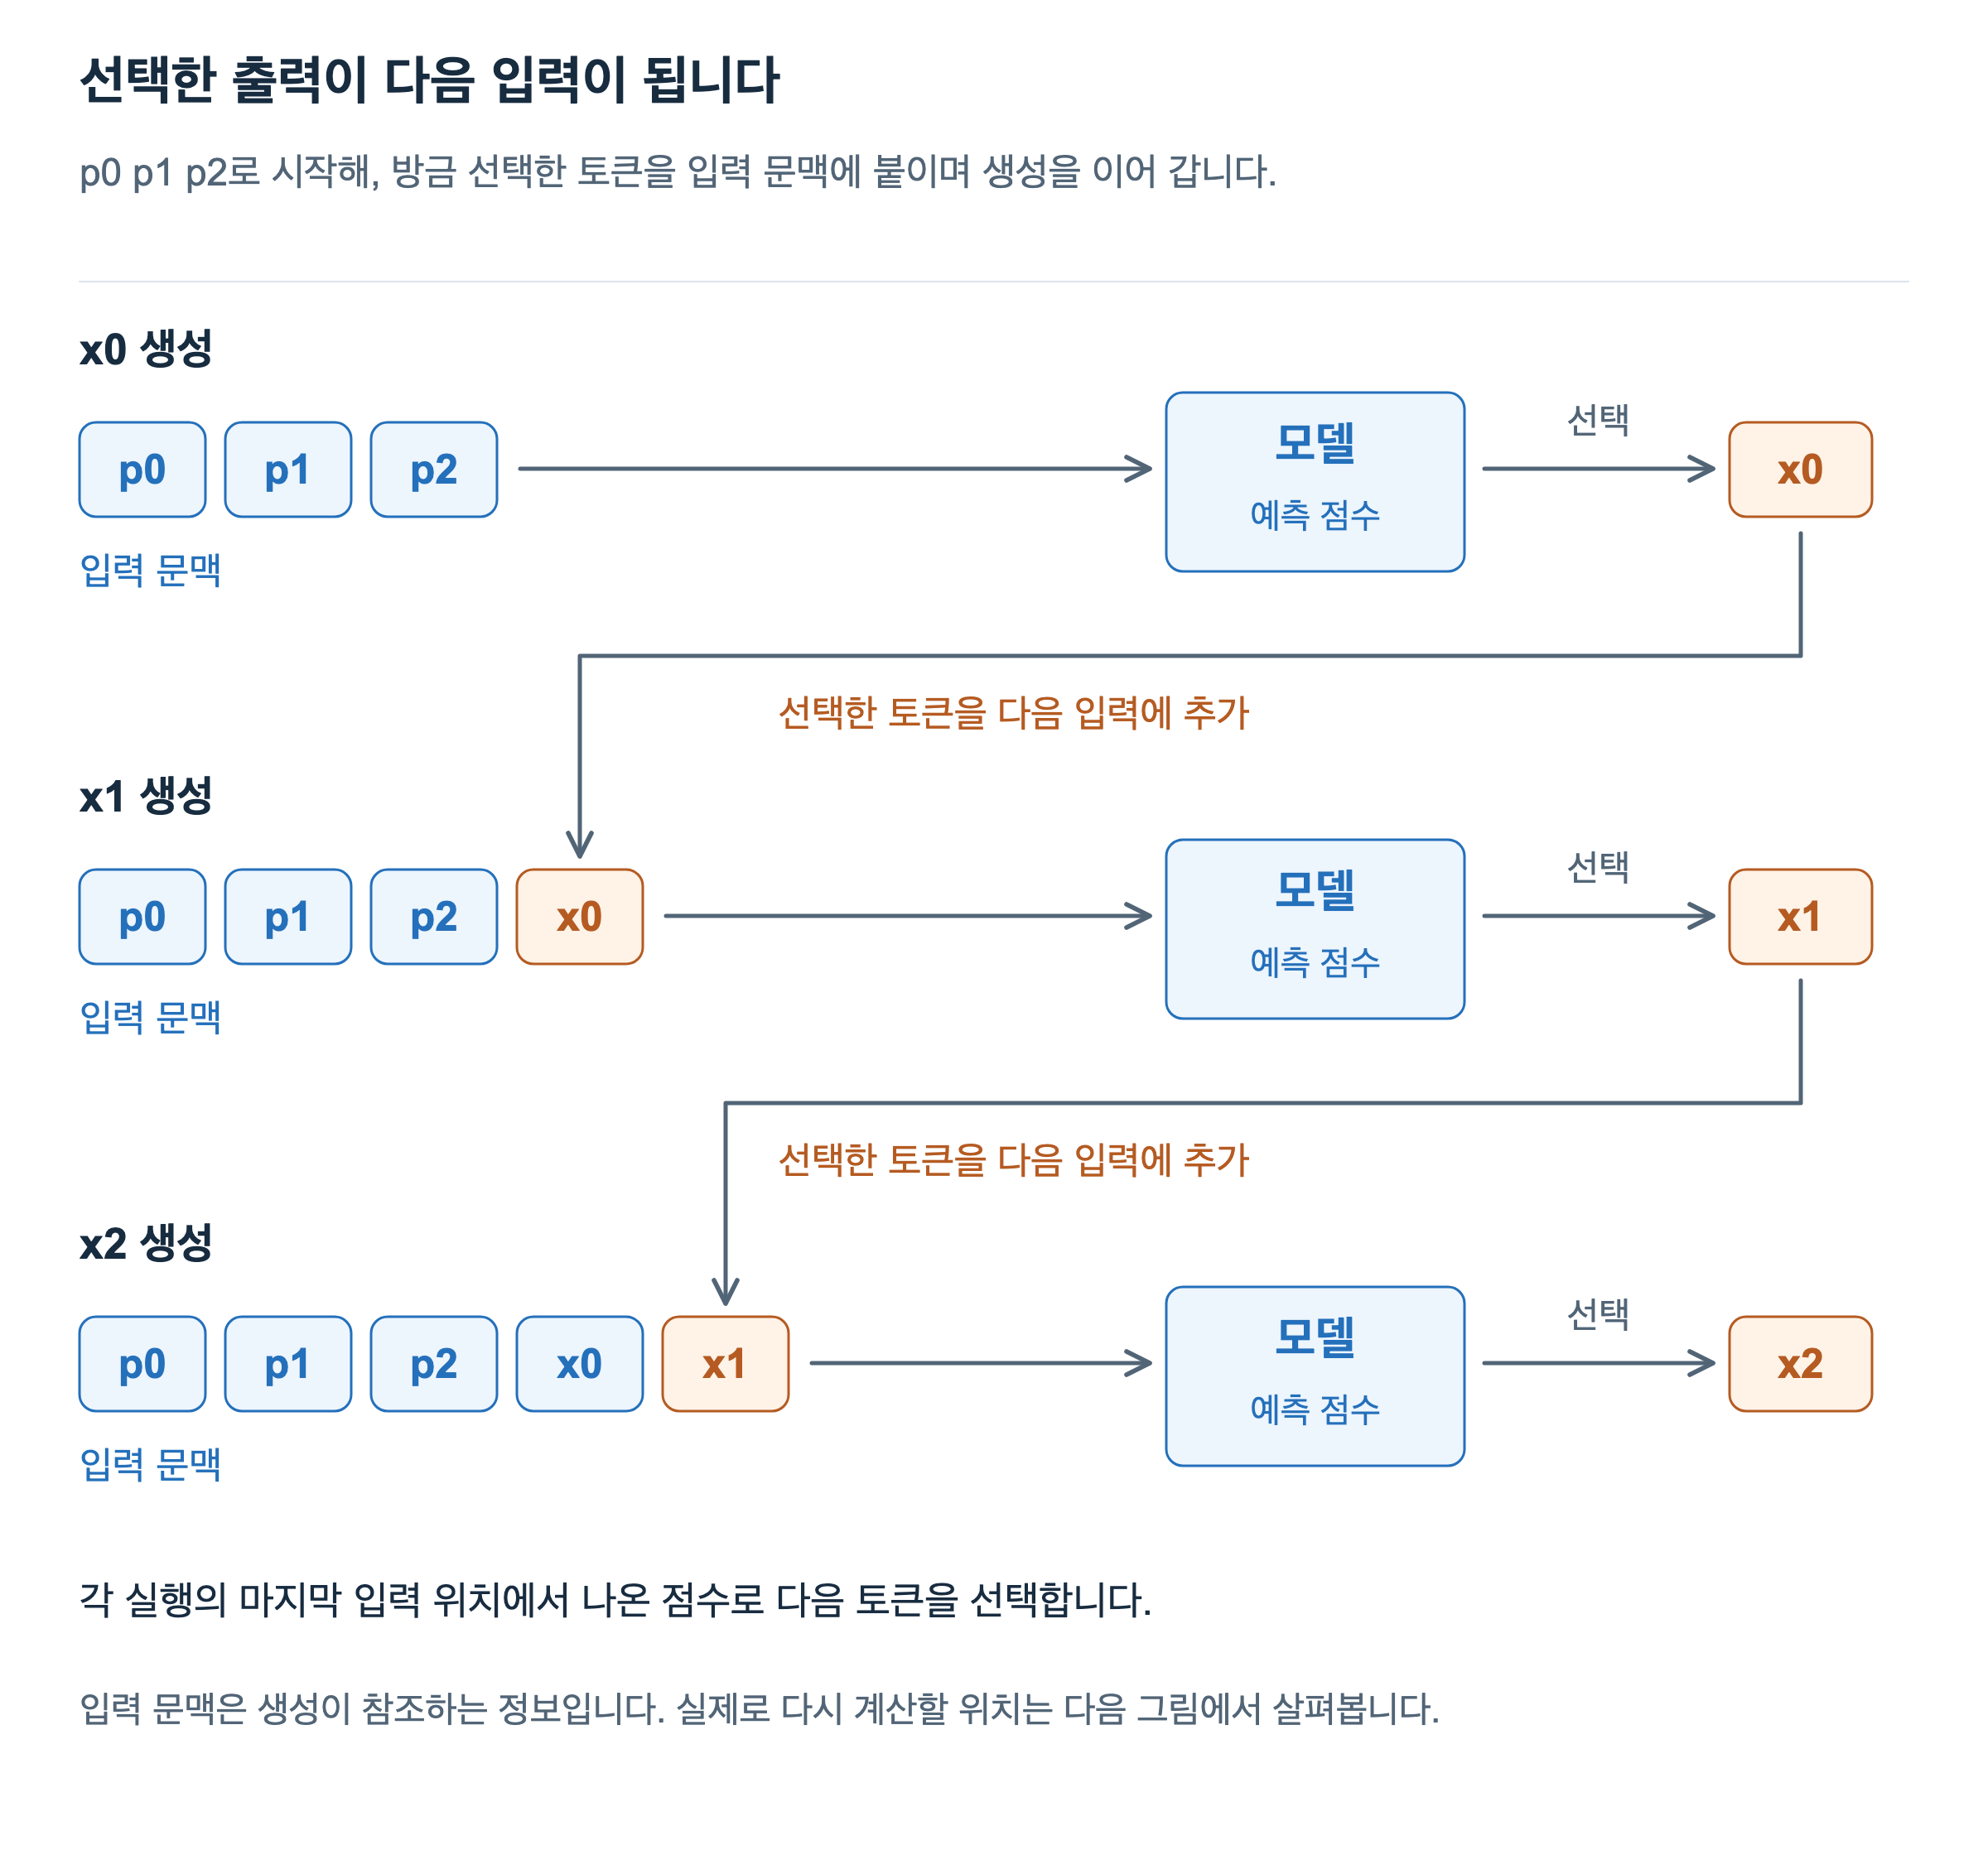
x0를 선택하면 다음 예측에 사용할 문맥은 p0 p1 p2 x0가 됩니다. 이 문맥으로 x1을 선택하고, 다시 x1을 붙여 x2를 선택합니다. 그림 오른쪽의 출력이 다음 줄의 입력으로 돌아가는 화살표가 이 반복을 보여줍니다. 다음에 어떤 토큰을 입력할지는 현재 토큰을 선택한 뒤에 정해집니다.
여기서 입력 문맥은 다음 예측이 참조할 전체 정보입니다. 이 정보를 활용하기 위해 매번 모든 위치를 다시 계산해야 하는지는 별개의 문제입니다. 같은 생성 과정을 유지하면서 계산을 줄일 수 있는지 살펴보겠습니다.
캐시 없이 반복되는 계산
가장 단순한 구현은 현재 문맥 전체를 매번 모델에 넣는 것입니다. 첫 실행에서는 p0 p1 p2, 다음에는 p0 p1 p2 x0, 그다음에는 p0 p1 p2 x0 x1을 계산합니다. 새 토큰이 하나 추가될 때마다 앞부분도 함께 모델을 통과합니다.
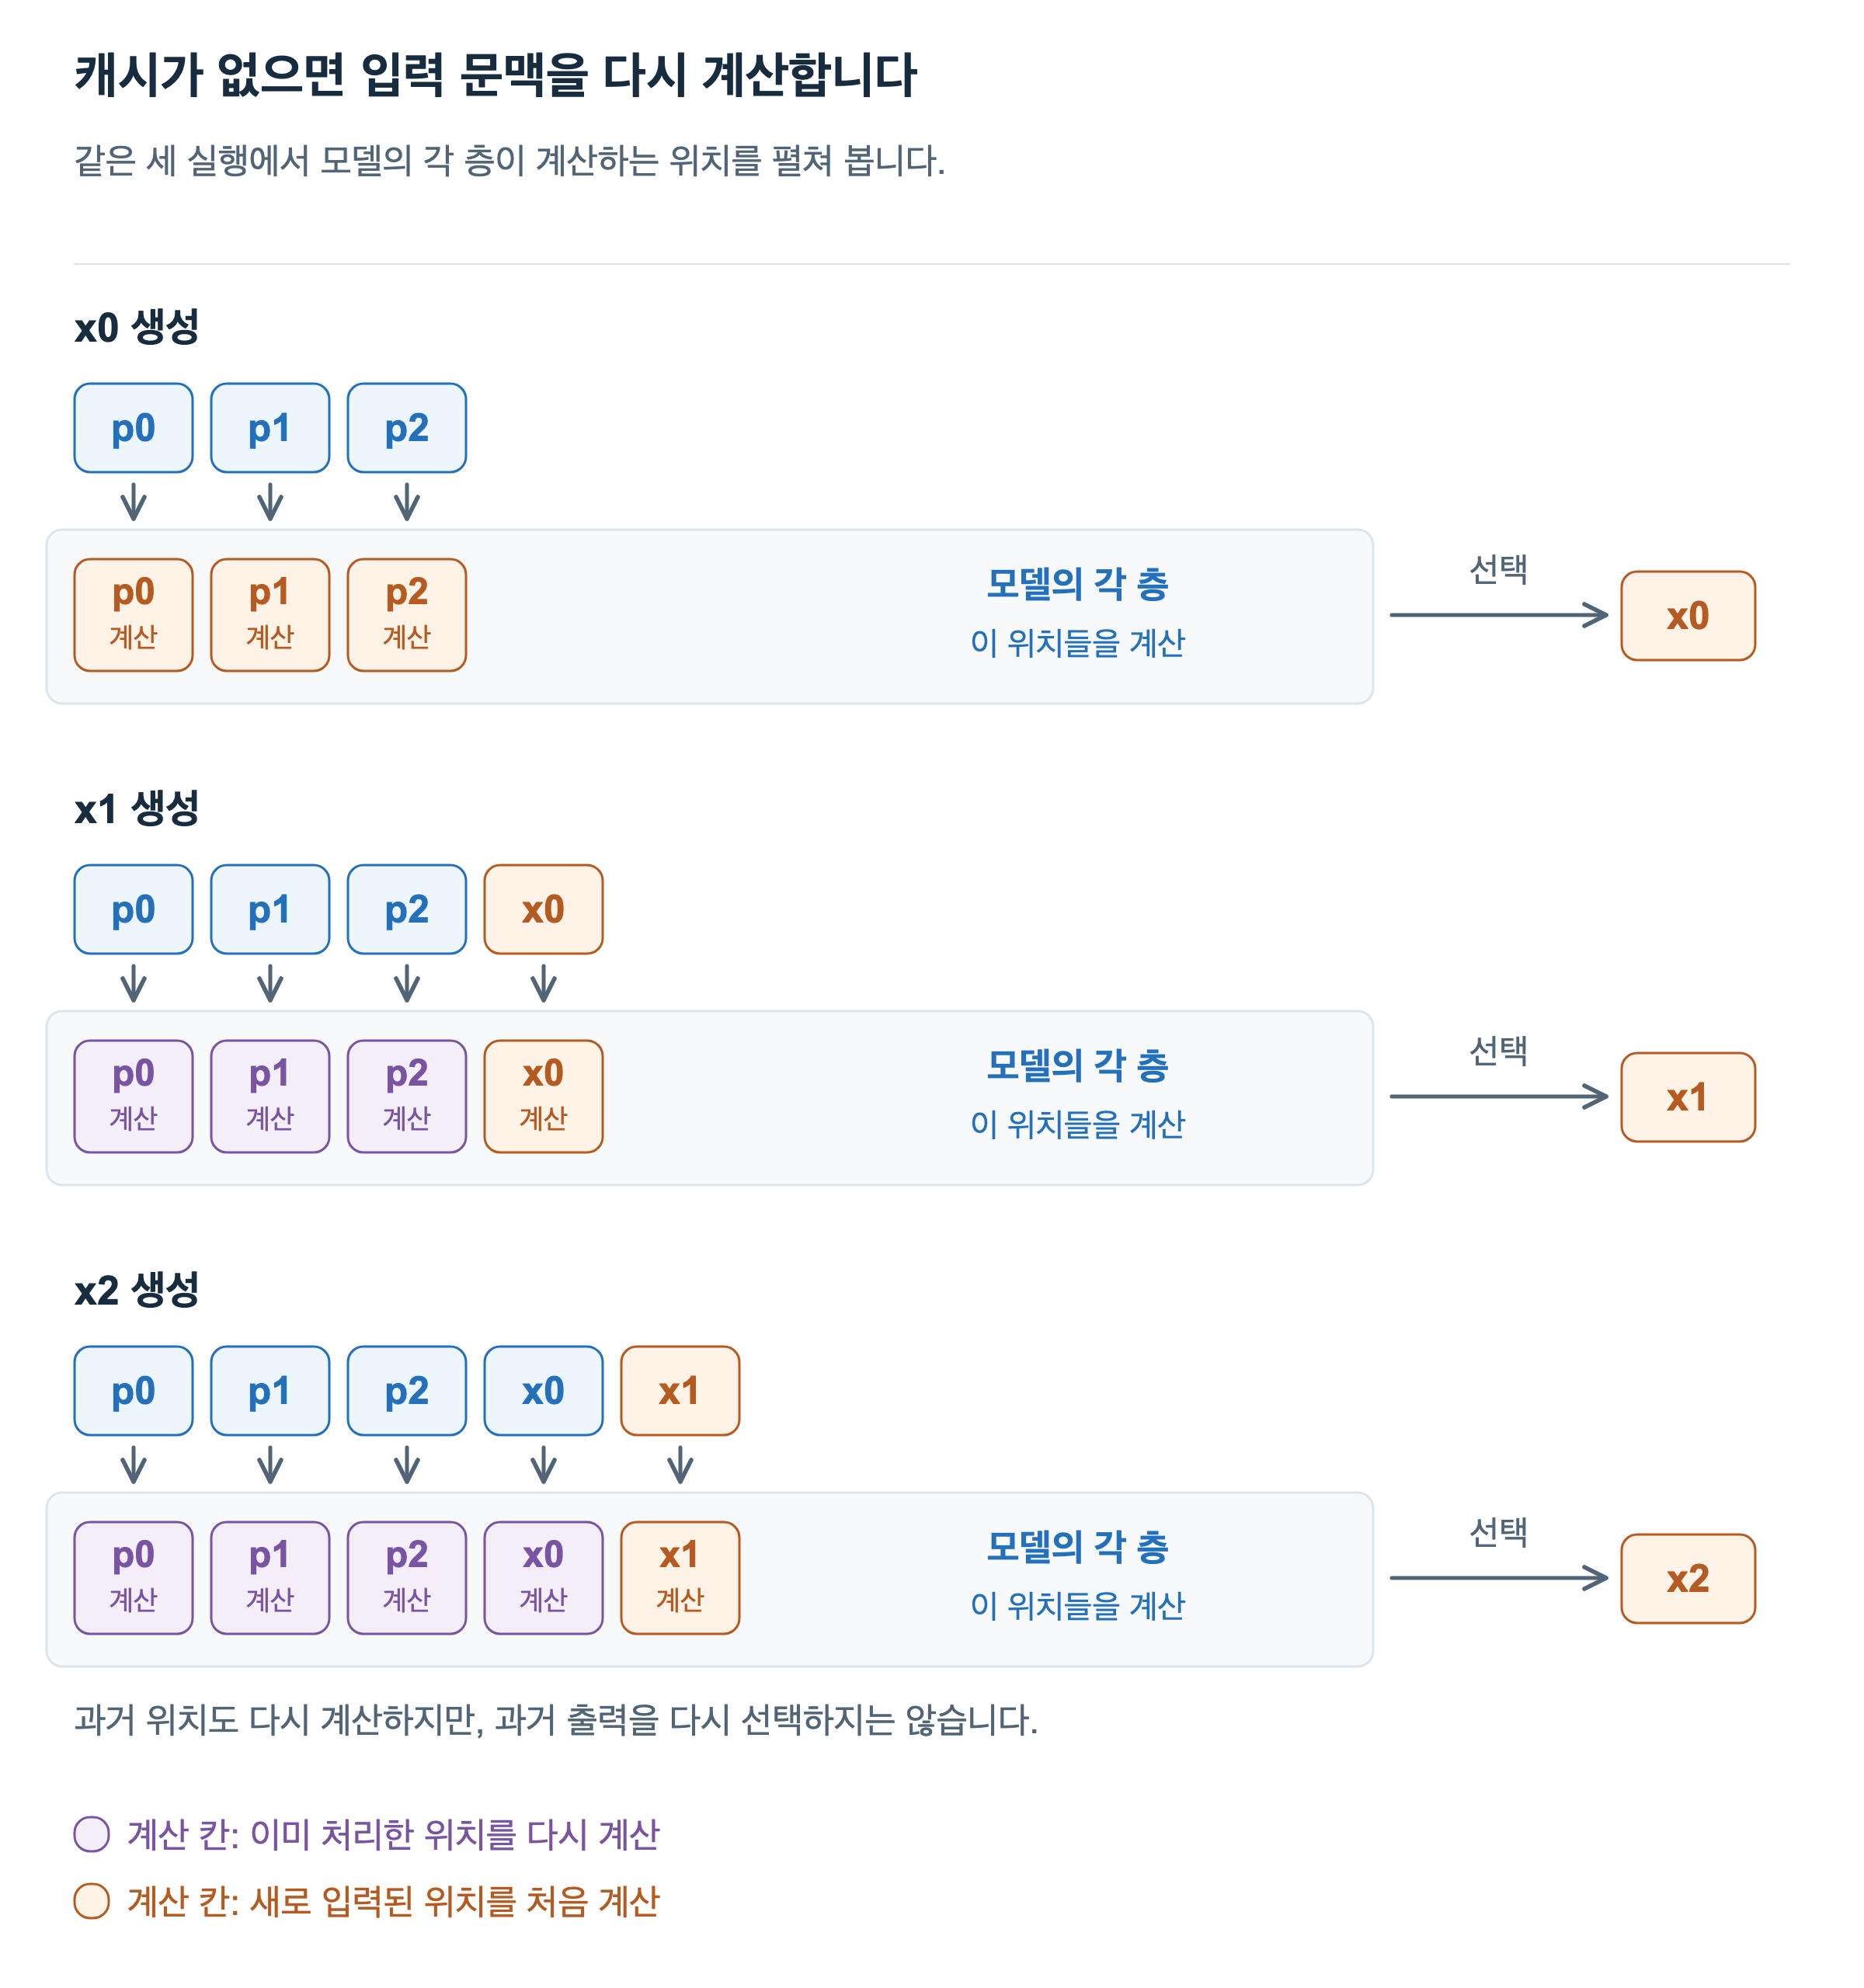
그림의 주황색 계산 칸은 이번에 처음 처리하는 위치이고, 보라색 계산 칸은 이미 처리했던 위치를 다시 계산하는 부분입니다. x1을 선택하는 실행을 보면, 새 입력 x0의 계산에 더해 p0 p1 p2의 계산도 반복합니다. 각 층에서 과거 위치의 K/V를 다시 만들고, Attention과 MLP도 다시 실행합니다.
이어 x2를 선택할 때는 p0 p1 p2뿐 아니라 앞서 처리한 x0까지 재계산합니다. 다만 이미 선택한 출력 토큰이 바뀌는 것은 아닙니다. 토큰 이력은 유지한 채, 그 입력 위치들의 계산 결과를 다시 만드는 것입니다.
생성이 이어질수록 같은 위치를 계산하는 횟수가 늘어납니다. 과거 위치의 결과가 그대로 유효하다면, 다음 실행에서도 사용할 값을 보관해 이 반복을 줄일 수 있습니다.
KV 캐시로 과거 계산 재사용하기
KV 캐시(KV cache)는 과거 입력 위치에서 계산한 Key와 Value를 다음 실행에 재사용하도록 저장한 것입니다. 토큰 ID 자체를 보관하는 것과는 다릅니다. 같은 토큰이라도 앞선 문맥과 위치가 다르면 K/V가 달라질 수 있으므로, 여기서는 같은 요청에서 이미 처리한 위치의 K/V를 재사용합니다.
과거 계산을 그대로 써도 되는 이유는 causal Attention에 있습니다. 한 위치는 자기 위치와 그 앞의 위치만 참조합니다. 예를 들어 p1은 p0 p1을 참조하지만, 뒤에 추가되는 x0를 참조하지 않습니다. 따라서 입력·위치·가중치가 같은 일반적인 추론에서는 x0가 추가되어도 앞선 p1 위치의 계산 결과가 달라지지 않습니다.
이 성질은 각 층에서도 유지됩니다. 과거 위치의 Attention은 미래 위치를 보지 않고, 정규화와 MLP 같은 토큰별 연산도 미래 위치를 섞지 않습니다. 그래서 각 층에서 이미 계산한 K/V를 보관해 두면, 새 위치를 처리할 때 과거 위치의 계산을 다시 실행할 필요가 없습니다. Transformers의 KV 재사용 설명
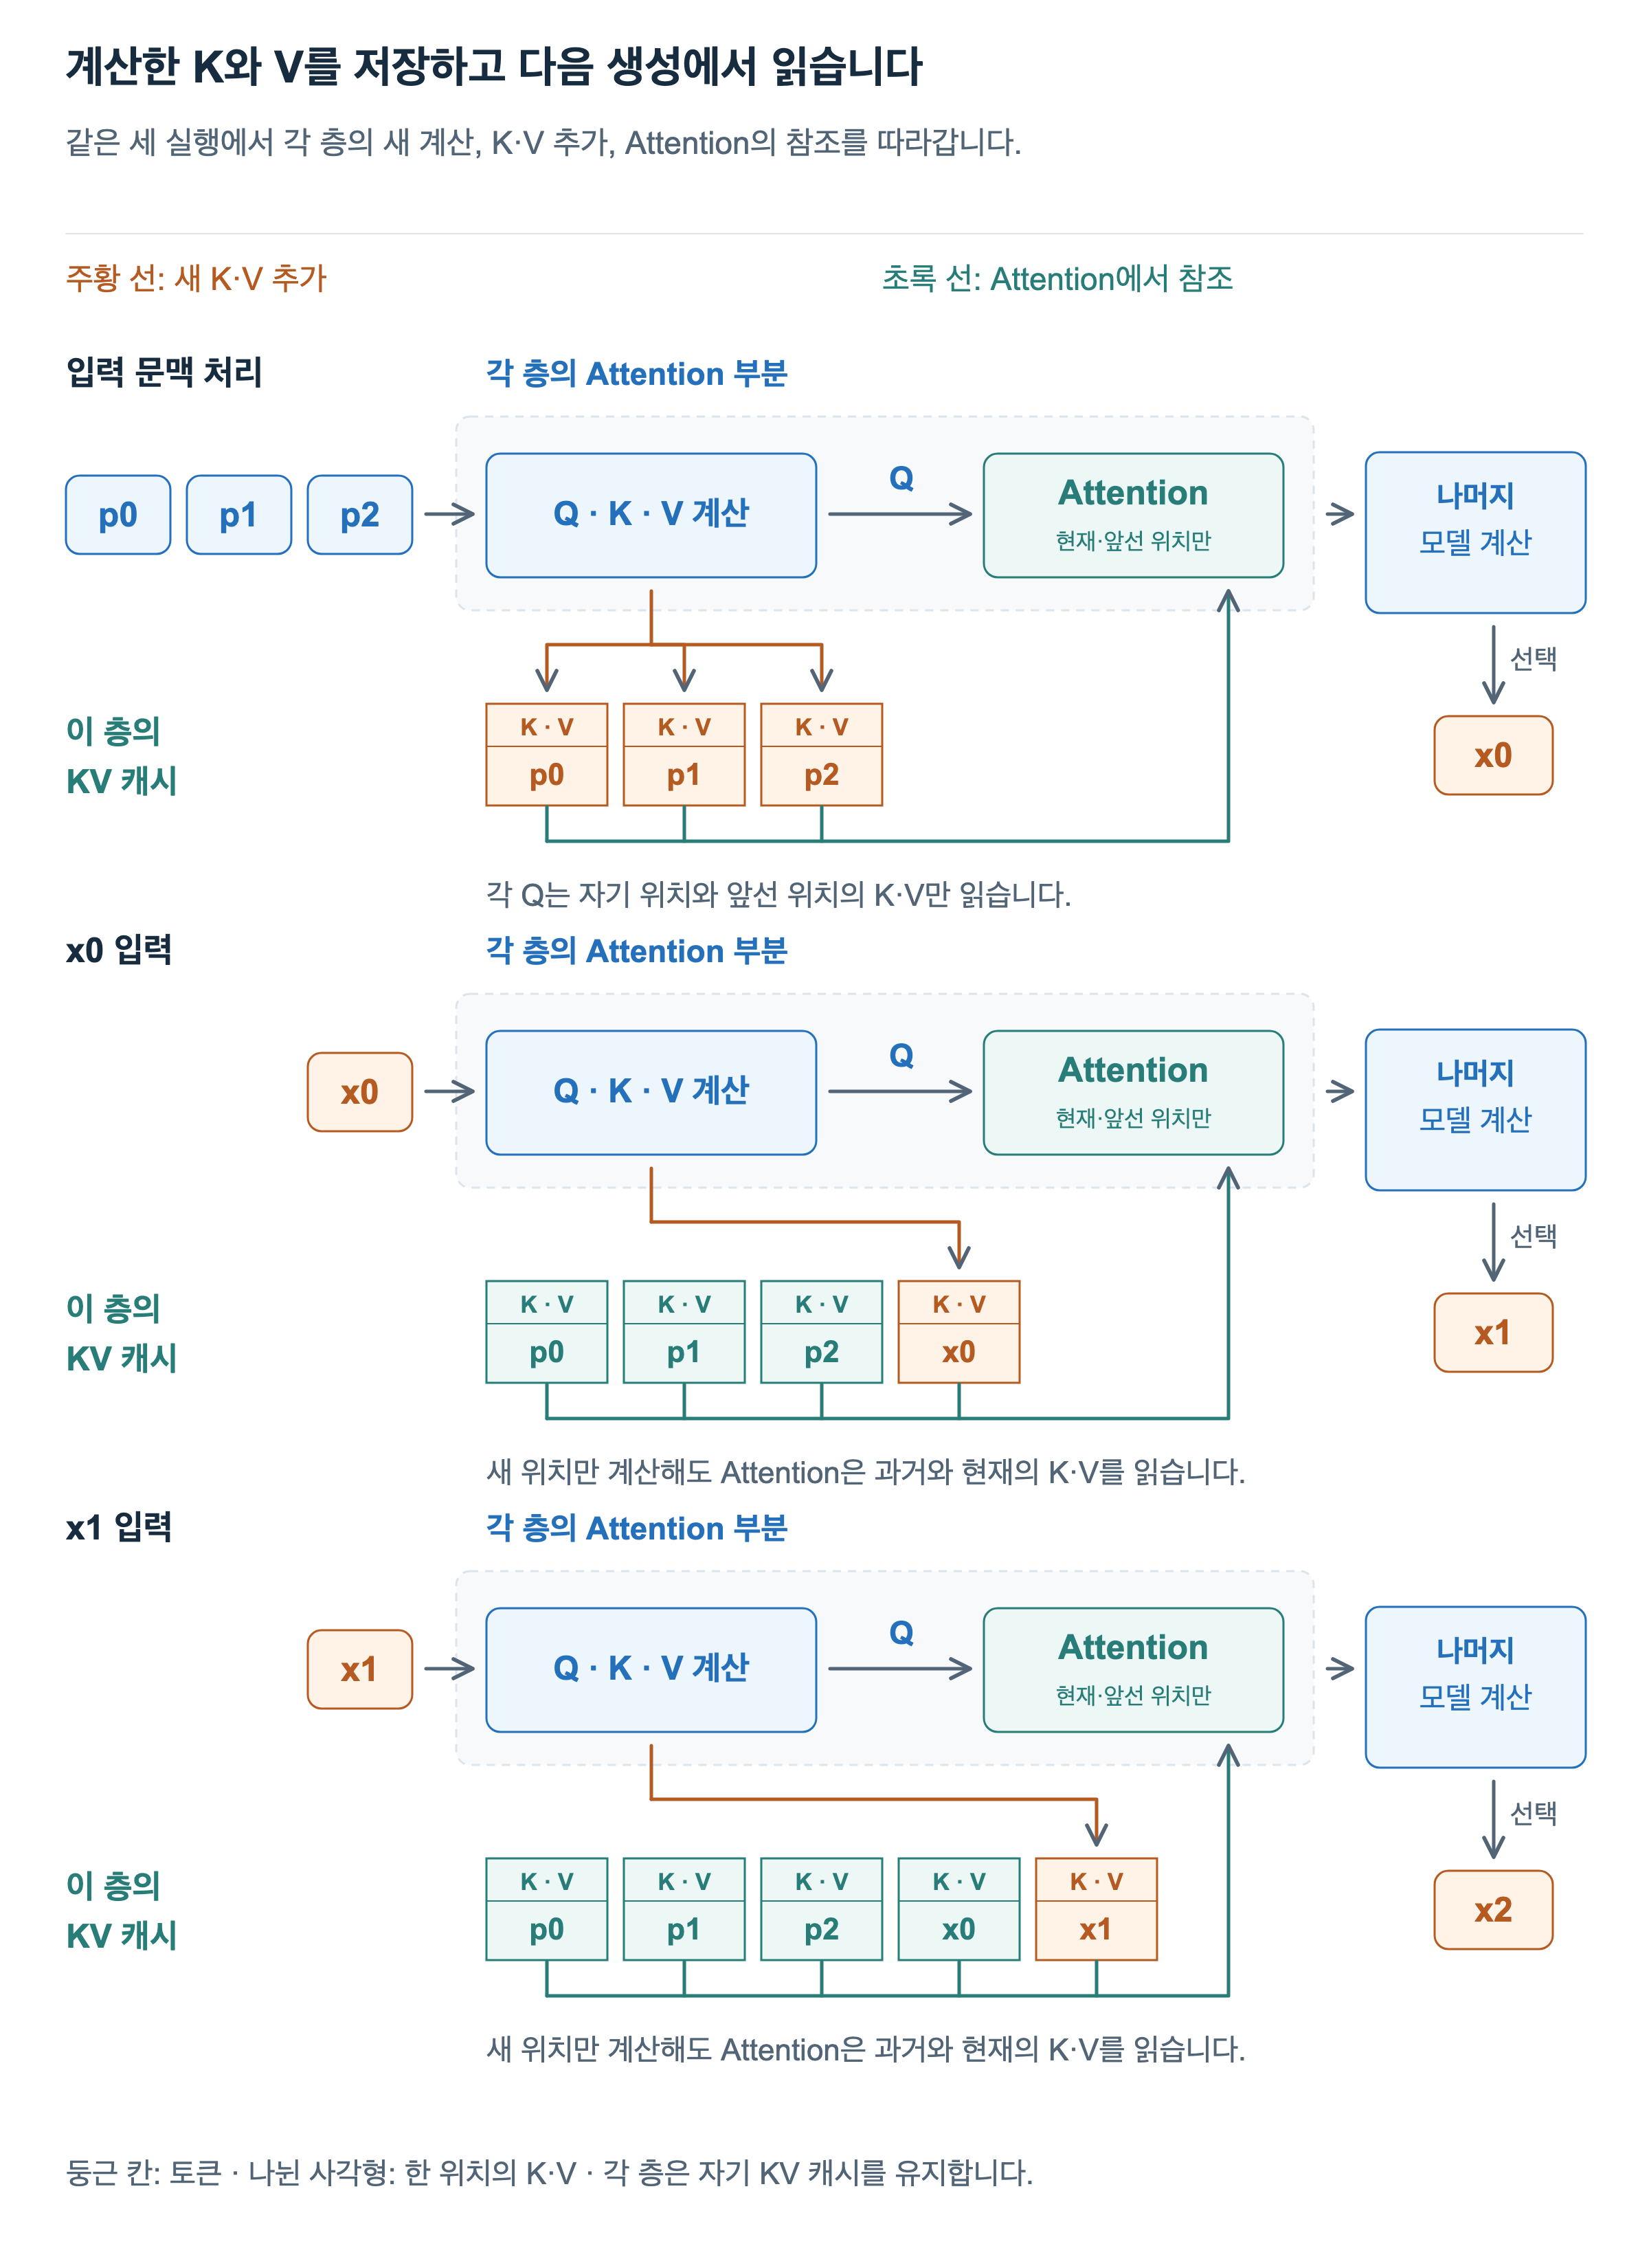
그림은 모델 각 층의 Attention 부분을 펼친 것입니다. 둥근 칸은 입력·출력 토큰이고, K·V와 위치가 나뉘어 적힌 사각형은 저장된 계산 결과입니다. 주황색 경로는 새 K/V를 캐시에 추가하는 흐름, 초록색 경로는 Attention이 K/V를 읽는 흐름을 나타냅니다.
처음에는 p0 p1 p2를 처리해 각 층의 K/V를 저장합니다. 이후 x0를 입력할 때는 그 위치의 Q/K/V를 새로 계산하고, Q(x0)가 과거 p0 p1 p2와 현재 x0의 K/V를 함께 참조합니다. 새로 만든 x0의 K/V도 캐시에 남습니다. 다음에 x1을 입력하면 같은 방식으로 x1의 K/V가 추가됩니다.
이때 과거 위치의 Q는 보관할 필요가 없습니다. x0의 Attention을 계산하는 데 필요한 것은 Q(x0)와 참조할 위치들의 K/V입니다. 이미 처리가 끝난 p0 p1 p2의 Q를 다시 사용하지 않습니다. 각 층의 계산 관계는 다음과 같습니다.
이번 Attention = Attention(새 Q, [과거 K, 새 K], [과거 V, 새 V])대괄호는 과거와 현재 위치의 K/V를 함께 참조한다는 뜻입니다. 캐시가 있으면 새 입력 위치가 각 층의 계산을 통과하고, 과거 위치에서 반복하던 계산은 생략할 수 있습니다. 다만 새 위치의 Attention이 과거 K/V를 읽는 일은 여전히 필요합니다. 문맥 정보가 사라진 것이 아니라, 다시 계산하는 대신 저장된 값을 읽어 사용하는 것입니다.
토큰 선택과 KV 계산의 경계
그림에서 입력과 출력이 한 토큰씩 어긋나 있다는 점을 살펴보겠습니다. 처음 입력 p0 p1 p2를 처리하고 x0를 선택한 직후에는 세 입력 위치의 KV가 준비되어 있습니다. 그러나 방금 선택한 x0의 KV는 아직 없습니다. 모델이 계산한 것은 입력으로 받은 위치들의 표현이고, x0는 그 계산 결과로 다음에 올 토큰을 고른 것이기 때문입니다.
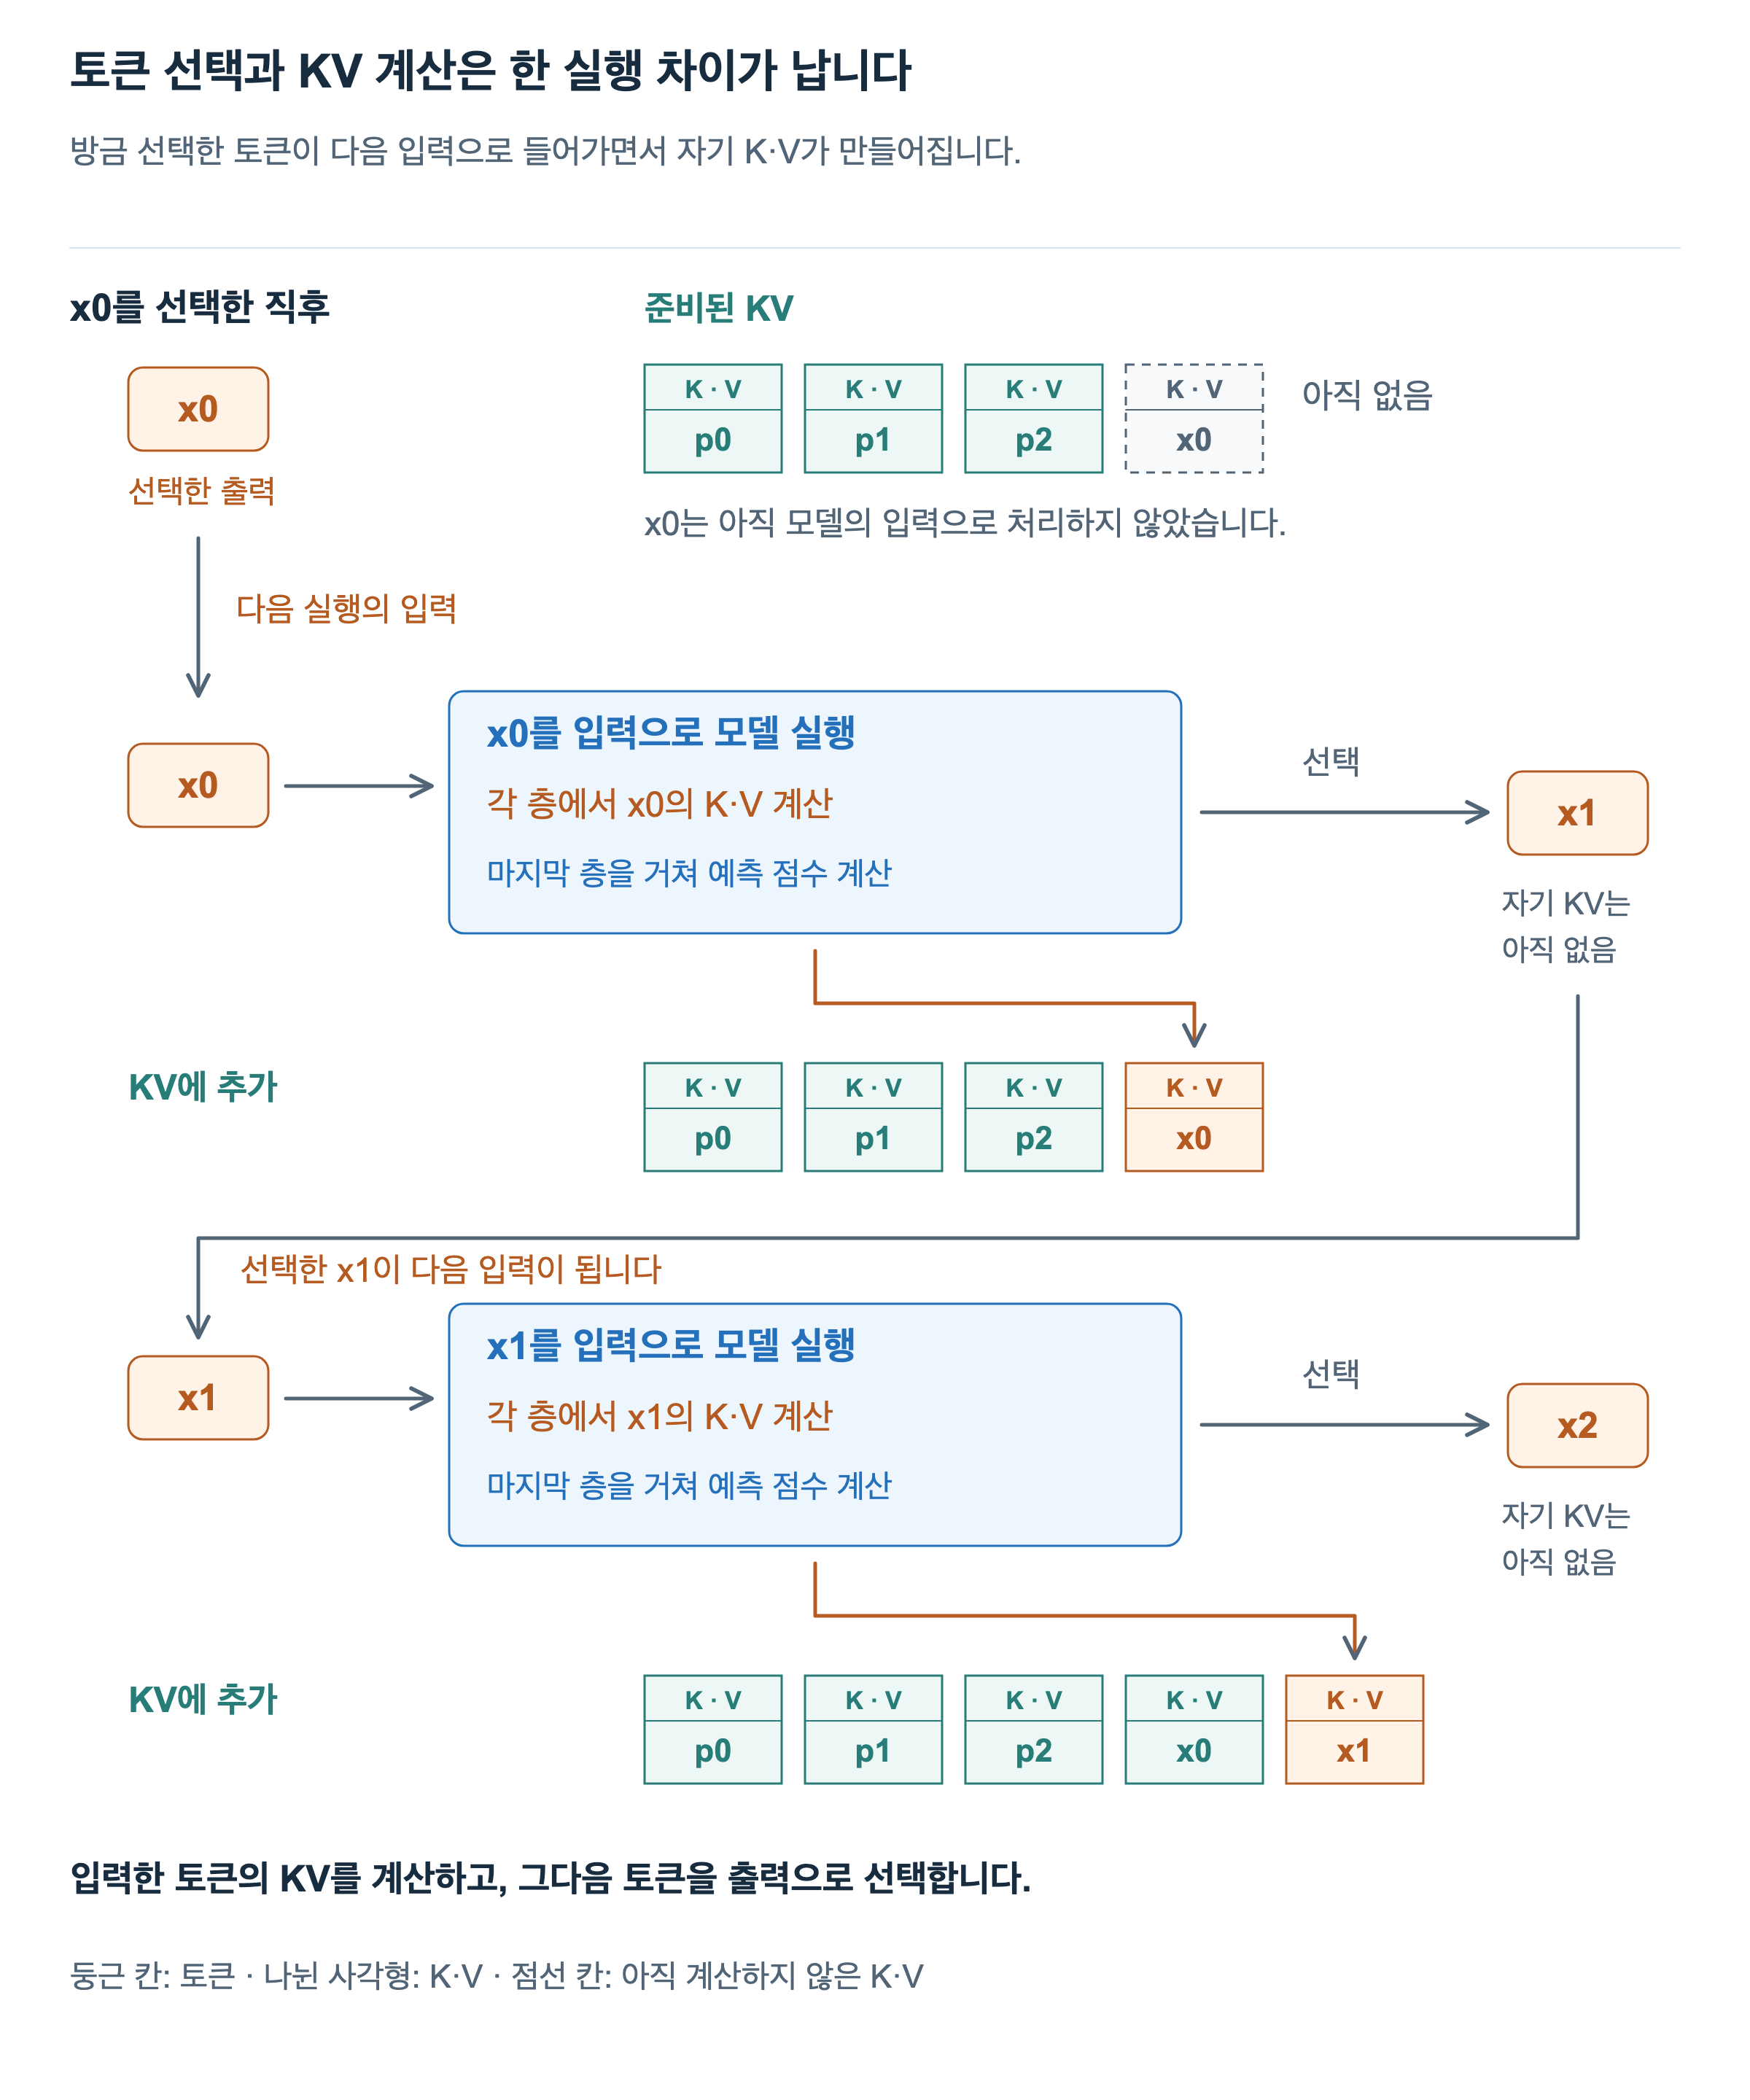
그다음 실행에는 x0가 입력으로 들어갑니다. 모델은 각 층에서 x0의 K/V를 계산하고, 과거 K/V를 참조하며 이 위치의 표현을 만들어 갑니다. 마지막 층과 LM Head를 거쳐 얻은 점수로 x1을 선택합니다. 이때 캐시는 p0 p1 p2 x0까지 준비되어 있지만, 새로 선택한 x1의 KV는 아직 없습니다.
이어 x1이 다음 입력으로 들어가면 x1의 KV가 만들어지고 x2를 선택합니다. 그림에서 출력 토큰은 다음 실행의 입력으로 이어지고, 모델 안에서 계산한 K/V는 캐시에 추가됩니다. 토큰을 선택하는 실행과 그 토큰의 K/V를 계산하는 실행이 다릅니다. 같은 순간에도 토큰 이력에는 x1까지 있고, KV는 그 앞의 x0까지만 준비되어 있을 수 있습니다.
이 경계를 구별하면 다음 실행에서 무엇을 계산할지도 분명해집니다. 이미 KV가 있는 과거 위치는 재사용하고, 방금 선택해 아직 처리하지 않은 토큰은 새 입력으로 계산합니다. 이 과정을 반복하며 출력과 KV가 함께 늘어납니다.
처음에는 주어진 입력 문맥을 함께 처리하고, 이후에는 새 입력 하나를 처리하며 과거 KV를 읽었습니다. 다음 글에서는 이 두 실행을 Prefill과 Decode로 구분하고, 한 번에 계산하는 토큰 수와 참조하는 문맥 길이가 계산량과 메모리 읽기에 어떤 차이를 만드는지 살펴보겠습니다.