추론 · 워크로드 · 2026-09-19
KV 캐시 관리와 PagedAttention
필요한 만큼 KV 블록을 배정하고, 흩어진 KV로 Attention을 계산하는 과정을 살펴봅니다. 같은 입력에서 여러 응답을 만들 때의 블록 공유와 Copy-on-write도 설명합니다.
배치와 스케줄링에서는 실제 KV를 담을 용량이 충분해도 새 요청이 기다릴 수 있다는 점을 살펴보았습니다. 진행 중인 요청이 앞으로 사용할 공간까지 크게 예약해 두면, 아직 비어 있는 공간도 다른 요청에 줄 수 없기 때문입니다.
이 문제를 줄이려면 KV가 늘어날 때 필요한 만큼 공간을 배정할 수 있어야 합니다. 그때마다 기존 데이터를 더 큰 영역으로 옮기지 않으려면, 한 요청의 KV가 서로 떨어진 곳에 저장되어도 계산할 수 있어야 합니다.
이번 글에서는 KV 공간을 작은 블록으로 나누어 배정하고, 토큰 순서와 실제 저장 위치를 연결하는 방법부터 살펴보겠습니다. 이어서 흩어진 KV를 읽는 PagedAttention을 설명하고, 같은 입력에서 여러 응답을 만들 때 공통 KV를 공유해 저장 공간을 줄이는 방법까지 보겠습니다.
필요한 만큼 블록 배정하기
앞선 글의 B와 C를 그대로 가져오겠습니다. 가중치와 계산용 작업 공간을 제외한 KV 저장 용량은 토큰 24개 위치 분량입니다. B는 현재 6개 위치의 KV를 갖고 있지만, 앞으로의 생성을 위해 20개 위치 분량을 예약했습니다. 새 요청에 배정할 수 있는 공간은 4개뿐이므로, 입력이 6토큰인 C는 들어오지 못합니다.
이번에는 공간을 작은 단위로 나누어 보겠습니다. 여러 토큰 위치의 KV를 담는 일정한 크기의 저장 단위를 블록(block)이라고 합니다. 예시에서는 블록 하나에 네 위치의 KV를 저장하겠습니다. 전체 24칸은 블록 6개에 해당합니다. 그림의 한 칸은 토큰 자체가 아니라, 그 위치에서 계산한 K와 V를 저장하는 공간입니다.
B의 현재 KV 6개를 담으려면 블록 2개가 필요합니다. 8칸을 배정하면 6칸에 KV가 들어가고 2칸이 남습니다. B가 다음 입력을 처리해 KV가 7개로 늘어나도 이 안에 들어갑니다. C의 입력 6토큰에도 블록 2개를 배정하면 됩니다.
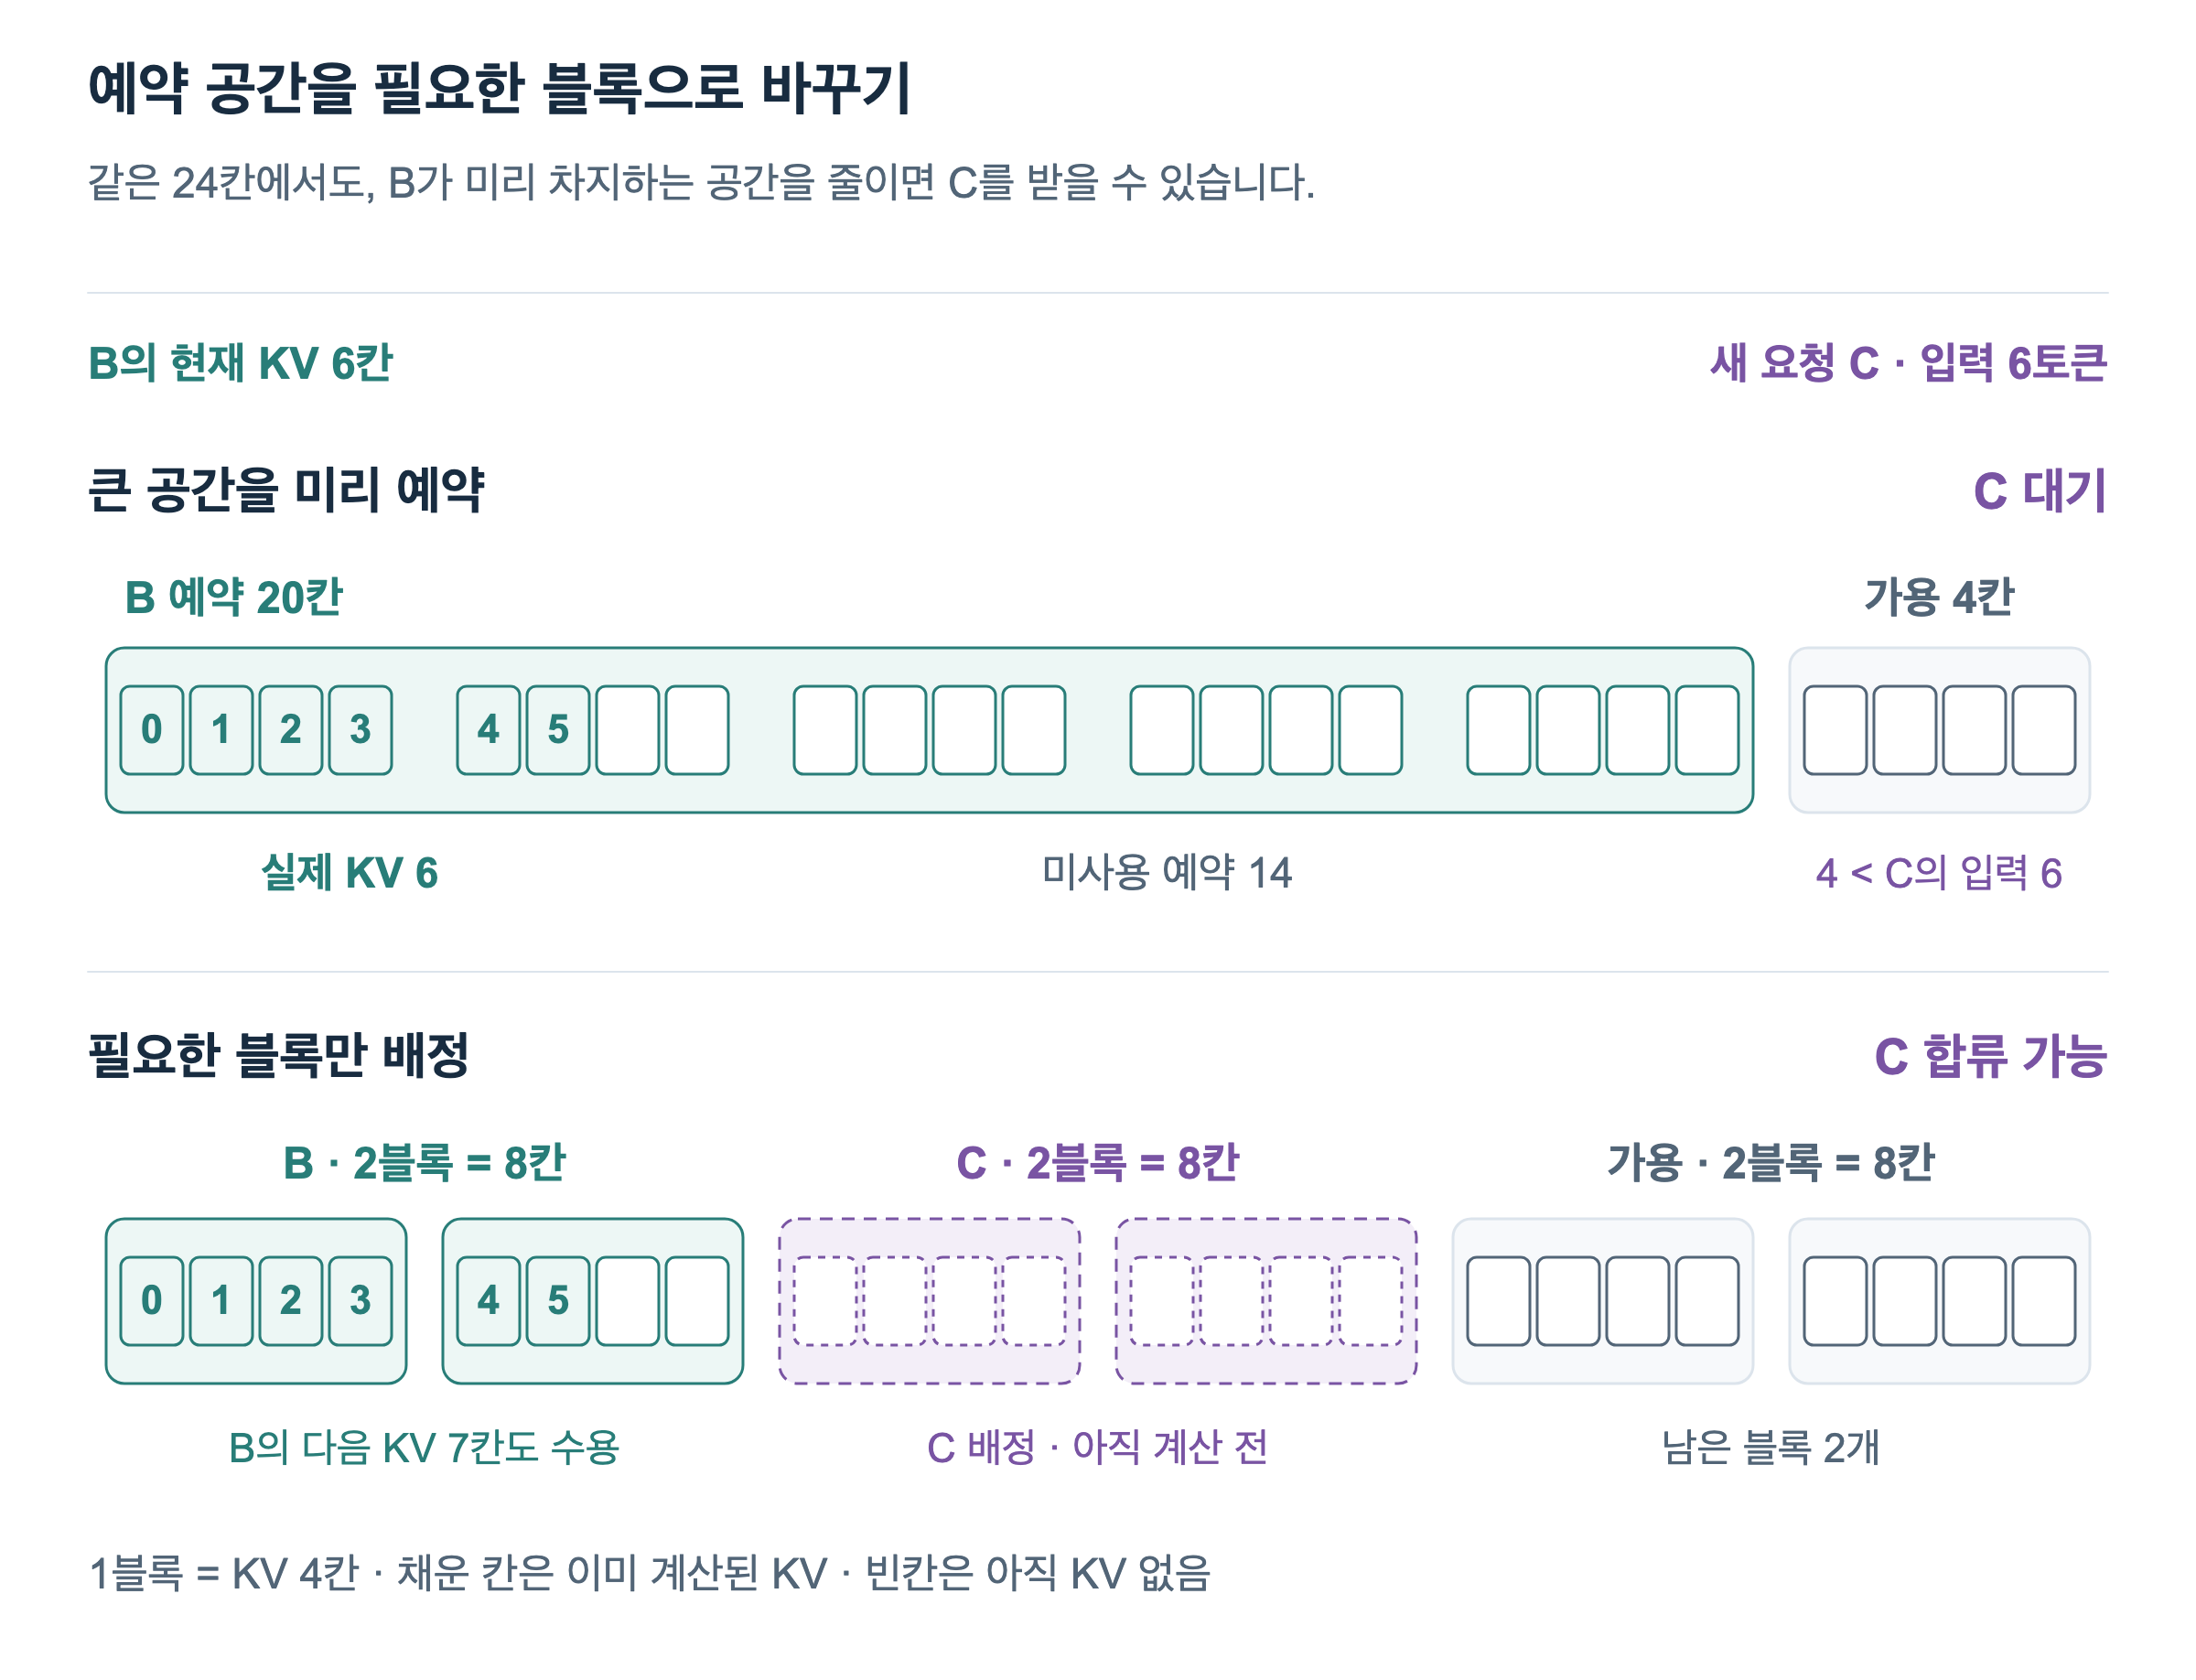
그림 1의 아래쪽에서는 B와 C에 각각 8칸, 합계 16칸을 배정하고도 8칸이 남습니다. B의 먼 미래에 필요할 공간을 모두 묶어 두지 않았기 때문에 C가 사용할 공간을 확보할 수 있습니다. 이후 B가 더 길어지면 그때 블록을 추가로 배정합니다.
여기서 공간을 배정하는 것과 KV를 계산하는 것은 별개입니다. 점선으로 표시한 C의 블록에는 아직 KV가 없습니다. C의 입력을 모델에 넣어 처리해야 그 공간에 KV가 기록됩니다. B와 C가 다음 실행을 마치면 실제 KV는 7 + 6 = 13개가 되고, 배정한 16칸 중 3칸은 아직 비어 있게 됩니다.
블록 방식에서도 마지막 블록 안의 빈칸은 남을 수 있습니다. 다만 이 예시처럼 필요한 블록만 배정하면, 요청의 최대 길이를 위해 큰 공간 전체를 예약하는 낭비를 줄일 수 있습니다. 앞선 글의 실행 토큰 예산도 만족하므로, 이 예시에서는 C를 함께 실행할 수 있습니다.
토큰 순서와 저장 위치 연결하기
블록을 필요할 때마다 배정하려면 새로 받은 블록이 기존 블록 바로 옆에 있어야 할까요? 그렇게 제한하면 옆자리를 다른 요청이 사용하고 있을 때 다시 확장이 어려워집니다. 토큰을 읽는 순서와 실제 메모리에 저장된 위치를 분리하면 서로 떨어진 빈 블록도 사용할 수 있습니다.
먼저 B와 C가 한 번 실행을 마친 시점으로 넘어가겠습니다. B의 KV는 7개, C의 KV는 6개입니다. B의 KV를 토큰 위치 순서대로 네 개씩 나누면, 첫 블록에는 위치 0부터 3까지, 두 번째 블록에는 위치 4부터 6까지가 들어갑니다. 이렇게 요청 안의 순서로 구분한 것을 논리 블록이라고 하겠습니다. 첫 논리 블록을 L0, 두 번째를 L1이라고 표시합니다.
반면 물리 블록은 GPU 메모리에 실제로 확보된 저장 공간입니다. 엔진이 관리하는 물리 블록의 모음을 블록 풀(pool)이라고 하겠습니다. 그림에서는 전체 여섯 블록에 P0부터 P5까지 이름을 붙였습니다.
B의 첫 논리 블록 L0를 P3에, 두 번째 L1을 P0에 저장해도 됩니다. 어느 논리 블록이 어느 물리 블록에 있는지를 기록한 표가 블록 테이블(block table)입니다.
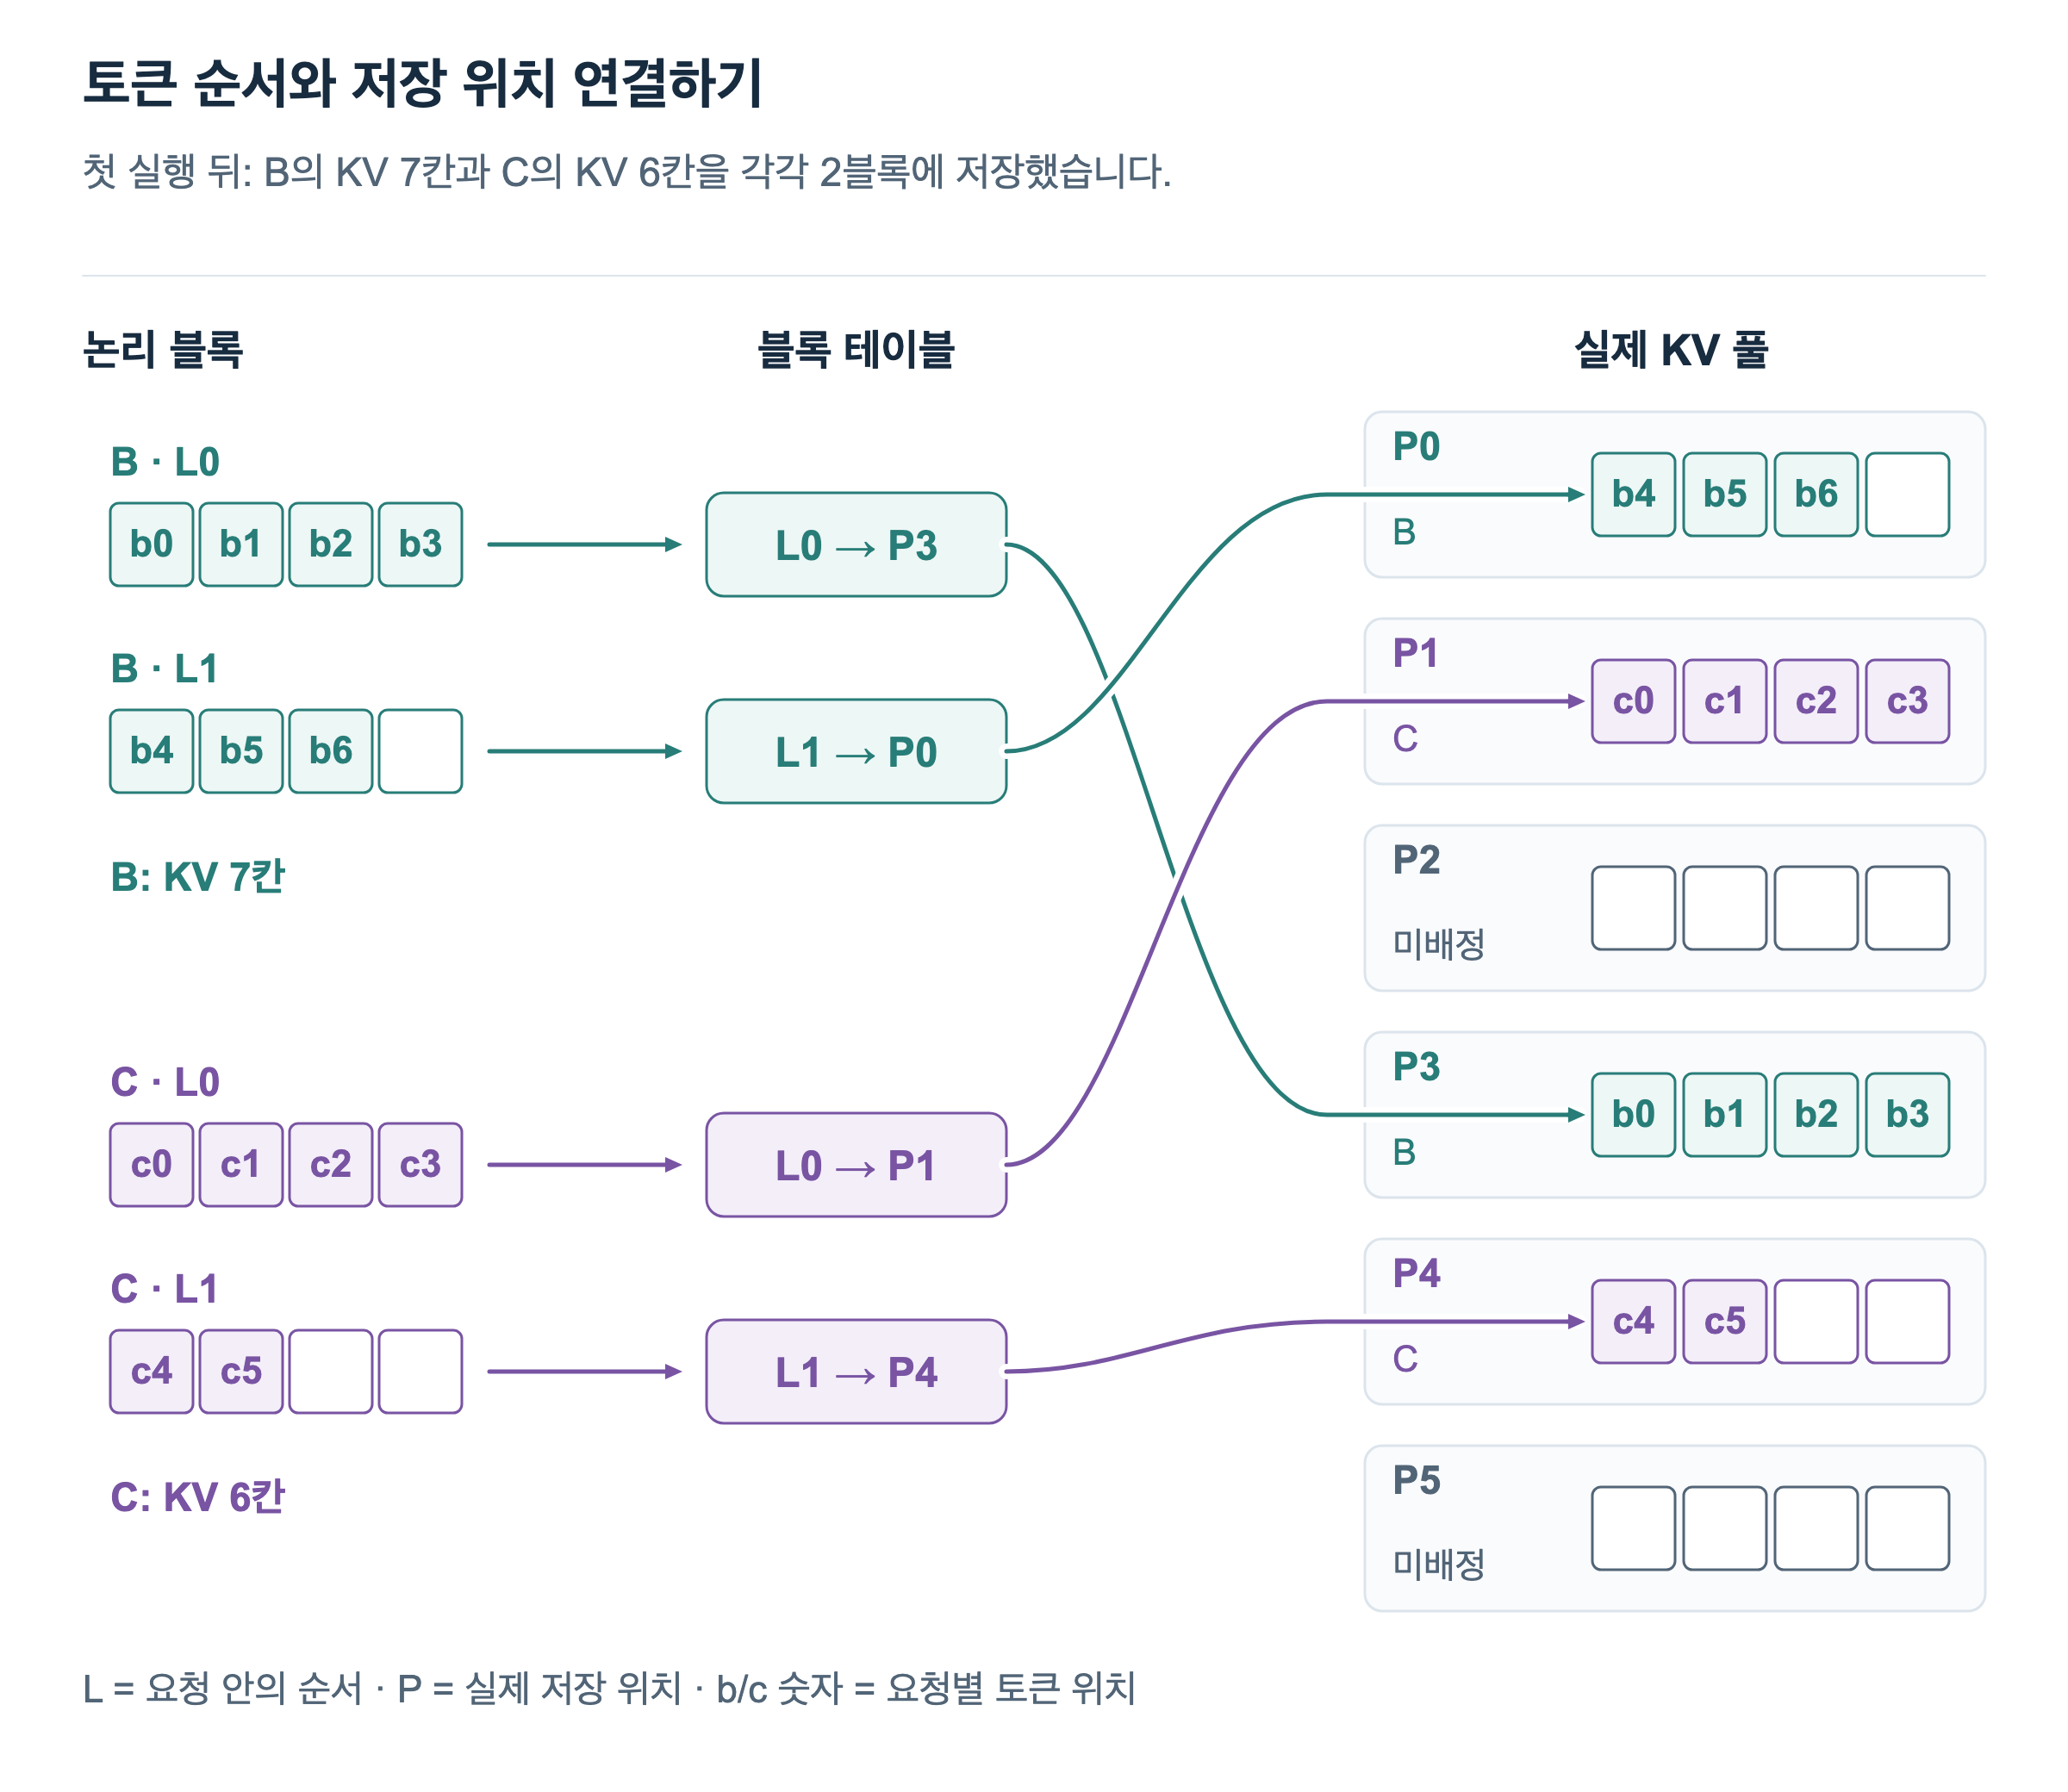
그림 2에서 B의 논리적 순서는 L0 다음 L1이지만, 저장 위치는 P3 다음 P0입니다. C는 별도의 테이블로 자기 블록 P1과 P4를 찾습니다. 왼쪽의 논리 블록과 오른쪽의 물리 블록은 같은 데이터를 서로 다른 관점에서 보여주는 것이며, KV를 두 벌 저장했다는 뜻은 아닙니다.
예를 들어 B의 위치 6에 해당하는 KV를 찾아보겠습니다. 블록 크기가 4이므로 6 ÷ 4의 몫은 1, 나머지는 2입니다. 논리 블록 L1의 세 번째 칸에 있다는 뜻입니다. 테이블에서 L1이 P0에 연결되어 있으므로 P0의 해당 칸을 읽으면 됩니다. 블록과 칸의 위치 번호는 모두 0부터 셉니다.
B의 토큰 위치 6
→ 논리 블록 L1, 블록 안 위치 2
→ 블록 테이블에서 L1 → P0
→ 물리 블록 P0의 위치 2에 있는 KV
블록 테이블이 이 연결을 유지하므로, 요청의 KV 전체를 하나의 큰 연속 공간에 담을 필요가 없습니다. 그림은 이 대응을 보여주기 위해 각 레이어와 어텐션 헤드의 세부 저장 배치는 생략했습니다.
생성에 맞춰 블록 늘리기
이제 B가 생성을 계속하는 동안 공간이 어떻게 늘어나는지 보겠습니다. B는 P3에 KV 4개, P0에 KV 3개를 저장하고 있습니다. 마지막 블록인 P0에는 한 칸이 남아 있습니다. 이번 그림에서는 B의 변화에 집중하고, C의 KV는 6개인 상태로 고정하겠습니다.
B가 다음 입력, 즉 위치 7의 토큰을 처리하면 그 빈칸에 KV를 기록하면 됩니다. KV가 7개에서 8개로 늘어나지만 새 블록은 필요하지 않습니다. 논리 블록과 물리 블록의 연결도 그대로입니다.
그다음 위치 8의 입력을 처리할 때는 기존 두 블록이 모두 차 있습니다. 이때 엔진은 빈 블록 P5를 하나 더 배정하고, 테이블에 L2 → P5를 추가합니다. 새 입력의 KV는 P5의 첫 칸에 기록합니다.
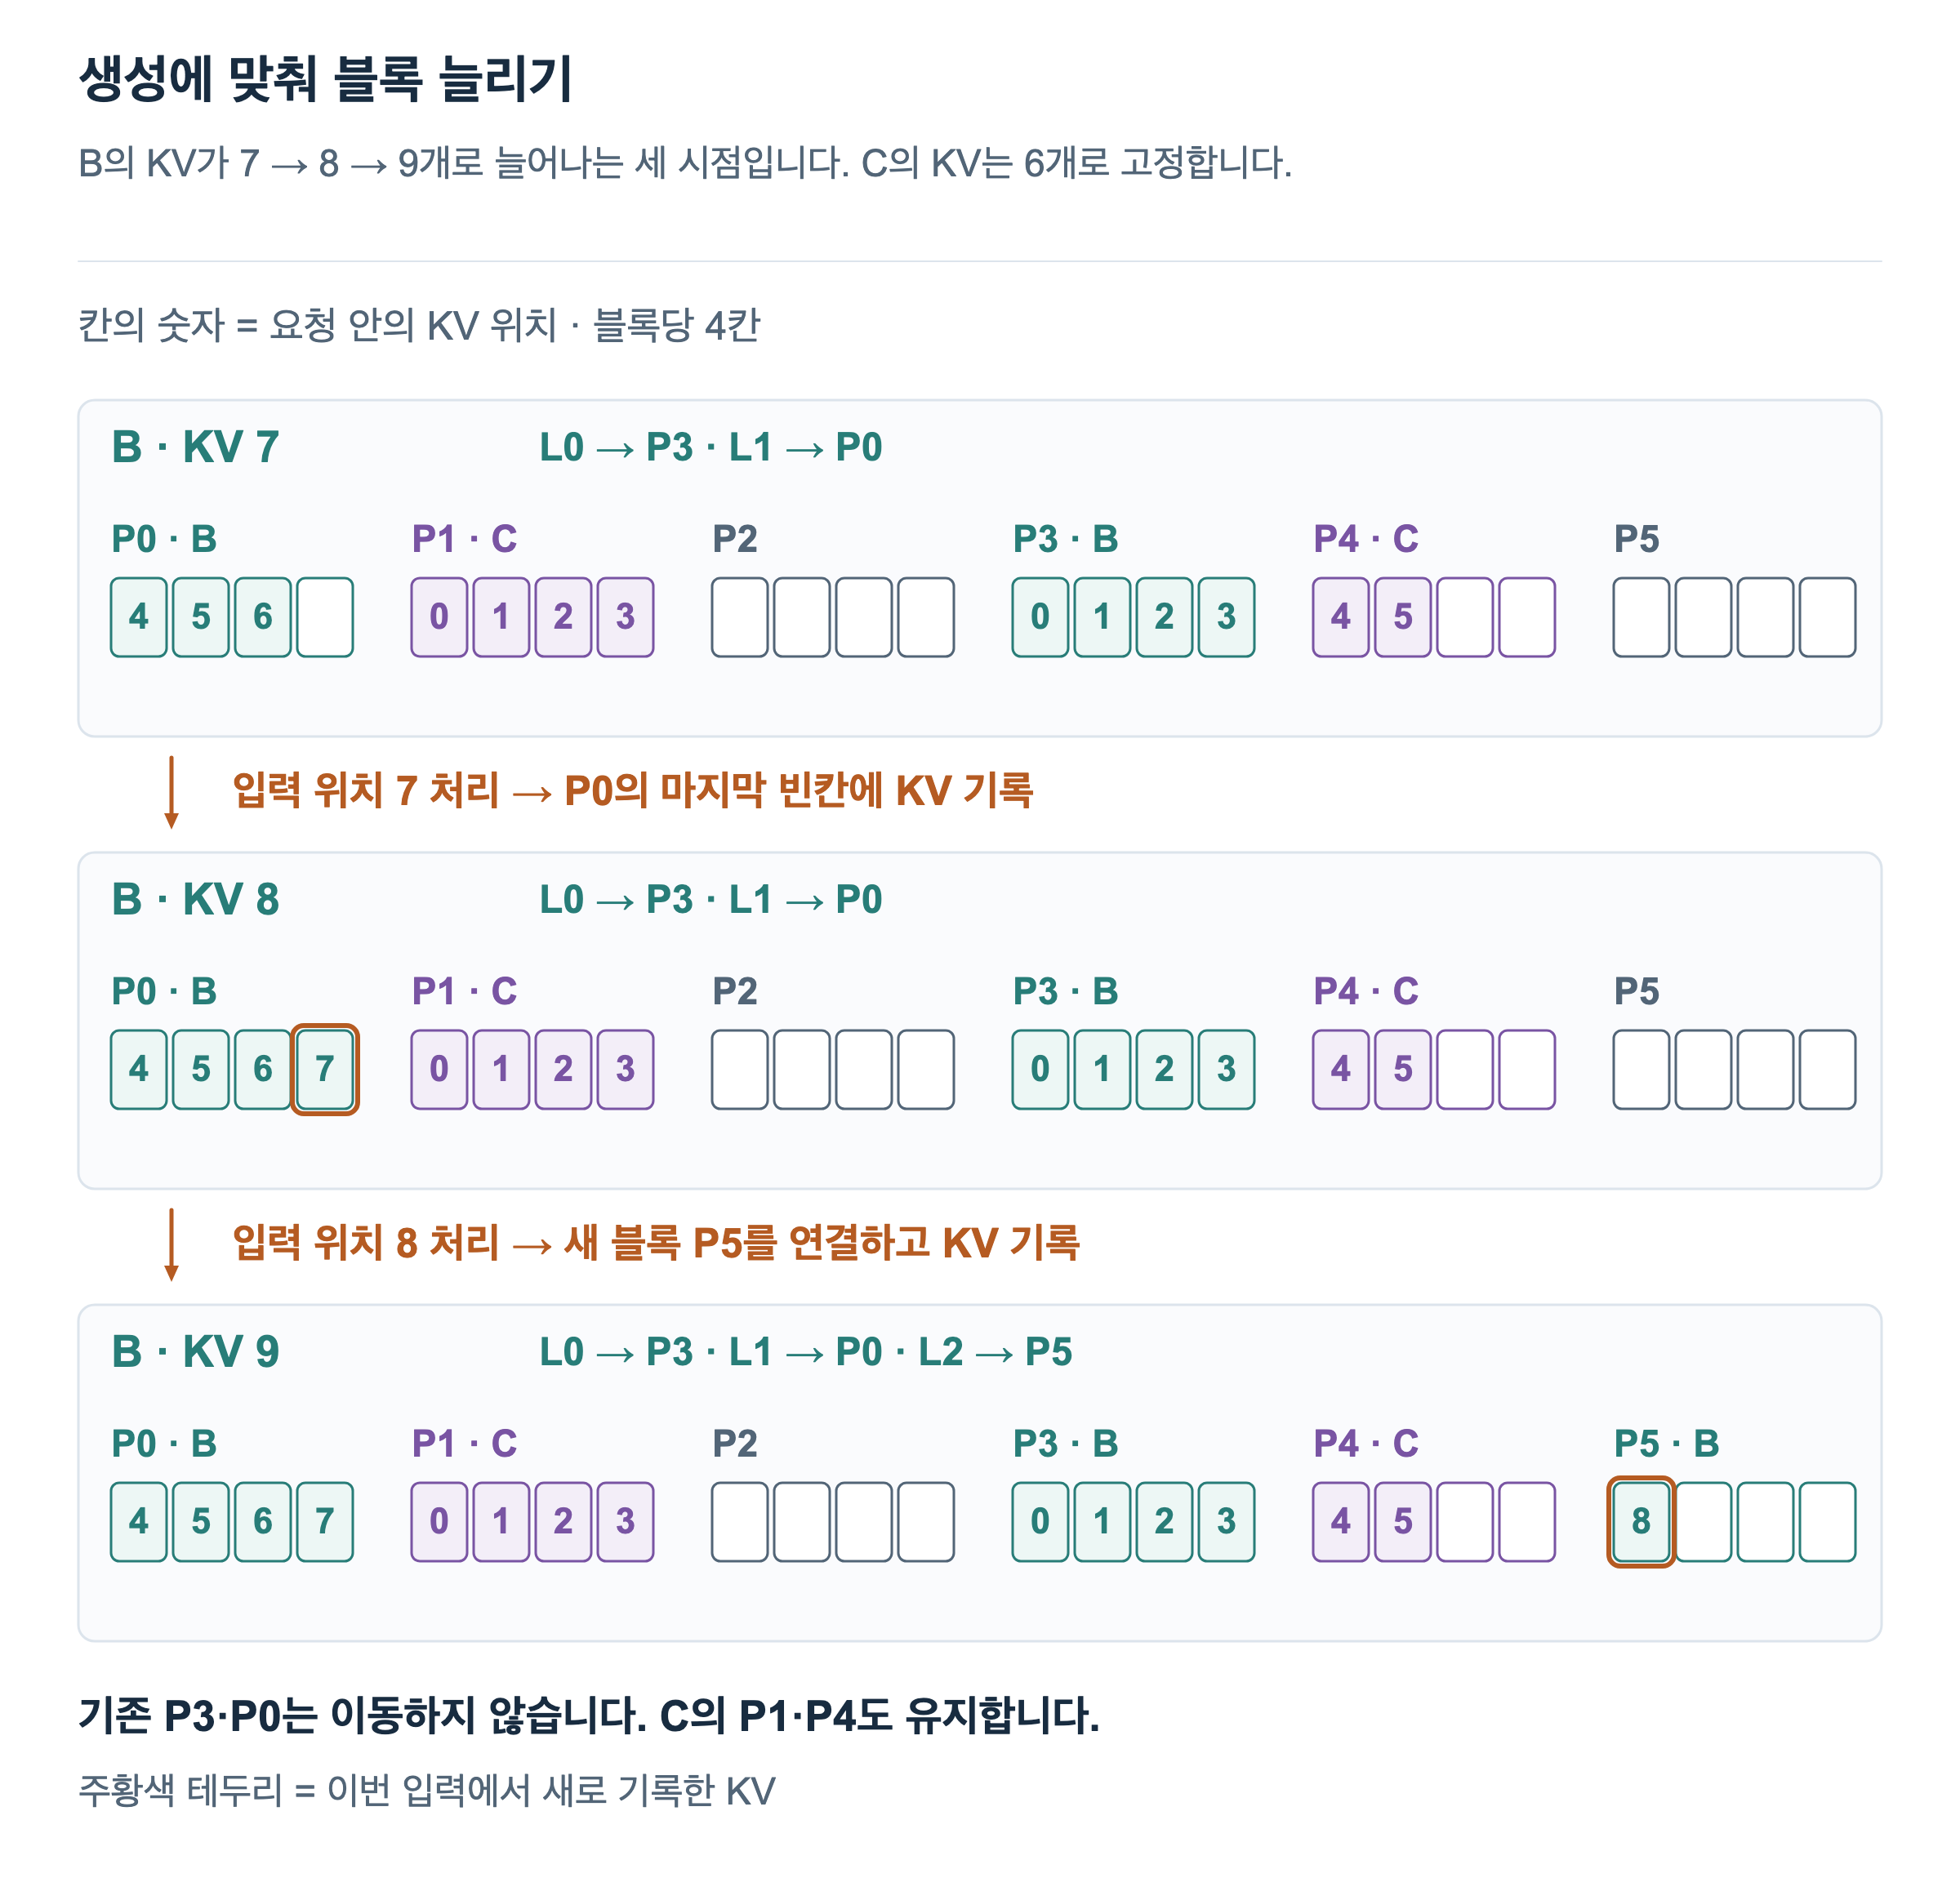
그림 3에서 바뀌는 것은 마지막 빈칸과 새 블록 하나입니다. B의 과거 KV를 더 큰 연속 공간으로 복사할 필요가 없고, C가 쓰는 P1과 P4도 그대로 유지합니다. 저장 공간을 늘리는 단위가 요청 전체가 아니라 블록이 되는 것입니다.
앞서 살펴본 KV 계산의 경계도 같습니다. 이번 실행이 끝나서 다음 출력 토큰을 선택한 순간에는 그 출력의 KV가 아직 없습니다. 그 토큰을 다음 실행의 입력으로 처리할 때 KV가 만들어집니다. 따라서 그림의 7개, 8개, 9개는 각각 입력 처리까지 마쳐 저장한 KV의 수입니다.
이제 스케줄러가 확인할 메모리 조건도 구체적으로 볼 수 있습니다. 마지막 블록에 빈칸이 있으면 새 입력의 KV를 거기에 기록할 수 있습니다. 빈칸이 없으면 추가 블록을 배정할 수 있는지 확인해야 합니다. 새 요청의 경우에는 입력 문맥을 담을 블록이 얼마나 필요한지 확인합니다. 출력이 최종적으로 어디까지 길어질지 전부 알아야만 배정을 시작할 수 있는 것은 아닙니다.
흩어진 KV로 Attention 계산하기
저장 공간을 나누어 배정했다면, Attention을 실행하는 쪽에서도 이 저장 방식을 이해해야 합니다. 하나의 연속된 KV 배열이 있다고 가정하고 읽으면 요청에 필요한 데이터를 찾을 수 없기 때문입니다.
PagedAttention은 블록 테이블을 이용해 서로 떨어진 KV 블록을 참조하면서 Attention을 계산하는 방법입니다. 블록 테이블로 저장 위치를 찾고, 요청의 유효한 문맥 길이로 어느 칸까지 사용할지 판단합니다. 엔진의 블록 관리와 이 계산 방법이 함께 동작해야 합니다. PagedAttention 논문은 이러한 KV 관리와 Attention 실행을 함께 설명합니다.
B의 입력 위치 8을 처리하는 장면을 이어서 보겠습니다. 현재 입력에서 계산한 Q는 B의 위치 0부터 8까지, 총 9개 위치의 KV를 사용합니다. 현재 입력 자신의 KV도 여기에 포함됩니다. 이 KV는 논리적 순서대로 P3에 4개, P0에 4개, P5에 1개가 저장되어 있습니다.
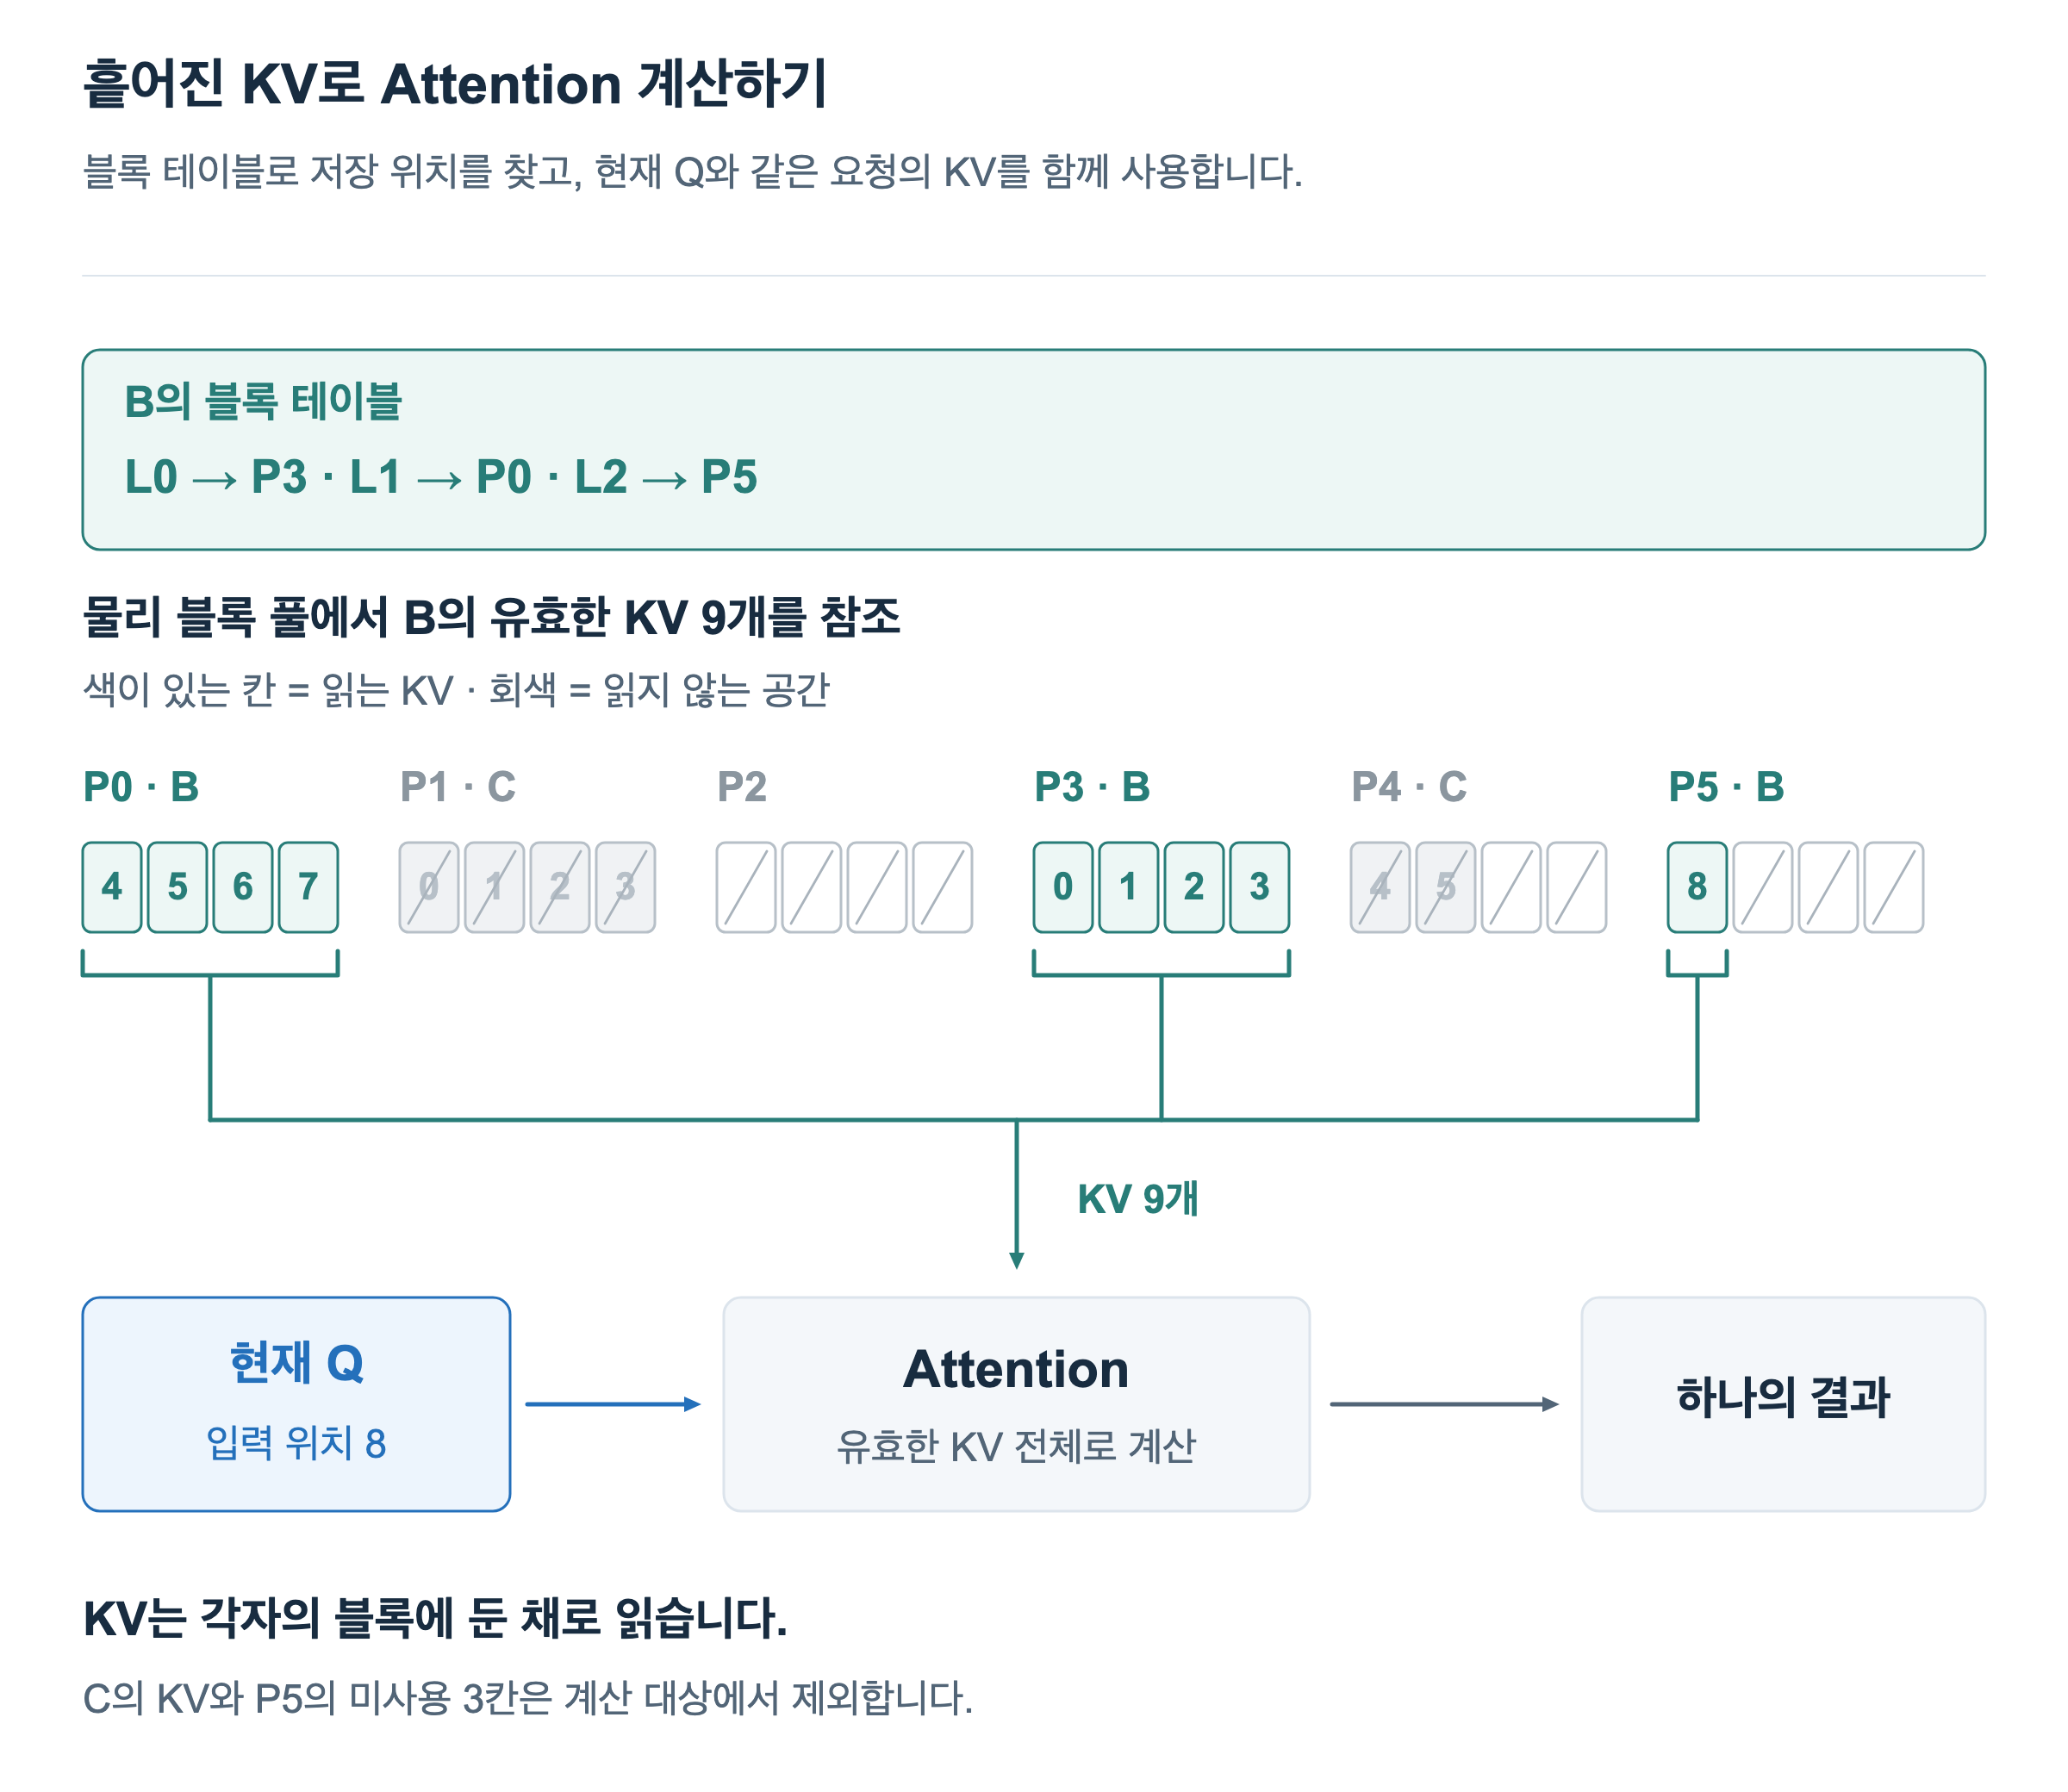
그림 4의 연결선은 Attention에 어떤 KV가 참여하는지를 보여줍니다. 흩어진 KV를 먼저 별도의 연속 버퍼로 복사해 모으는 단계가 아닙니다. KV는 각자의 물리 블록에 둔 채 읽습니다. C의 KV가 저장된 P1과 P4는 B의 계산 대상이 아니며, P5에서도 아직 쓰지 않은 세 칸은 제외합니다.
저장 위치가 달라져도 계산해야 할 Attention의 의미는 같습니다. 현재 Q와 K들의 관계로 가중치를 정할 때는 세 블록에 흩어진 유효한 K 전체를 기준으로 삼습니다. 그 가중치로 V를 결합하므로, 계산 결과는 요청의 유효한 전체 문맥에 대한 Attention입니다.
이렇게 하면 토큰 순서는 유지하면서도 KV 저장 공간은 떨어진 블록으로 배정할 수 있습니다. 메모리를 나누어 관리하는 방식이 실제 모델 실행까지 이어지는 지점입니다. 커널 내부에서 계산을 나누고 합치는 세부 방법은 여기서는 다루지 않겠습니다.
여러 응답의 공통 KV 공유하기
지금까지는 서로 다른 요청 B와 C가 각자의 KV를 보관했습니다. 이번에는 같은 입력에서 여러 응답을 생성하는 경우를 보겠습니다. 하나의 프롬프트에 대해 답변 후보 두 개를 만드는 상황입니다.
새 예시의 입력은 p0부터 p5까지 6토큰이며, 블록 크기는 계속 4입니다. 같은 모델이 같은 입력 문맥을 처리했으므로, 두 응답이 출발점으로 사용하는 입력의 KV는 같습니다. 이 공통 부분을 공통 접두부, 즉 공통 prefix라고 부릅니다.
가장 단순하게는 응답마다 입력 KV를 따로 복사할 수 있습니다. 그러면 응답 하나에 블록 2개가 필요하므로 두 응답에 총 4개를 사용합니다. 하지만 두 응답이 같은 KV를 읽기만 하는 동안에는 실제 데이터를 두 벌 둘 필요가 없습니다. 응답별 블록 테이블이 같은 물리 블록을 가리키도록 하면 한 벌의 KV를 함께 사용할 수 있습니다.
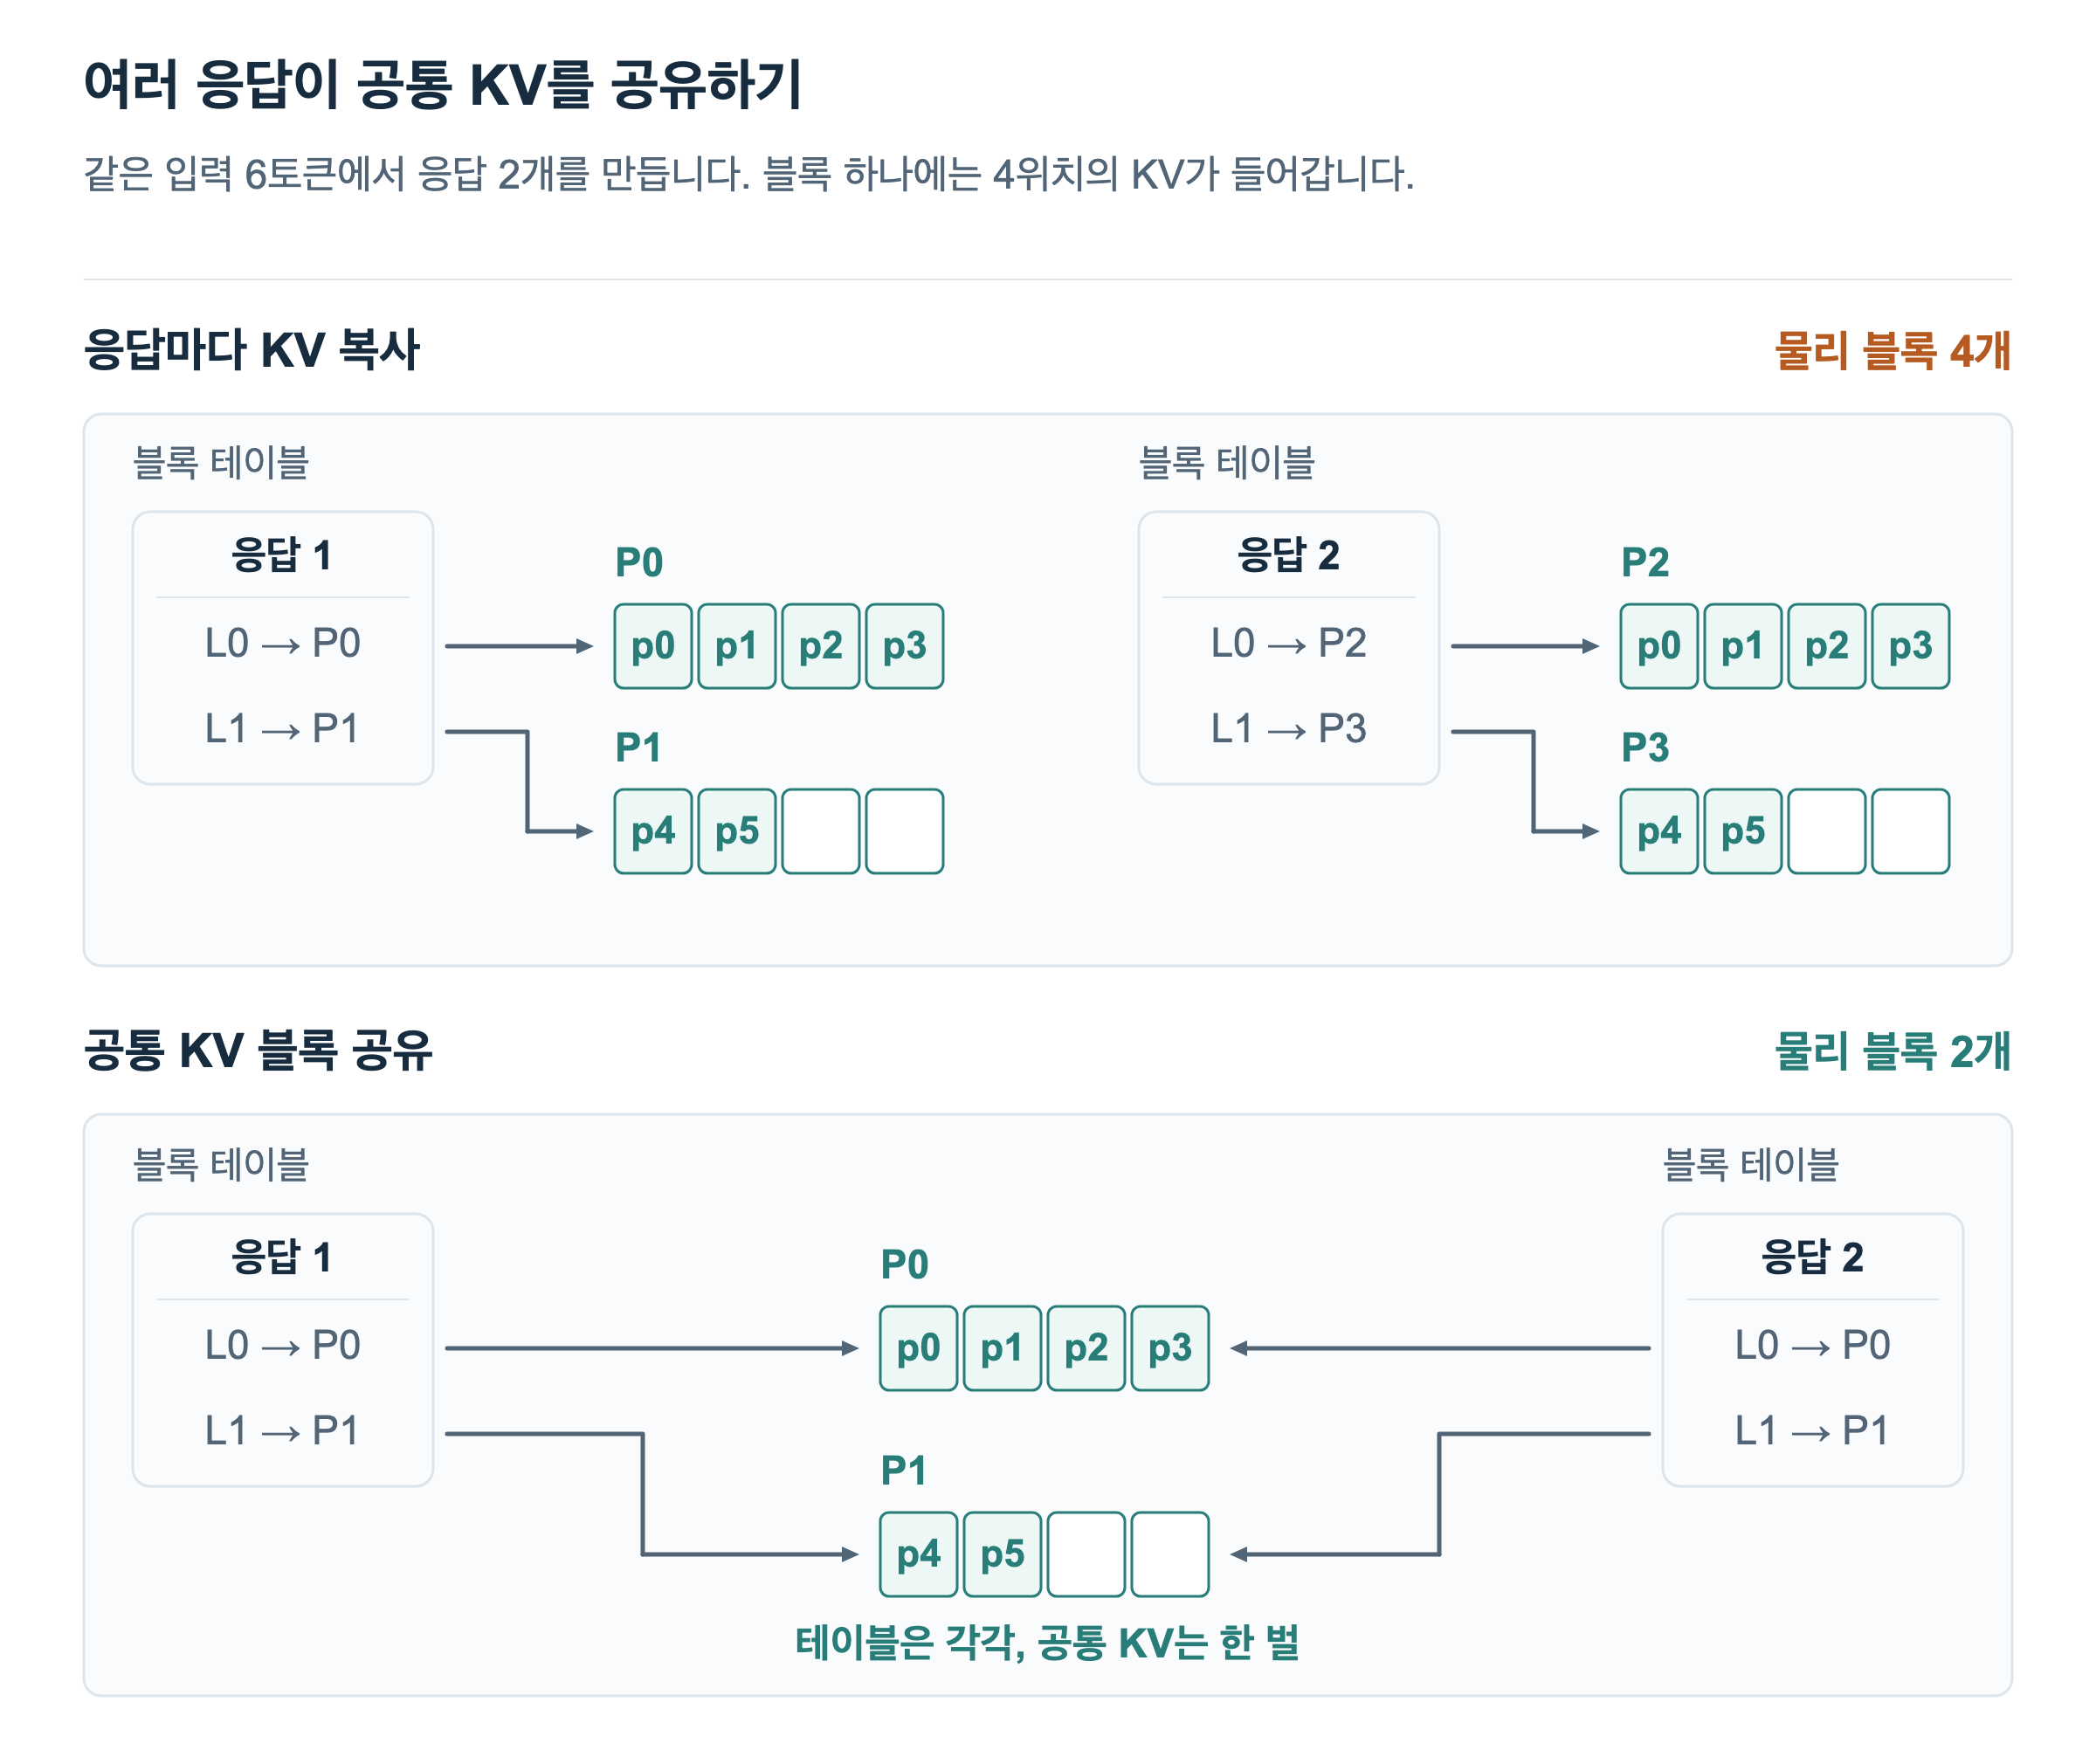
그림 5의 아래쪽에서 P0에는 p0부터 p3까지의 KV가, P1에는 p4와 p5의 KV가 있습니다. 두 응답 모두 자기 테이블의 L0를 P0에, L1을 P1에 연결합니다. 입력 KV를 보관하는 물리 블록은 4개에서 2개로 줄어듭니다.
공유할 수 있는 이유는 입력이 문맥의 처음부터 같기 때문입니다. 서로 다른 문맥에 우연히 같은 단어가 등장했다고 해서 그 위치의 KV가 같아지는 것은 아닙니다. 또한 공유하는 것은 공통 KV의 저장 공간입니다. 이후 응답마다 새 입력과 Q가 달라지면, 각 응답의 Attention 계산은 자기 Q와 문맥에 맞게 수행해야 합니다.
여기서는 같은 입력에서 함께 출발한 여러 응답을 다룹니다. 나중에 별도로 들어온 요청에서도 공통 prefix를 찾아 기존 KV를 사용하는 방법은 후속 Prefix caching 글에서 살펴보겠습니다.
쓰기가 필요할 때 공유 블록 분리하기
공통 KV를 읽기만 할 때는 같은 블록을 가리켜도 문제가 없습니다. 하지만 생성이 진행되어 새 KV를 기록해야 하면 상황이 달라집니다.
그림 5에서 마지막 블록 P1에는 p4와 p5의 KV가 있고 두 칸이 비어 있습니다. 응답 1은 새 입력 a0를, 응답 2는 새 입력 b0를 처리한다고 하겠습니다. 두 응답이 그대로 P1을 공유한 채 다음 빈칸에 쓰면, 서로 다른 KV를 같은 메모리 위치에 기록하게 됩니다. 비어 있는 칸도 두 응답이 함께 가리키는 하나의 물리 공간이므로 각자의 KV를 따로 보관할 수 없습니다.
이때는 쓰기가 필요한 공유 블록을 복사하고, 쓰려는 응답의 테이블을 새 블록에 연결합니다. 이렇게 공유하던 데이터를 실제로 수정해야 할 때 복사하는 방식을 Copy-on-write라고 합니다.
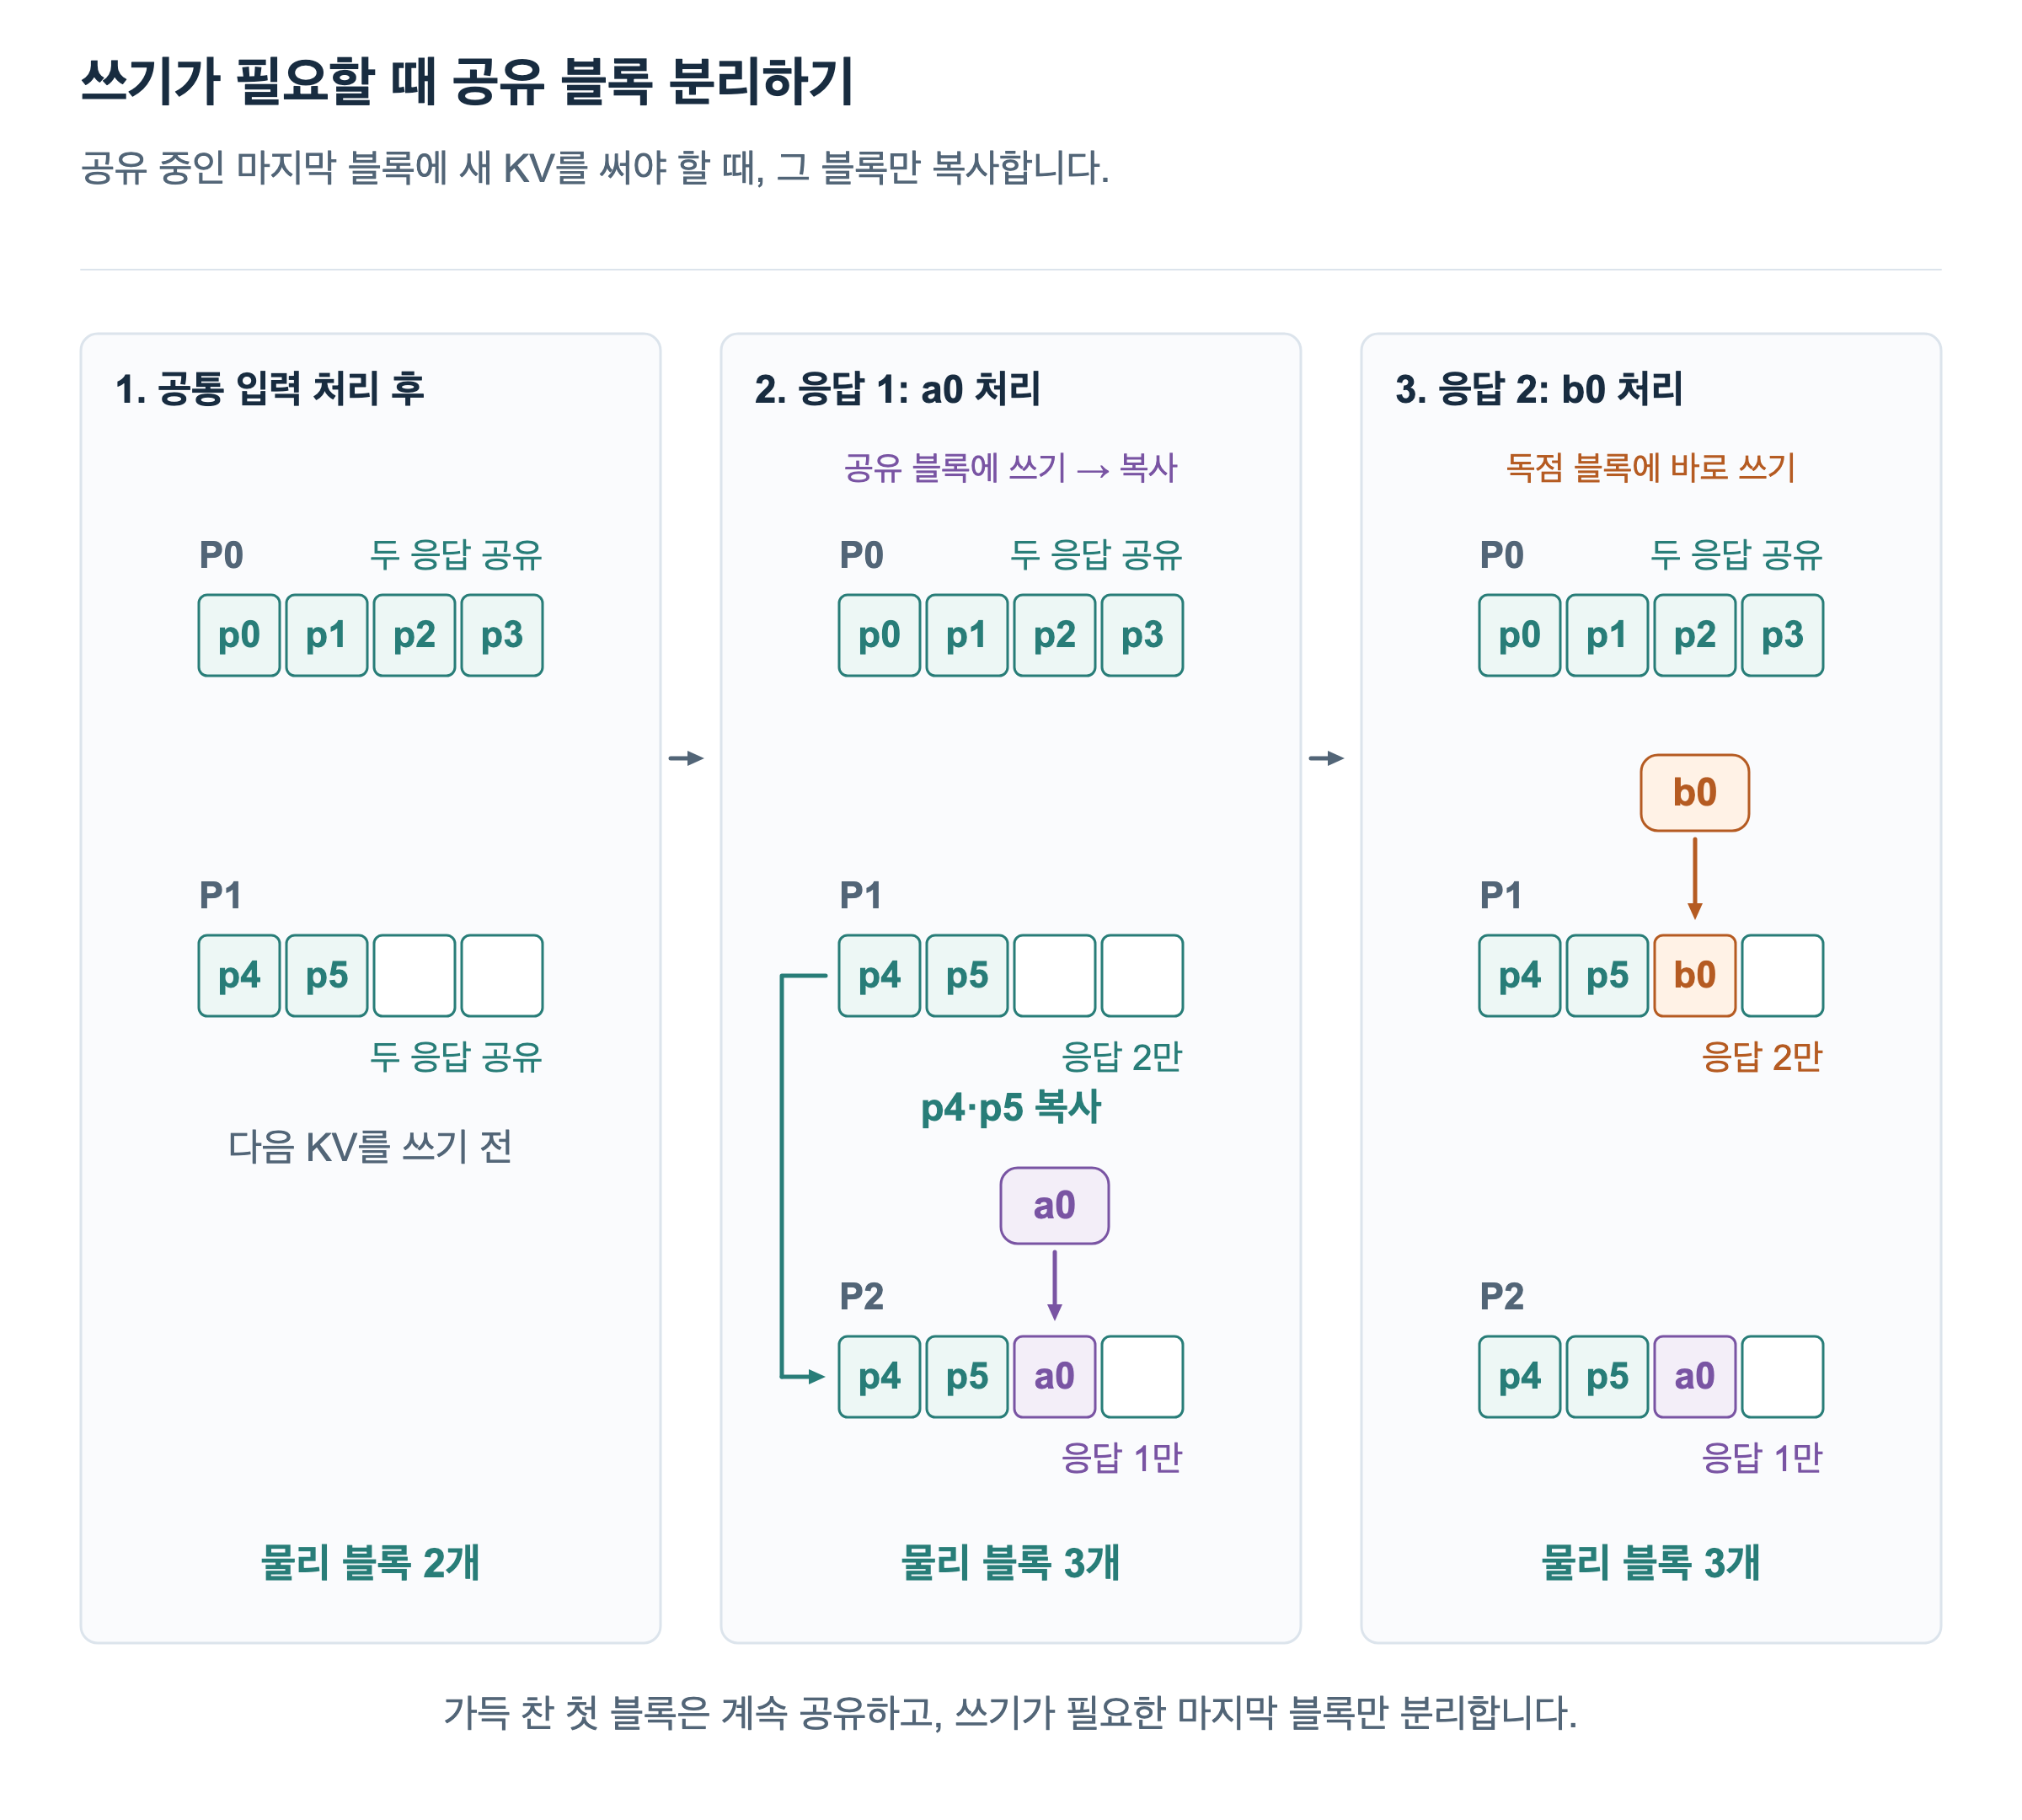
그림 6의 변화를 순서대로 보겠습니다.
- 공통 입력 처리를 마칩니다. 두 응답이 P0와 P1을 함께 가리킵니다. 물리 블록은 총 2개입니다.
- 응답 1의 a0를 처리합니다. 엔진은 P1을 새 블록 P2로 복사해 기존 p4와 p5의 KV를 보존하고, 응답 1의 테이블을
L1 → P2로 바꿉니다. a0에서 계산한 새 KV는 P2의 다음 칸에 기록합니다. 응답 2는 계속 P1을 가리킵니다. - 응답 2의 b0를 처리합니다. 이제 P1은 응답 2만 사용하므로 다시 복사할 필요가 없습니다. P1의 다음 칸에 b0의 KV를 기록합니다.
분리 뒤에도 P0는 두 응답이 공유합니다. P0에 담긴 공통 입력의 KV를 바꿀 필요가 없기 때문입니다. 서로 다른 부분이 들어갈 마지막 블록만 각각 보유하므로 물리 블록은 총 3개입니다. 처음부터 응답마다 모두 복사했을 때의 4개보다 적습니다.
복사가 필요한 시점은 다른 출력 토큰을 선택한 순간 자체가 아닙니다. 그 토큰을 다음 입력으로 처리하면서 여러 응답이 참조 중인 블록에 새 KV를 써야 할 때입니다. 공유한 블록이 이미 가득 차 있다면, 그 블록은 계속 공유하고 각 응답에 다음 블록을 새로 배정하면 됩니다.
요청이 끝난 뒤의 블록 반환
공유를 관리하려면 엔진은 각 물리 블록을 몇 개의 응답이 참조하는지도 알아야 합니다. 이를 참조 수(reference count)라고 합니다. 위 예시에서 P1의 참조 수가 두 개에서 하나로 줄었기 때문에, 응답 2가 추가 복사 없이 자기 KV를 쓸 수 있었습니다.
응답이 끝나면 그 응답의 블록 참조를 해제합니다. 다른 응답이 여전히 사용하는 공유 블록은 유지하고, 더 이상 참조되지 않는 블록은 빈 블록 풀로 돌려줄 수 있습니다. 돌려받은 공간에는 이후 다른 요청의 KV를 기록할 수 있습니다. 여기서는 완료 후 KV를 따로 보관하는 캐시 정책은 가정하지 않습니다.
블록 배정은 아직 사용하지 않을 큰 예약 공간을 줄이고, 블록 공유는 같은 KV를 여러 벌 저장하는 낭비를 줄입니다. 이렇게 확보한 공간을 활용하면 연속 배칭에서 더 많은 요청의 합류를 검토할 수 있습니다. 다만 필요한 실제 KV가 계속 늘어나면 빈 블록은 결국 부족해질 수 있습니다. 다음 글인 「KV 캐시가 부족할 때: 요청 중단과 재개」에서는 그때 어떤 요청을 잠시 중단하고 어떤 상태를 보존해야 하는지 살펴보겠습니다.