공통 · 하드웨어 · 2026-09-17
서버 사이의 GPU 통신과 CPU의 역할
CPU 메모리의 중간 복사를 줄이는 전달 경로와, 전송의 진행을 돕는 CPU의 역할을 살펴봅니다.
GPU 통신을 수행하는 SM과 복사 엔진에서는 데이터를 옮기는 일을 적합한 장치에 맡겨 계산과의 자원 경쟁을 줄이는 방향을 살펴봤습니다. 이번에는 GPU들이 서로 다른 서버에 있을 때 데이터가 어떤 경로로 전달되는지 알아보겠습니다.
데이터를 중간 메모리에 복사하는 과정을 줄이는 것도 통신을 개선하는 중요한 방향입니다. 먼저 GPU의 데이터를 CPU 메모리에 옮긴 뒤 네트워크로 보내는 경로를 살펴보겠습니다. 이어서 네트워크 장치가 GPU 메모리에 직접 접근해 중간 복사를 줄이는 방법을 설명합니다. 마지막으로 데이터가 CPU 메모리를 거치지 않더라도 CPU가 전송을 요청하고 진행을 확인할 수 있다는 점을 구별하겠습니다.
CPU 메모리를 거쳐 서버 밖으로 전달하기
한 서버 안의 GPU들이 데이터를 주고받으려면 서로 연결되어 있어야 합니다. 다른 서버로 데이터를 보낼 때는 서버 밖으로 이어지는 연결도 필요합니다. 여기서는 두 서버가 네트워크로 연결된 구성을 살펴보겠습니다.
각 서버에서 네트워크로 데이터를 보내고 받는 하드웨어를 NIC(Network Interface Card)라고 합니다. 흔히 네트워크 카드라고 부르는 장치입니다. NIC는 전송할 데이터를 메모리에서 읽어 네트워크로 내보내고, 받은 데이터를 메모리에 쓰는 역할을 합니다.
예시는 GPU 0의 계산 A가 x = [1, 2, 3, 4]를 만들고, GPU 1의 계산 B가 받은 값을 두 배로 만드는 작업입니다. 이번에는 GPU 0은 서버 0에, GPU 1은 서버 1에 있습니다. B가 사용할 x를 서버 사이로 전달해야 합니다.
먼저 CPU 메모리를 중간 버퍼로 사용하는 경로를 보겠습니다. CPU 메모리는 서버의 시스템 메모리이고, 중간 버퍼는 최종 목적지로 전달하기 전에 데이터를 잠시 담아 두는 공간입니다. 송신 서버에서는 GPU의 x를 이 공간에 복사한 뒤 NIC가 읽어 보냅니다. 수신 서버에서는 NIC가 받은 데이터를 CPU 메모리에 쓴 뒤 GPU 메모리로 복사합니다.
그림에 나오는 PCIe(PCI Express)는 GPU나 NIC 같은 장치를 컴퓨터 시스템에 연결하는 규격입니다. 서버 안의 장치와 메모리 사이 데이터 이동에 사용됩니다. 서버 사이의 네트워크는 두 NIC를 연결하는 별도의 구간입니다.
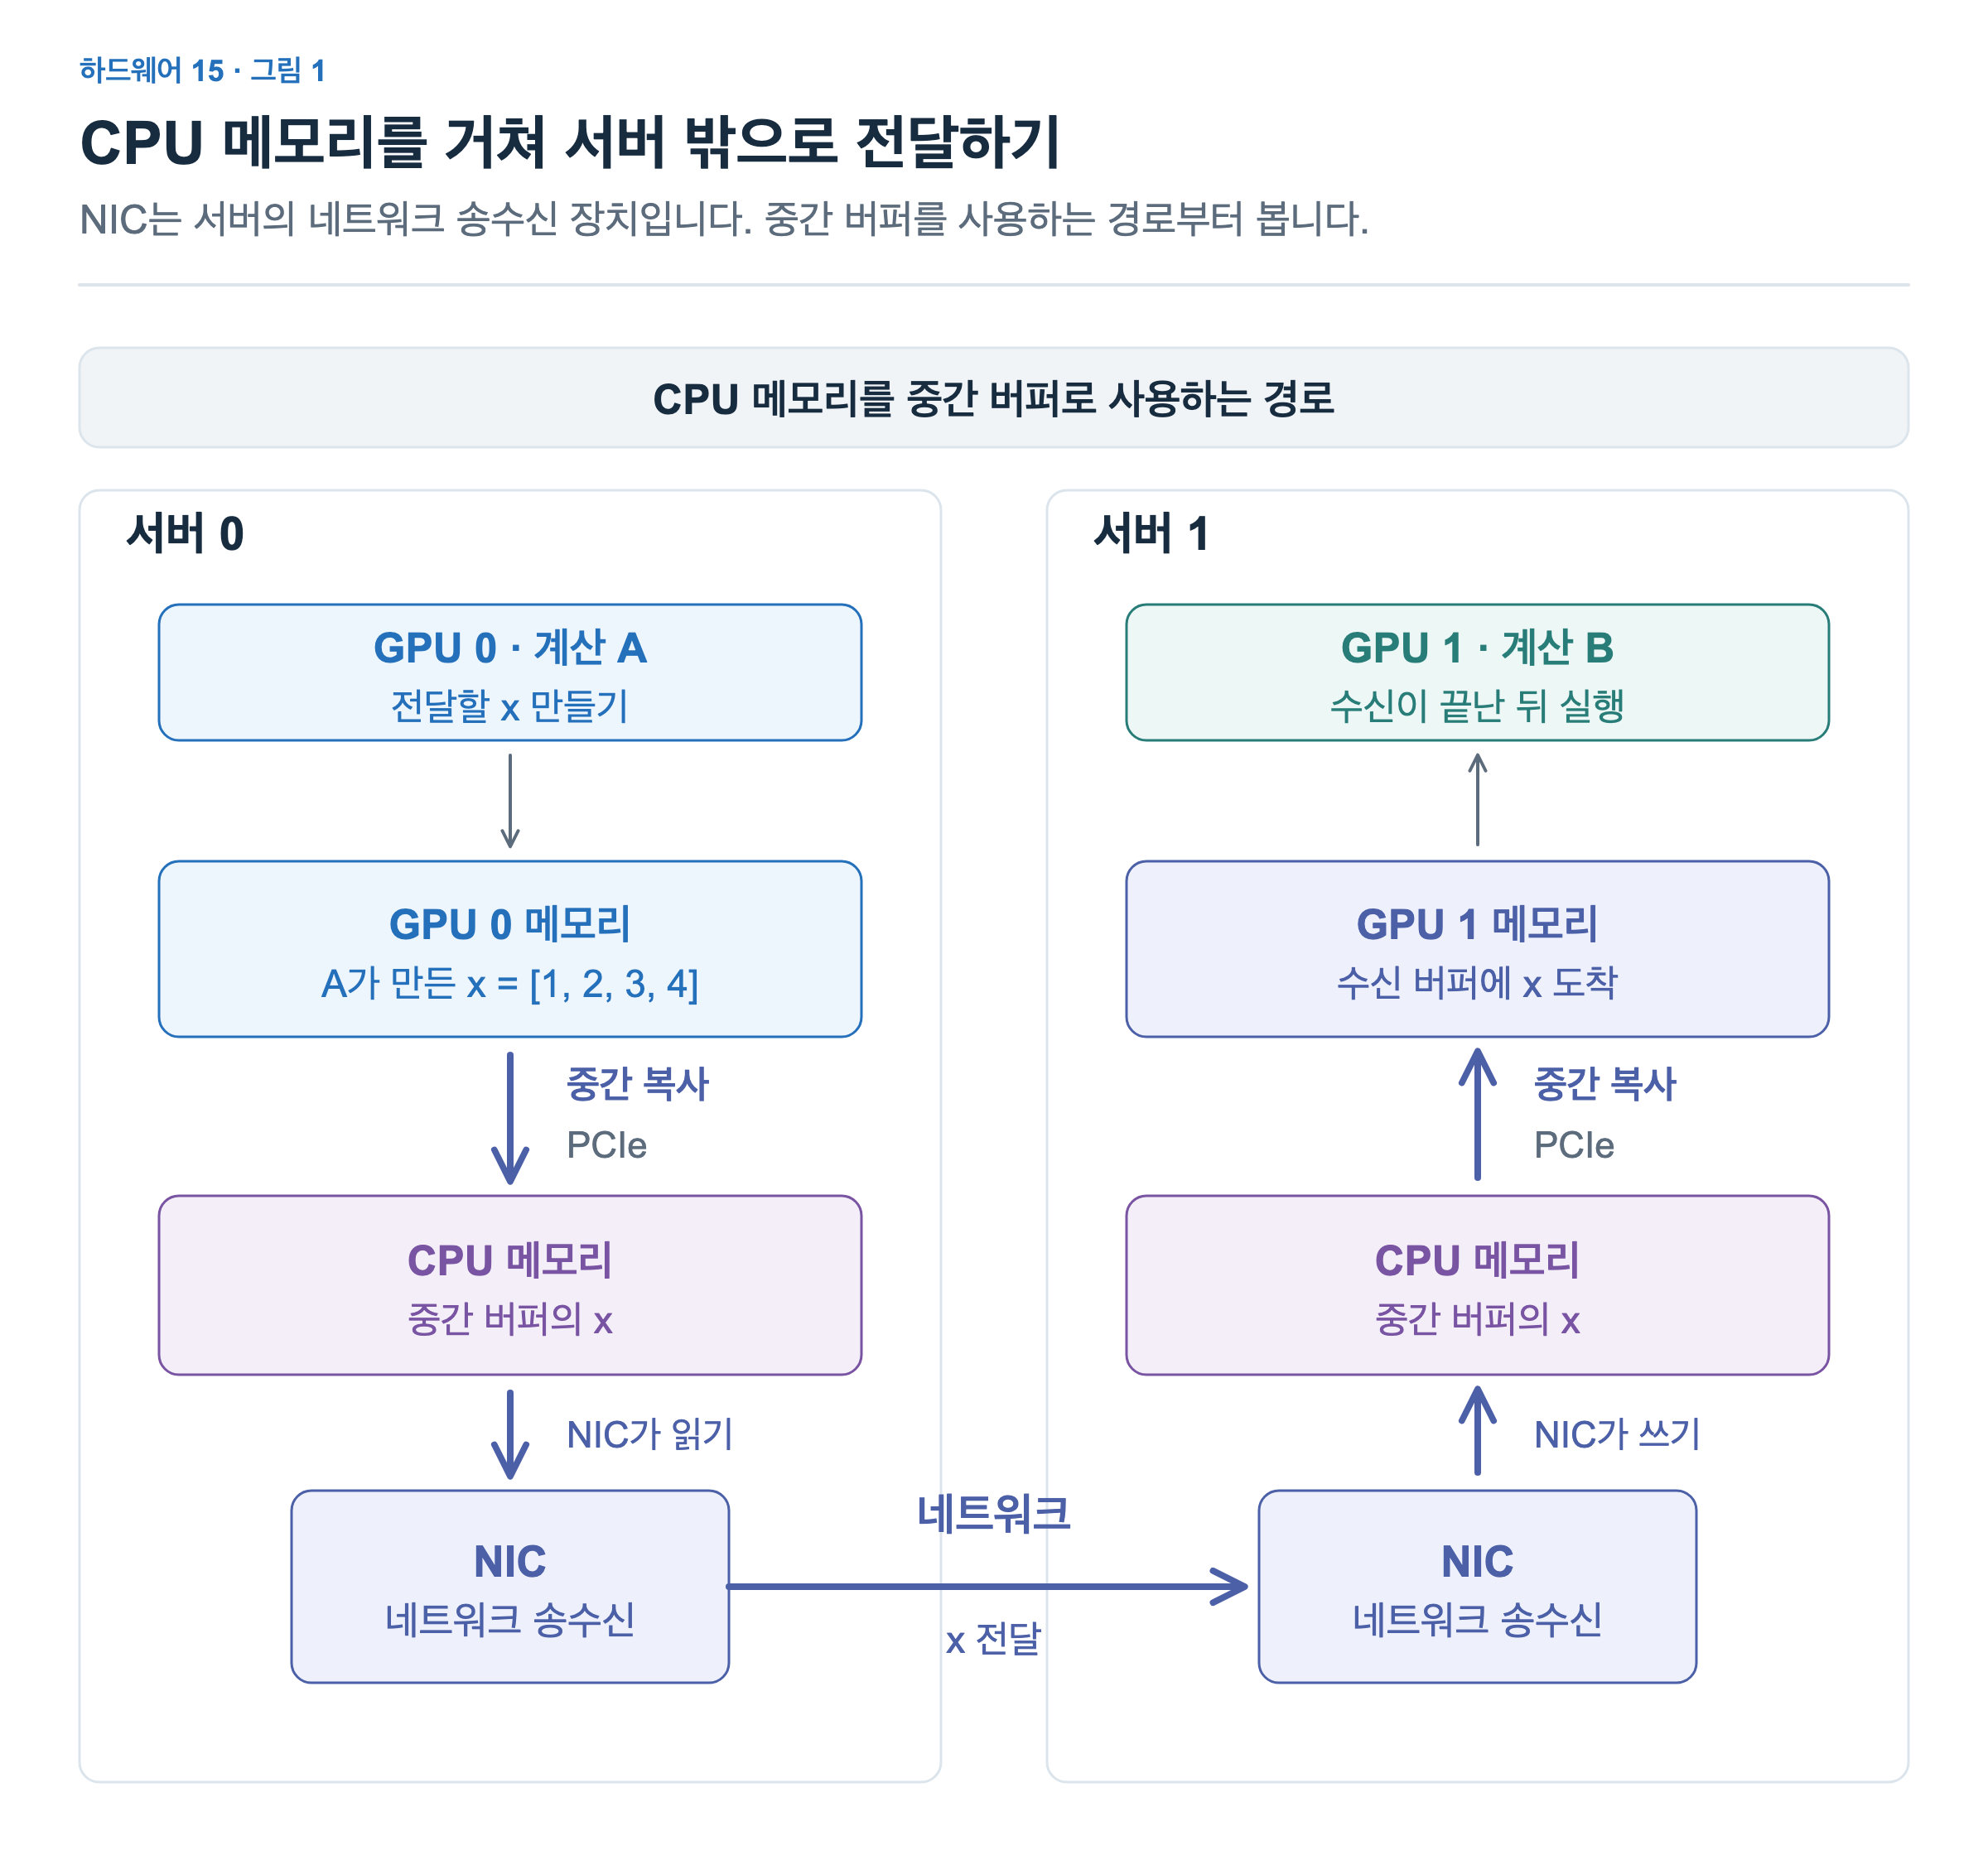
그림 1의 파란 화살표를 따라가면 송신 GPU 메모리에서 출발해 CPU 메모리, 송신 NIC, 네트워크, 수신 NIC, CPU 메모리를 거쳐 수신 GPU 메모리에 도착합니다. 값이 수신 GPU에서 사용할 수 있는 상태가 된 뒤 B가 실행됩니다.
여기서 CPU 메모리를 사용한다는 것이 CPU의 스레드가 x의 각 원소를 직접 읽고 복사한다는 뜻은 아닙니다. GPU와 CPU 메모리 사이의 복사에는 복사 엔진을 사용할 수 있고, NIC도 메모리를 읽고 쓰는 기능을 갖습니다. 데이터를 담는 위치와 데이터 이동을 수행하는 장치는 구별해야 합니다.
이 경로에서는 네트워크 전송에 더해 송신 GPU에서 CPU 메모리로, 수신 CPU 메모리에서 GPU로 옮기는 작업이 필요합니다. 데이터 일부를 나누어 복사와 전송을 겹칠 수 있더라도 중간 메모리를 읽고 쓰는 작업 자체는 남습니다. 이 중간 복사를 줄일 수 있다면 사용할 메모리 대역폭과 복사 작업의 부담도 줄일 여지가 생깁니다.
중간 복사를 줄이는 GPUDirect RDMA
NIC가 서버 사이의 메모리 전송을 수행하는 기술부터 살펴보겠습니다. RDMA(Remote Direct Memory Access)는 ‘원격 메모리 직접 접근’이라는 뜻입니다. 미리 준비된 메모리 영역 사이에서 네트워크 장치가 데이터를 전달해, CPU가 데이터를 직접 복사하는 부담을 줄입니다. 사용할 메모리와 통신 연결을 준비하고 전송을 요청하는 과정은 여전히 필요합니다. RDMA의 기본 개념
RDMA에서 사용하는 메모리가 반드시 GPU 메모리인 것은 아닙니다. CPU 메모리 사이에서도 RDMA를 사용할 수 있습니다. GPU의 데이터를 CPU 메모리로 먼저 옮기지 않으려면, NIC가 GPU 메모리에도 접근할 수 있어야 합니다.
이를 지원하는 NVIDIA의 기술이 GPUDirect RDMA입니다. 지원되는 환경에서는 NIC가 GPU 메모리에서 전송할 데이터를 읽거나, 네트워크로 받은 데이터를 GPU 메모리에 쓸 수 있습니다. NIC는 실제 장치이고 GPUDirect RDMA는 이러한 접근을 가능하게 하는 기술입니다. 데이터를 옮기는 별도 상자가 하나 더 추가되는 것은 아닙니다. GPUDirect RDMA의 동작과 지원 조건
그림 2는 앞 그림과 GPU 메모리, NIC, 네트워크의 위치를 같게 두었습니다. CPU 메모리의 중간 버퍼를 거치던 부분이 어떻게 달라지는지 보겠습니다.
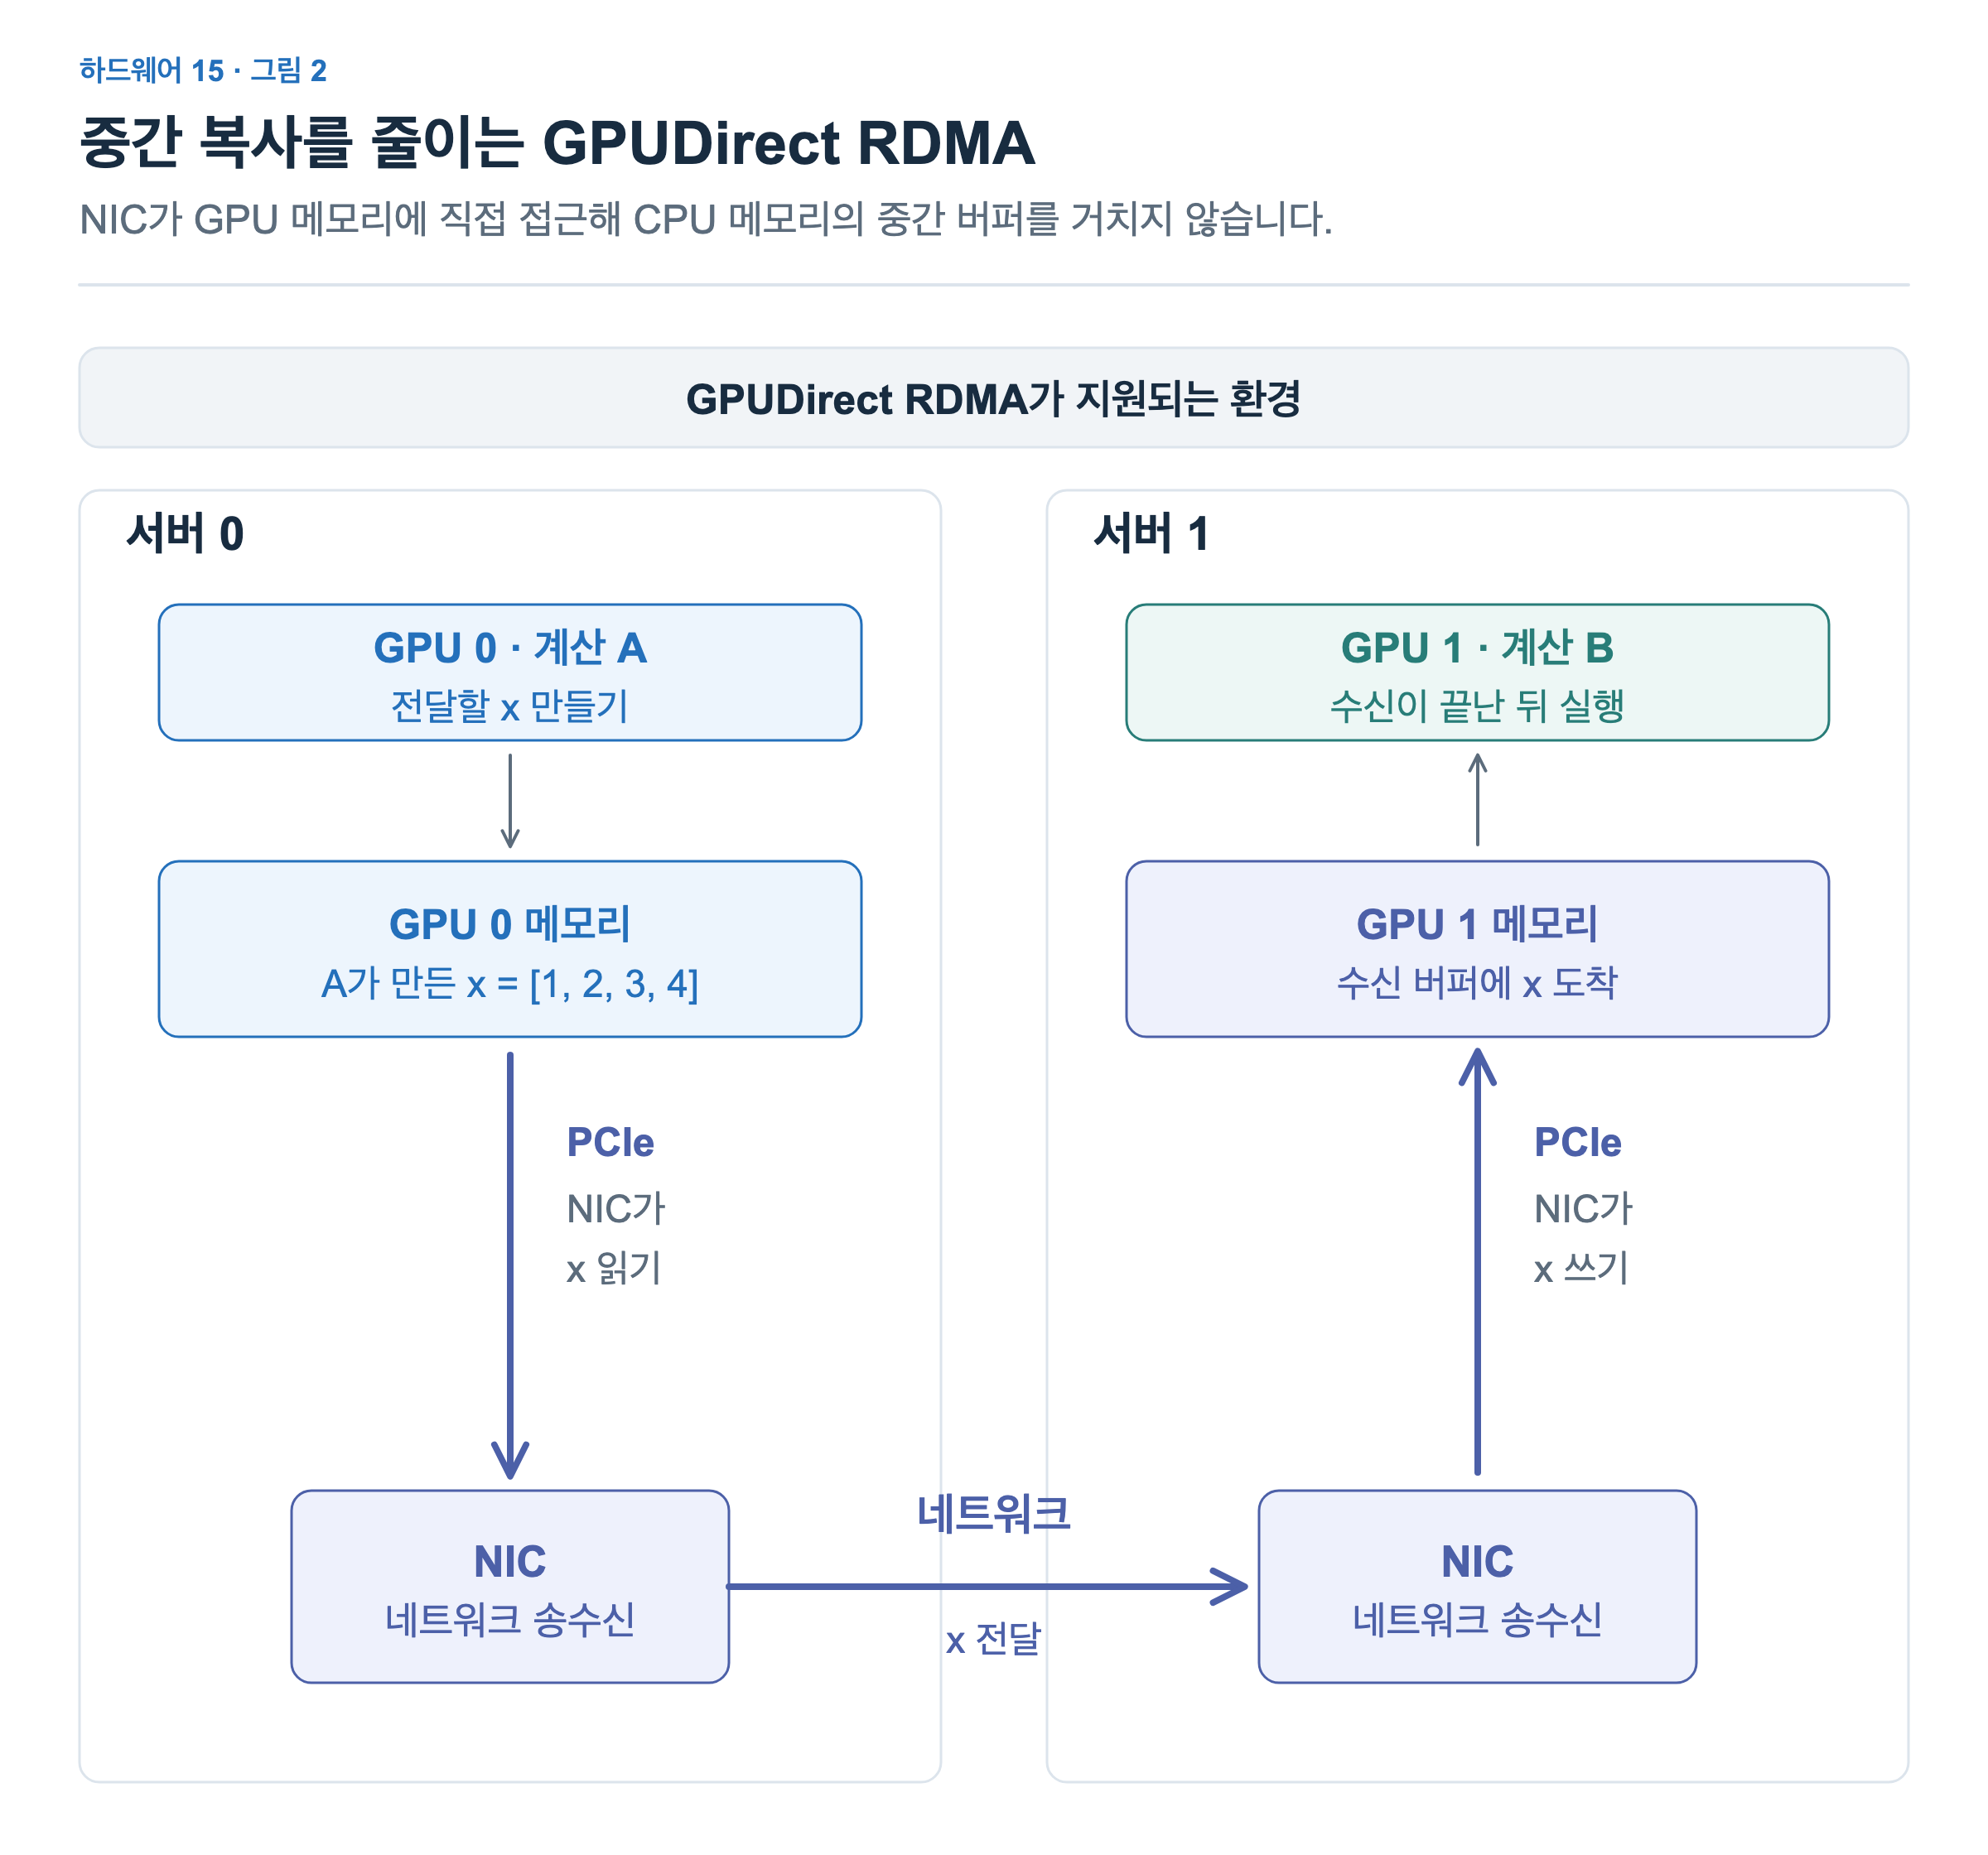
송신 쪽에서는 NIC가 PCIe를 통해 GPU 메모리의 x를 읽어 네트워크로 보냅니다. 수신 쪽에서는 NIC가 받은 값을 GPU 메모리에 씁니다. CPU 메모리를 중간 공간으로 사용하는 복사가 빠진 것입니다. NIC와 네트워크를 지나는 전달 자체는 여전히 필요합니다.
이 직접 접근을 사용하려면 GPU와 NIC, 장치의 연결 구성, 드라이버와 통신 라이브러리의 지원이 맞아야 합니다. 사용할 메모리 영역도 NIC가 접근할 수 있도록 준비해야 합니다. GPU와 NIC가 같은 서버에 설치되어 있다는 사실만으로 모든 버퍼에 이런 접근이 가능한 것은 아닙니다.
직접 전달을 사용해도 계산 사이의 순서는 그대로입니다. A가 x를 준비한 뒤 그 값을 보내야 하고, 수신 GPU에서 x를 사용할 수 있게 된 뒤 B를 실행해야 합니다. 이 순서를 연결하는 원리는 GPU 사이에서 데이터를 전달하기에서 살펴본 것과 같습니다.
이렇게 중간 복사를 줄여도 어떤 데이터를 언제 보낼지 요청하고, 전송이 끝났는지 확인하는 일은 남습니다. NIC가 GPU 메모리에 접근할 수 있다는 것만으로 보낼 데이터와 시점까지 스스로 정하는 것은 아닙니다. 누군가는 데이터가 준비되었는지 확인하고, NIC에 ‘이 위치의 데이터를 이만큼 보내 달라’고 요청해야 합니다. 다음에는 같은 직접 전달 경로에서 이 일을 누가 맡는지 살펴보겠습니다.
전송의 진행을 돕는 CPU 프록시
프로그램의 코드를 CPU에서 실행하는 하나의 흐름을 CPU 스레드라고 합니다. 한 프로세스 안에서 여러 CPU 스레드가 서로 다른 일을 나눠 맡을 수 있습니다.
NCCL은 일부 네트워크 통신 경로에서 별도의 CPU 스레드를 만들어 전송의 진행을 맡깁니다. 사용자가 작성한 코드를 실행하는 스레드는 계산과 통신을 요청하고, NCCL이 만든 스레드는 데이터 준비 상태를 확인하면서 NIC에 전송을 요청하고 완료를 확인합니다. 이렇게 통신을 돕는 역할을 맡아서 ‘보조 스레드’라고 부릅니다. 보조 스레드도 CPU에서 코드를 실행하는 일반적인 스레드이며, 별도의 하드웨어 종류가 아닙니다. 실제 NCCL의 스레드 생성 코드에서도 라이브러리가 이 실행 흐름을 만드는 것을 확인할 수 있습니다.
이 스레드가 맡은 역할을 CPU 프록시(proxy)라고 합니다. ‘CPU’는 그 역할이 CPU에서 실행된다는 뜻이고, ‘프록시’는 다른 작업을 위해 필요한 처리를 대행한다는 뜻입니다. 여기서는 GPU의 통신 작업을 위해 NIC에 전송을 요청하고 완료를 확인하는 일을 대행합니다. 스레드는 코드를 실행하는 형태를, 프록시는 그 스레드가 맡은 역할을 설명하는 말입니다.
사용자 코드를 실행하는 스레드가 NIC의 진행 상황을 계속 확인하는 대신, NCCL이 만든 스레드가 그 일을 맡습니다. 따라서 사용자는 통신을 등록한 뒤 다음 CPU 작업을 이어갈 수 있습니다. 이때 실제 x를 GPU 메모리에서 읽어 네트워크로 보내는 장치는 NIC입니다.
그림 3은 GPUDirect RDMA와 CPU 프록시를 함께 사용하는 경우입니다. 파란 데이터 경로는 앞 그림과 같습니다. 여기에 송신 쪽에서 전송을 요청하고 확인하는 CPU 스레드와 주황 점선을 추가했습니다. 그림의 ‘GPU 진행 상태’는 x의 원소 값과 별도로 주고받는 준비·진행 정보입니다.
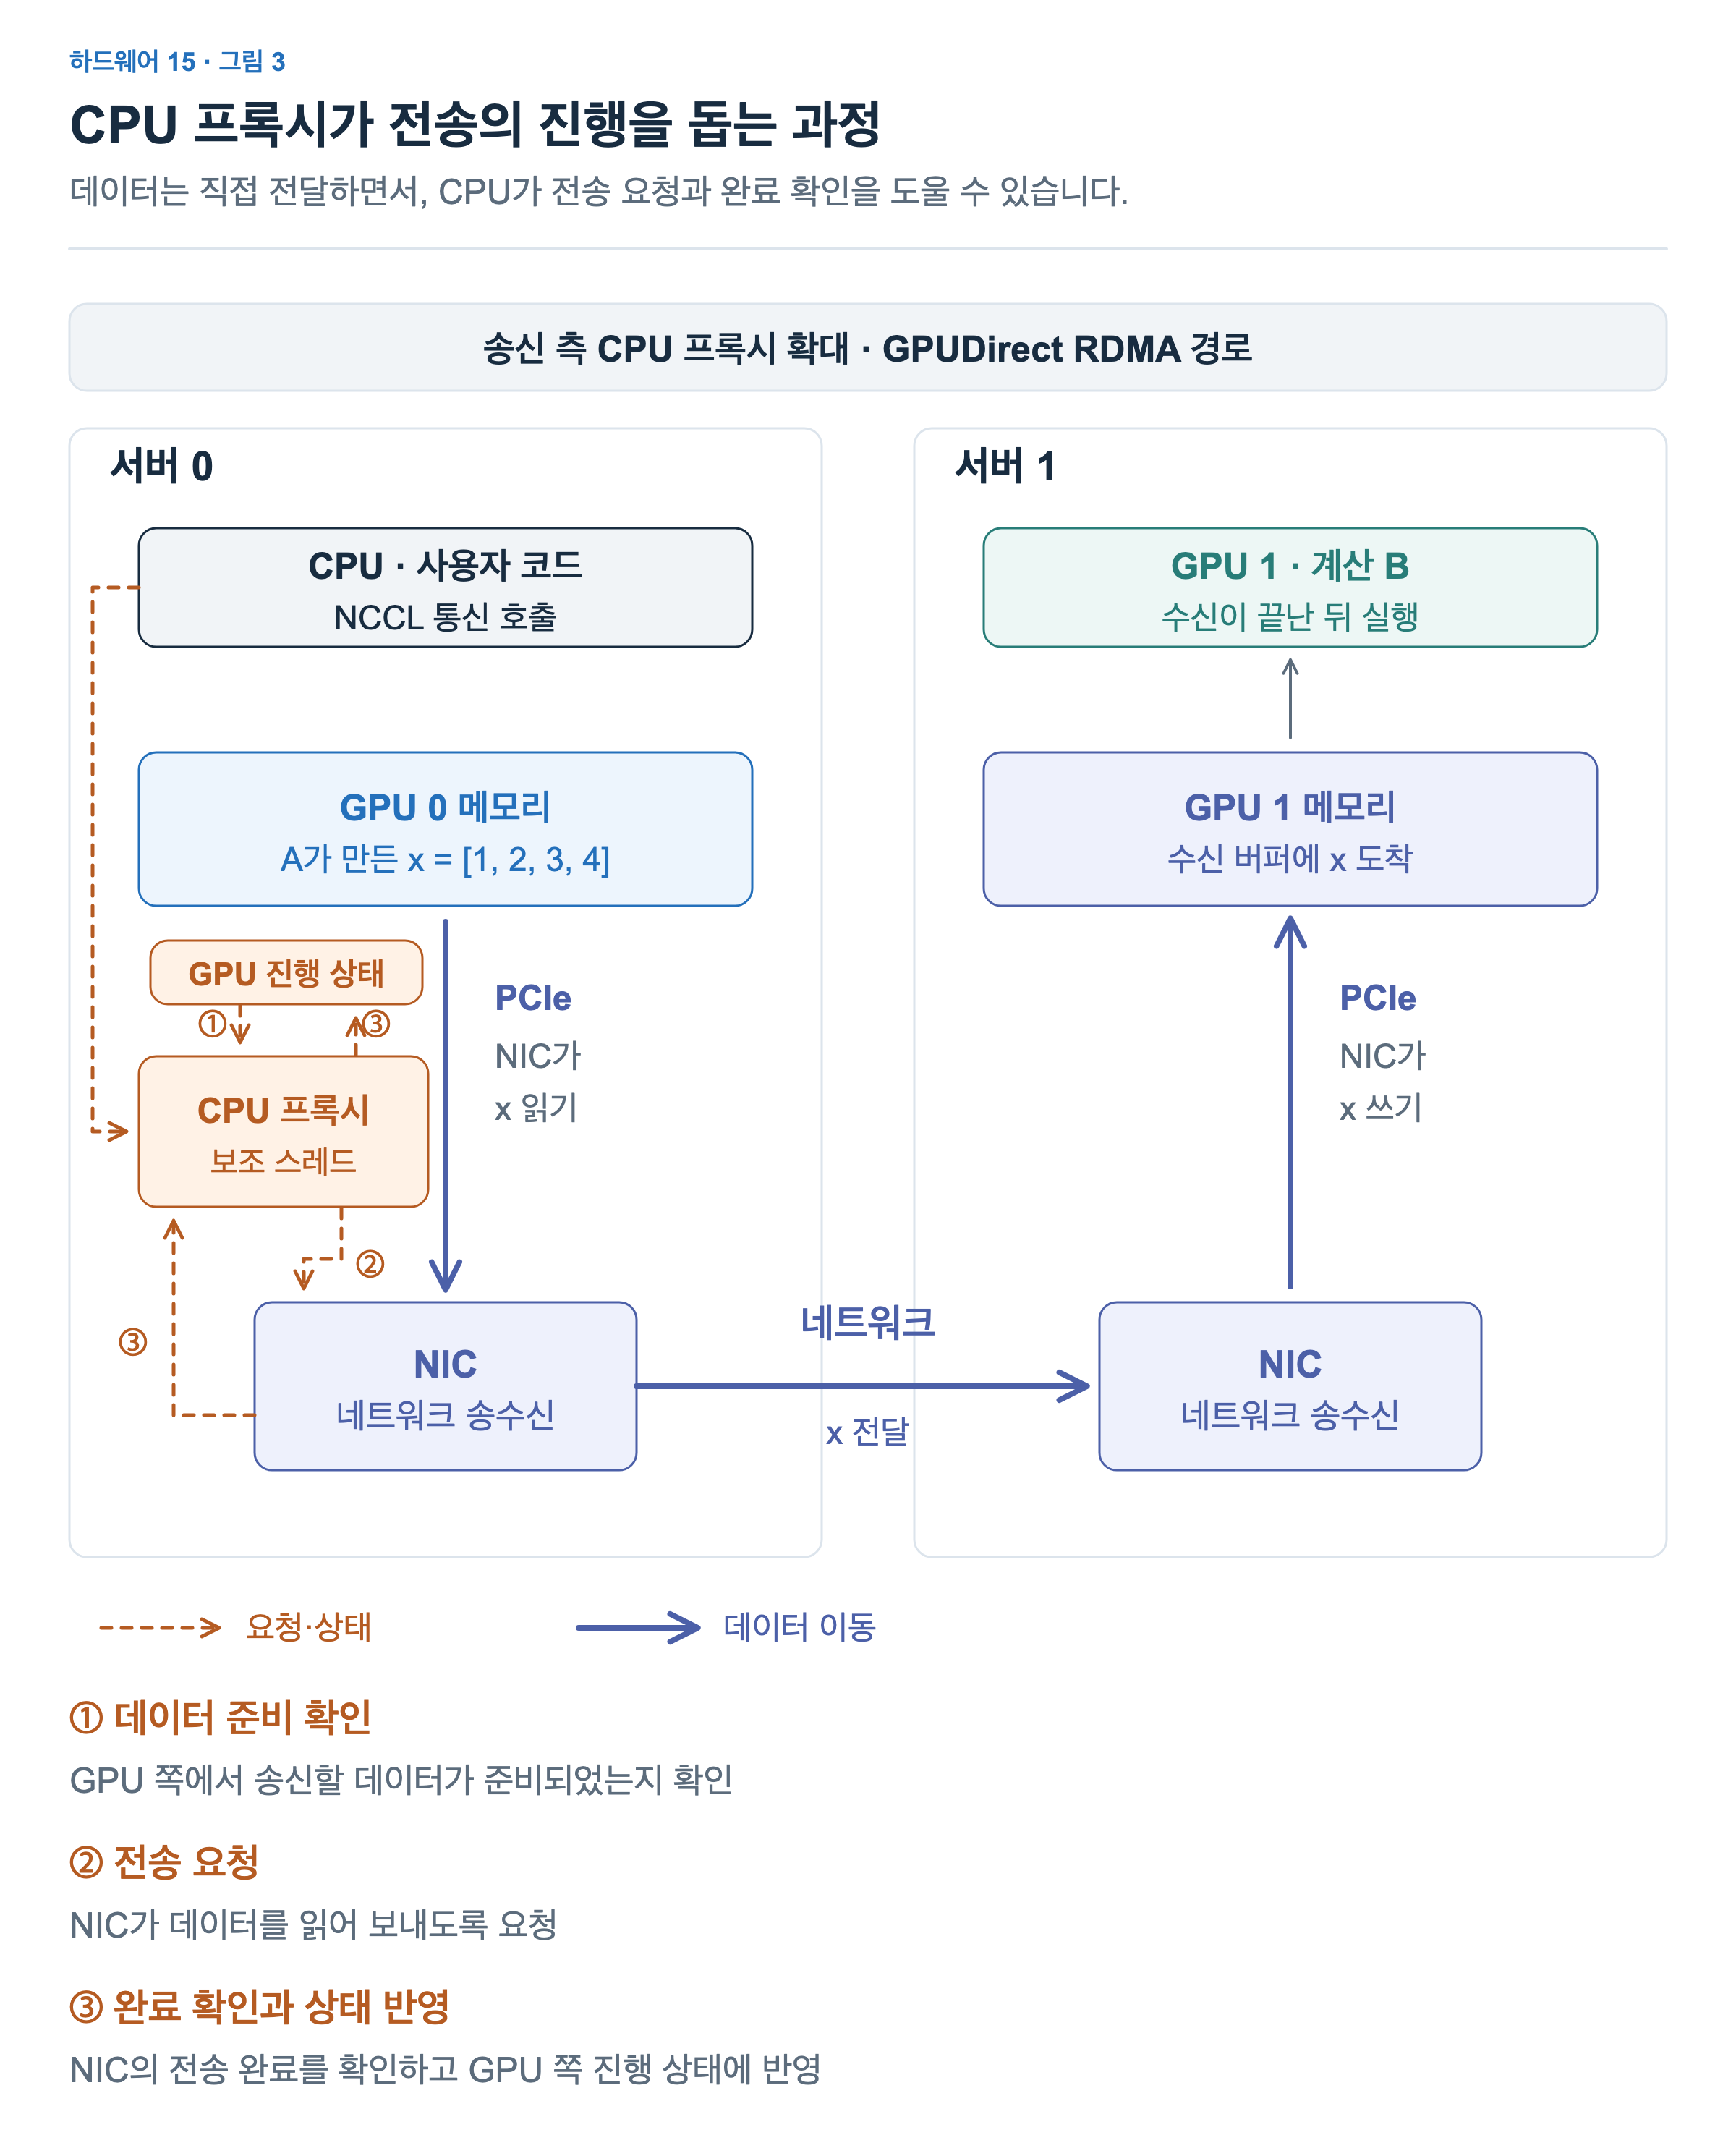
주황 점선의 번호를 따라가면 다음 순서로 읽을 수 있습니다.
- 데이터 준비 확인. CPU 프록시는 GPU 쪽 통신 작업과 공유하는 진행 정보를 확인해 보낼 데이터가 준비되었는지 알아봅니다. x의 각 원소를 CPU에서 검사하는 과정은 아닙니다.
- 전송 요청. 준비된 버퍼와 크기 등의 정보를 바탕으로 NIC에 전송을 요청합니다. 실제 x를 메모리에서 읽어 네트워크로 보내는 일은 NIC가 수행합니다.
- 완료 확인과 상태 반영. 프록시는 전송 요청의 완료를 확인하고, GPU 쪽 통신 작업이 진행 상황을 알 수 있도록 상태를 갱신합니다.
NCCL의 네트워크 전송 구현에서도 데이터 준비 확인, 전송 요청, 완료 확인과 상태 갱신의 관계를 볼 수 있습니다. 실제 구현에서는 큰 데이터를 나누어 보내며 이 과정을 여러 조각에 걸쳐 진행할 수 있습니다. 그림은 송신 쪽 역할에 집중했으며, 수신 쪽에서도 받은 데이터를 GPU가 안전하게 사용하도록 완료를 처리하는 과정이 필요합니다.
여기서 전송 완료를 확인했다는 것이 상대 GPU의 계산 B까지 끝났다는 뜻은 아닙니다. B는 수신 작업이 완료되어 x를 사용할 수 있게 된 뒤 실행하는 별도의 작업입니다. CPU의 호출, 통신의 완료, 후속 계산의 완료는 각각 구별해야 합니다.
이 구조에서는 CPU 프록시가 전송을 요청하고 확인하는 동안, 실제 데이터는 GPU 메모리와 NIC 사이에서 직접 이동합니다. CPU가 제어에 참여하는 것과 CPU 메모리를 데이터의 중간 버퍼로 사용하는 것은 서로 다른 일입니다.
CPU 프록시는 모든 네트워크 통신의 필수 구조는 아닙니다. 지원되는 환경에는 GPU가 NIC에 전송을 직접 요청하는 방식도 있습니다. NCCL의 GPU에서 시작하는 통신 설명은 GPU가 NIC를 직접 제어하는 방식과 CPU 프록시를 활용하는 방식을 구별합니다. 이는 전송을 제어할 때 CPU를 경유하는 부담까지 줄이는 또 하나의 방향입니다.
두 글에서 살펴본 개선은 서로 다른 부분에 적용됩니다. 복사 엔진에 일을 맡기면 SM이 복사를 수행하는 부담을 줄일 수 있고, GPU 메모리와 NIC가 직접 데이터를 주고받으면 CPU 메모리에 중간 복사하는 부담을 줄일 수 있습니다. 전송 요청을 누가 처리하는지는 다시 별도의 선택입니다. 실제 통신을 이해할 때도 데이터를 옮기는 장치, 데이터가 지나가는 경로, 전송을 제어하는 주체를 나누어 보면 역할을 연결하기 쉽습니다.
이제 GPU 사이에서 한 번의 전달이 어떻게 이루어지는지 살펴봤습니다. 다음에는 이런 전달을 여러 GPU에 걸쳐 구성해 데이터를 모으거나 나누고, 같은 값을 여러 곳에 보내는 일을 어떤 통신 연산으로 표현하는지 알아보겠습니다.