추론 · 워크로드 · 2026-09-19
Prefill과 Decode
입력을 함께 처리하는 Prefill과 새 토큰을 하나씩 처리하는 Decode를 비교하고, 처리 토큰 수와 가중치 재사용이 GPU의 병목을 바꾸는 이유를 설명합니다.
추론과 KV 캐시에서는 과거 위치의 K/V를 저장해 반복 계산을 줄이는 방법을 살펴보았습니다. 캐시를 사용하는 생성에서는 처음에 입력 문맥을 함께 처리하고, 이후에는 새 입력 하나를 처리하며 과거 KV를 읽습니다. 이 두 실행을 Prefill과 Decode라고 부릅니다.
두 단계는 같은 모델을 사용하지만, 한 번에 계산하는 토큰 수가 다릅니다. 이번 글에서는 이 차이가 계산량과 가중치 재사용에 어떤 영향을 주는지 살펴보겠습니다. 이어서 Roofline으로 Prefill과 Decode의 병목을 비교하고, 마지막에는 여러 요청을 함께 처리해도 남는 KV 읽기 비용을 짚겠습니다.
Prefill과 Decode의 실행 흐름
Prefill은 주어진 입력 문맥을 처음 처리하는 단계입니다. 입력이 p0 p1 p2 p3이라면 네 위치를 함께 모델에 통과시킵니다. 각 층에서 이 위치들의 K/V를 캐시에 저장하고, 마지막 입력 p3 위치의 예측 점수로 첫 출력 토큰 x0를 선택합니다.
Decode는 새 입력 토큰을 처리해 다음 출력 토큰을 선택하는 단계입니다. Prefill에서 선택한 x0를 다음 입력으로 넣으면, 모델은 그 위치를 계산하면서 저장된 과거 K/V를 참조합니다. 이번에 계산한 x0의 K/V는 캐시에 추가하고, 실행 결과로 다음 출력 x1을 선택합니다. 이어 x1을 입력해 x2를 선택하는 식으로 반복합니다.
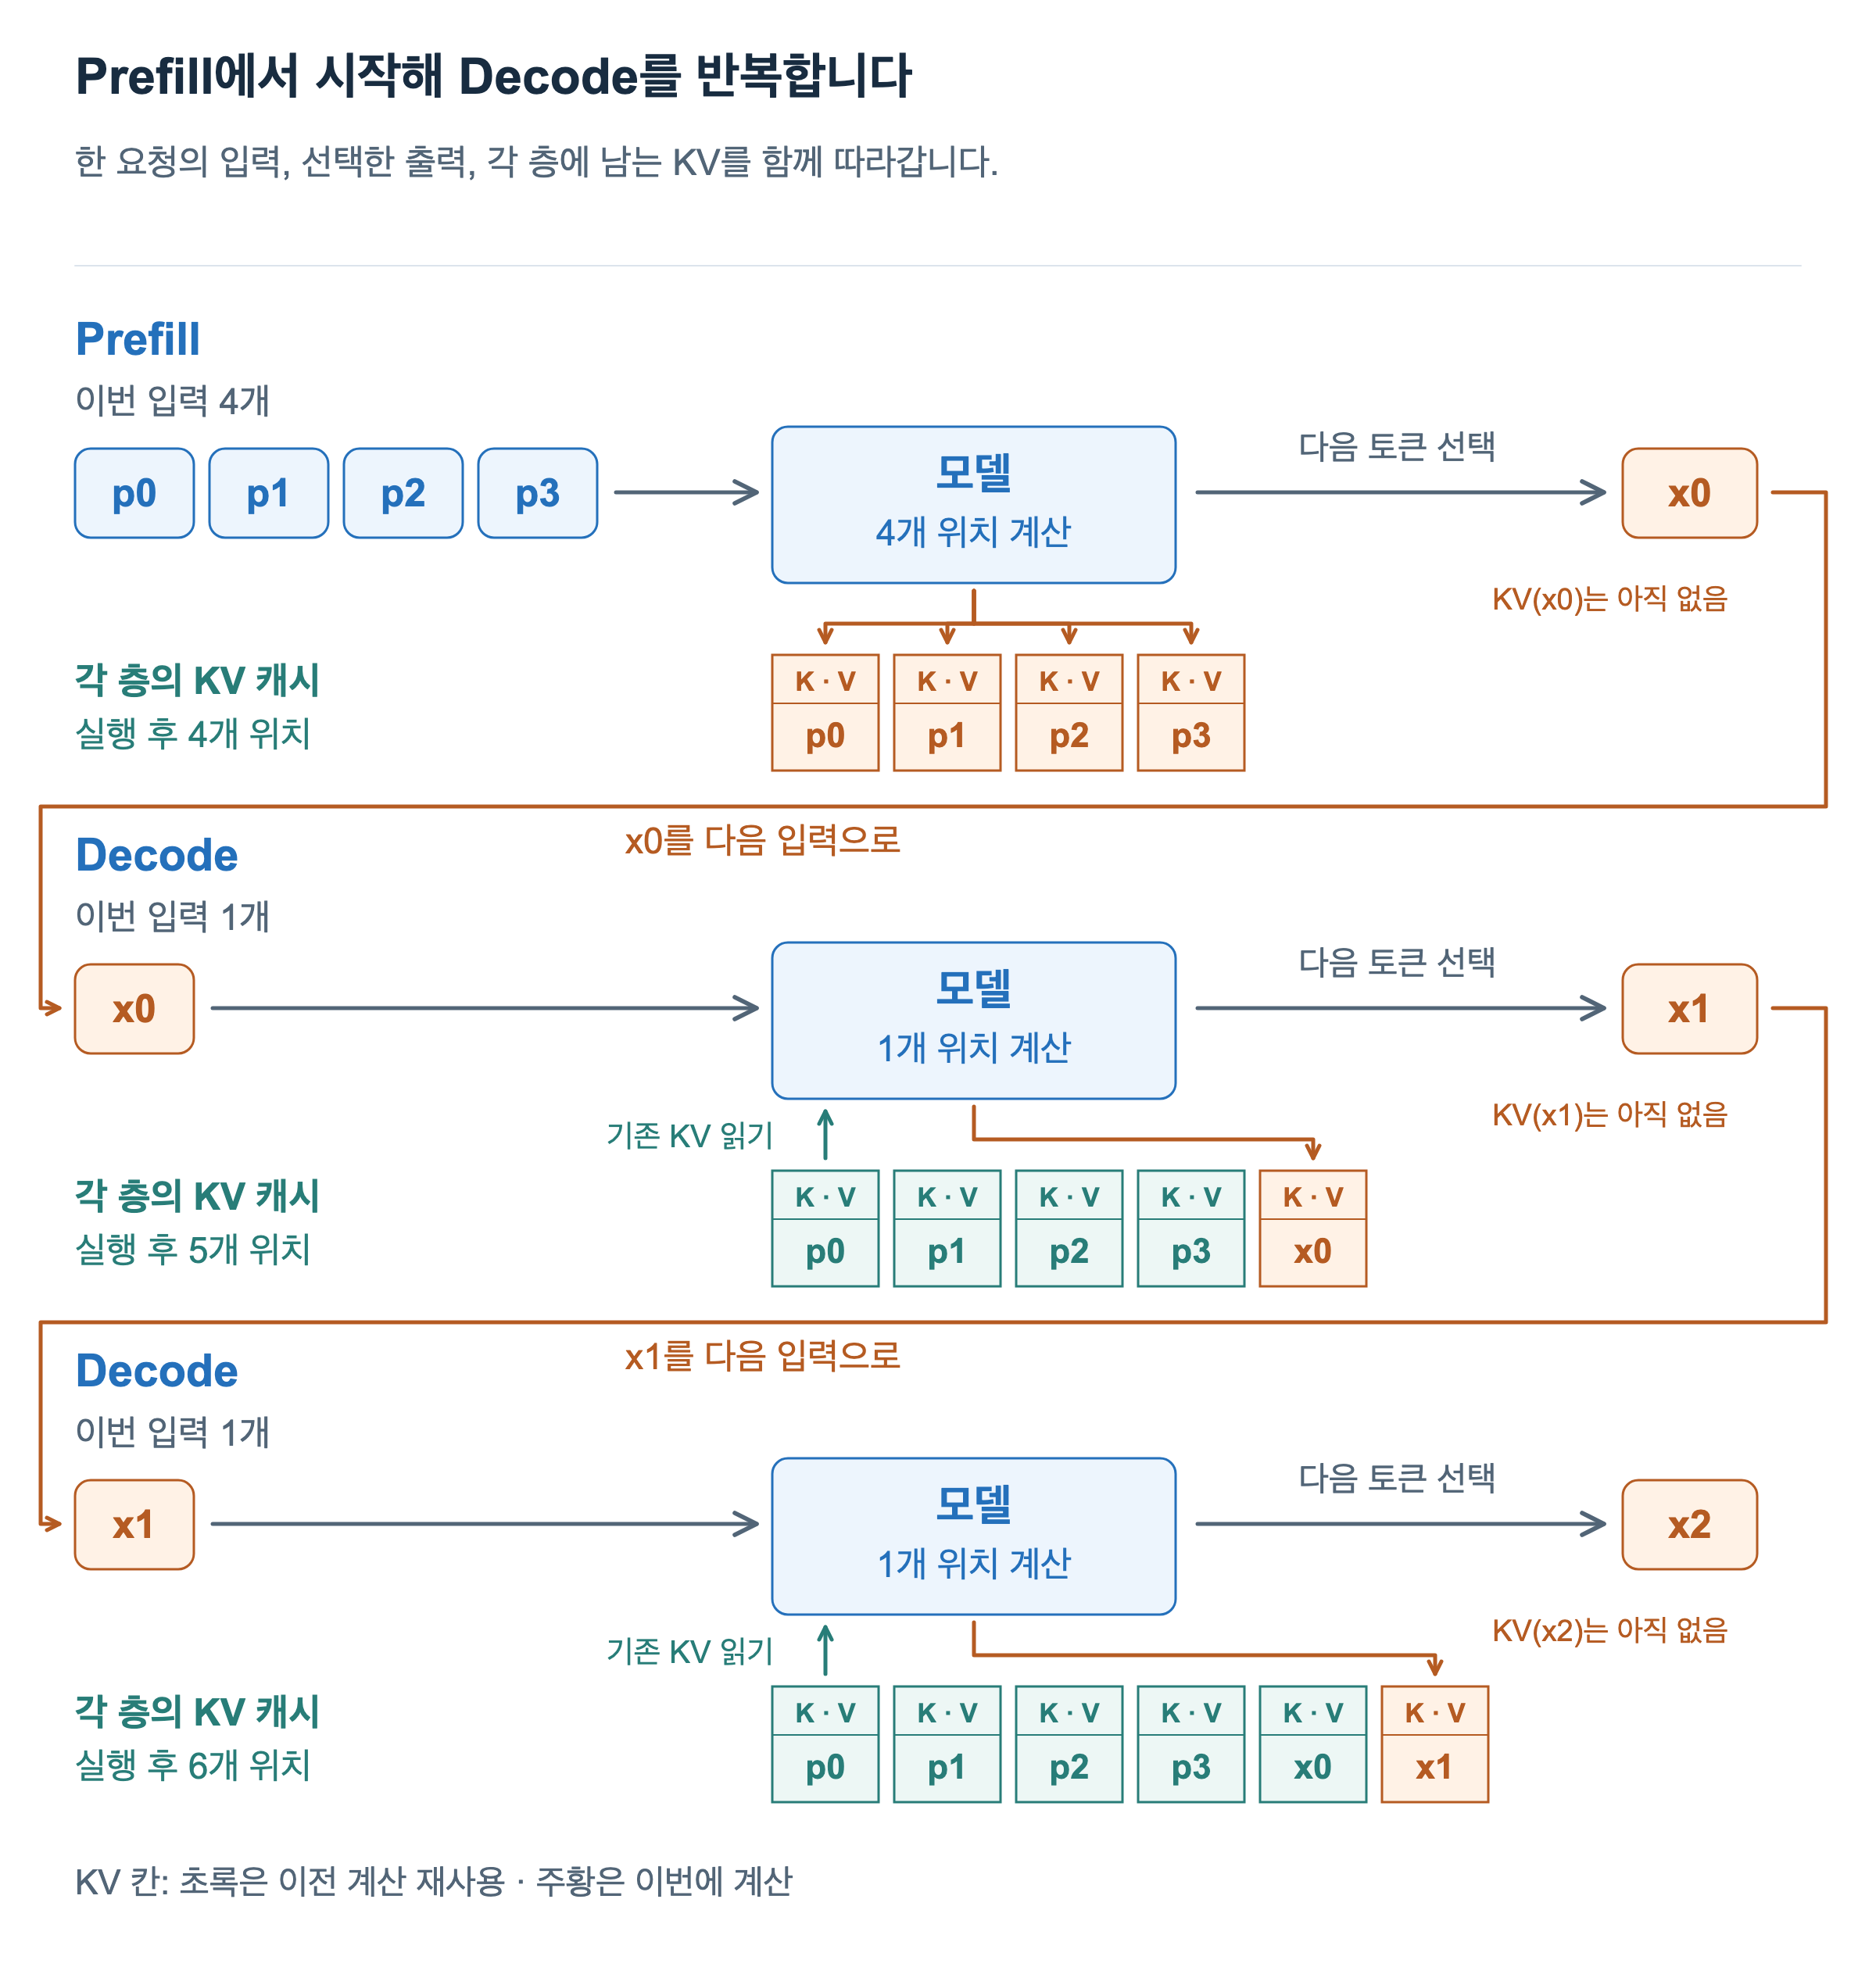
그림 1에서 Prefill은 입력 네 개를 함께 처리하지만, 각 Decode는 입력 하나를 처리합니다. 처음 주어진 입력은 이미 알고 있으므로 함께 계산할 수 있습니다. 반면 생성할 토큰은 앞선 실행이 끝나야 정해집니다. x0를 선택하기 전에 x0를 다음 실행의 입력으로 넣을 수는 없습니다.
앞선 글에서 구별한 토큰 선택과 KV 계산의 경계도 그대로입니다. x0를 선택한 직후에는 p0부터 p3까지의 KV만 있습니다. x0의 KV는 다음 실행에 x0를 입력할 때 만들어집니다. 첫 출력 토큰은 Prefill의 결과로 선택되고, 그다음 출력부터 Decode를 반복해 선택합니다.
처리 토큰 수와 참조 문맥 길이
GPU가 수행할 일을 이해하려면 이번에 처리하는 토큰 수와 Attention이 참조하는 문맥 길이를 구별해야 합니다. 그림 2에서는 요청 하나를 기준으로, 이번 처리 토큰 수를 T, 현재 입력을 포함한 참조 문맥 길이를 L로 표시했습니다.
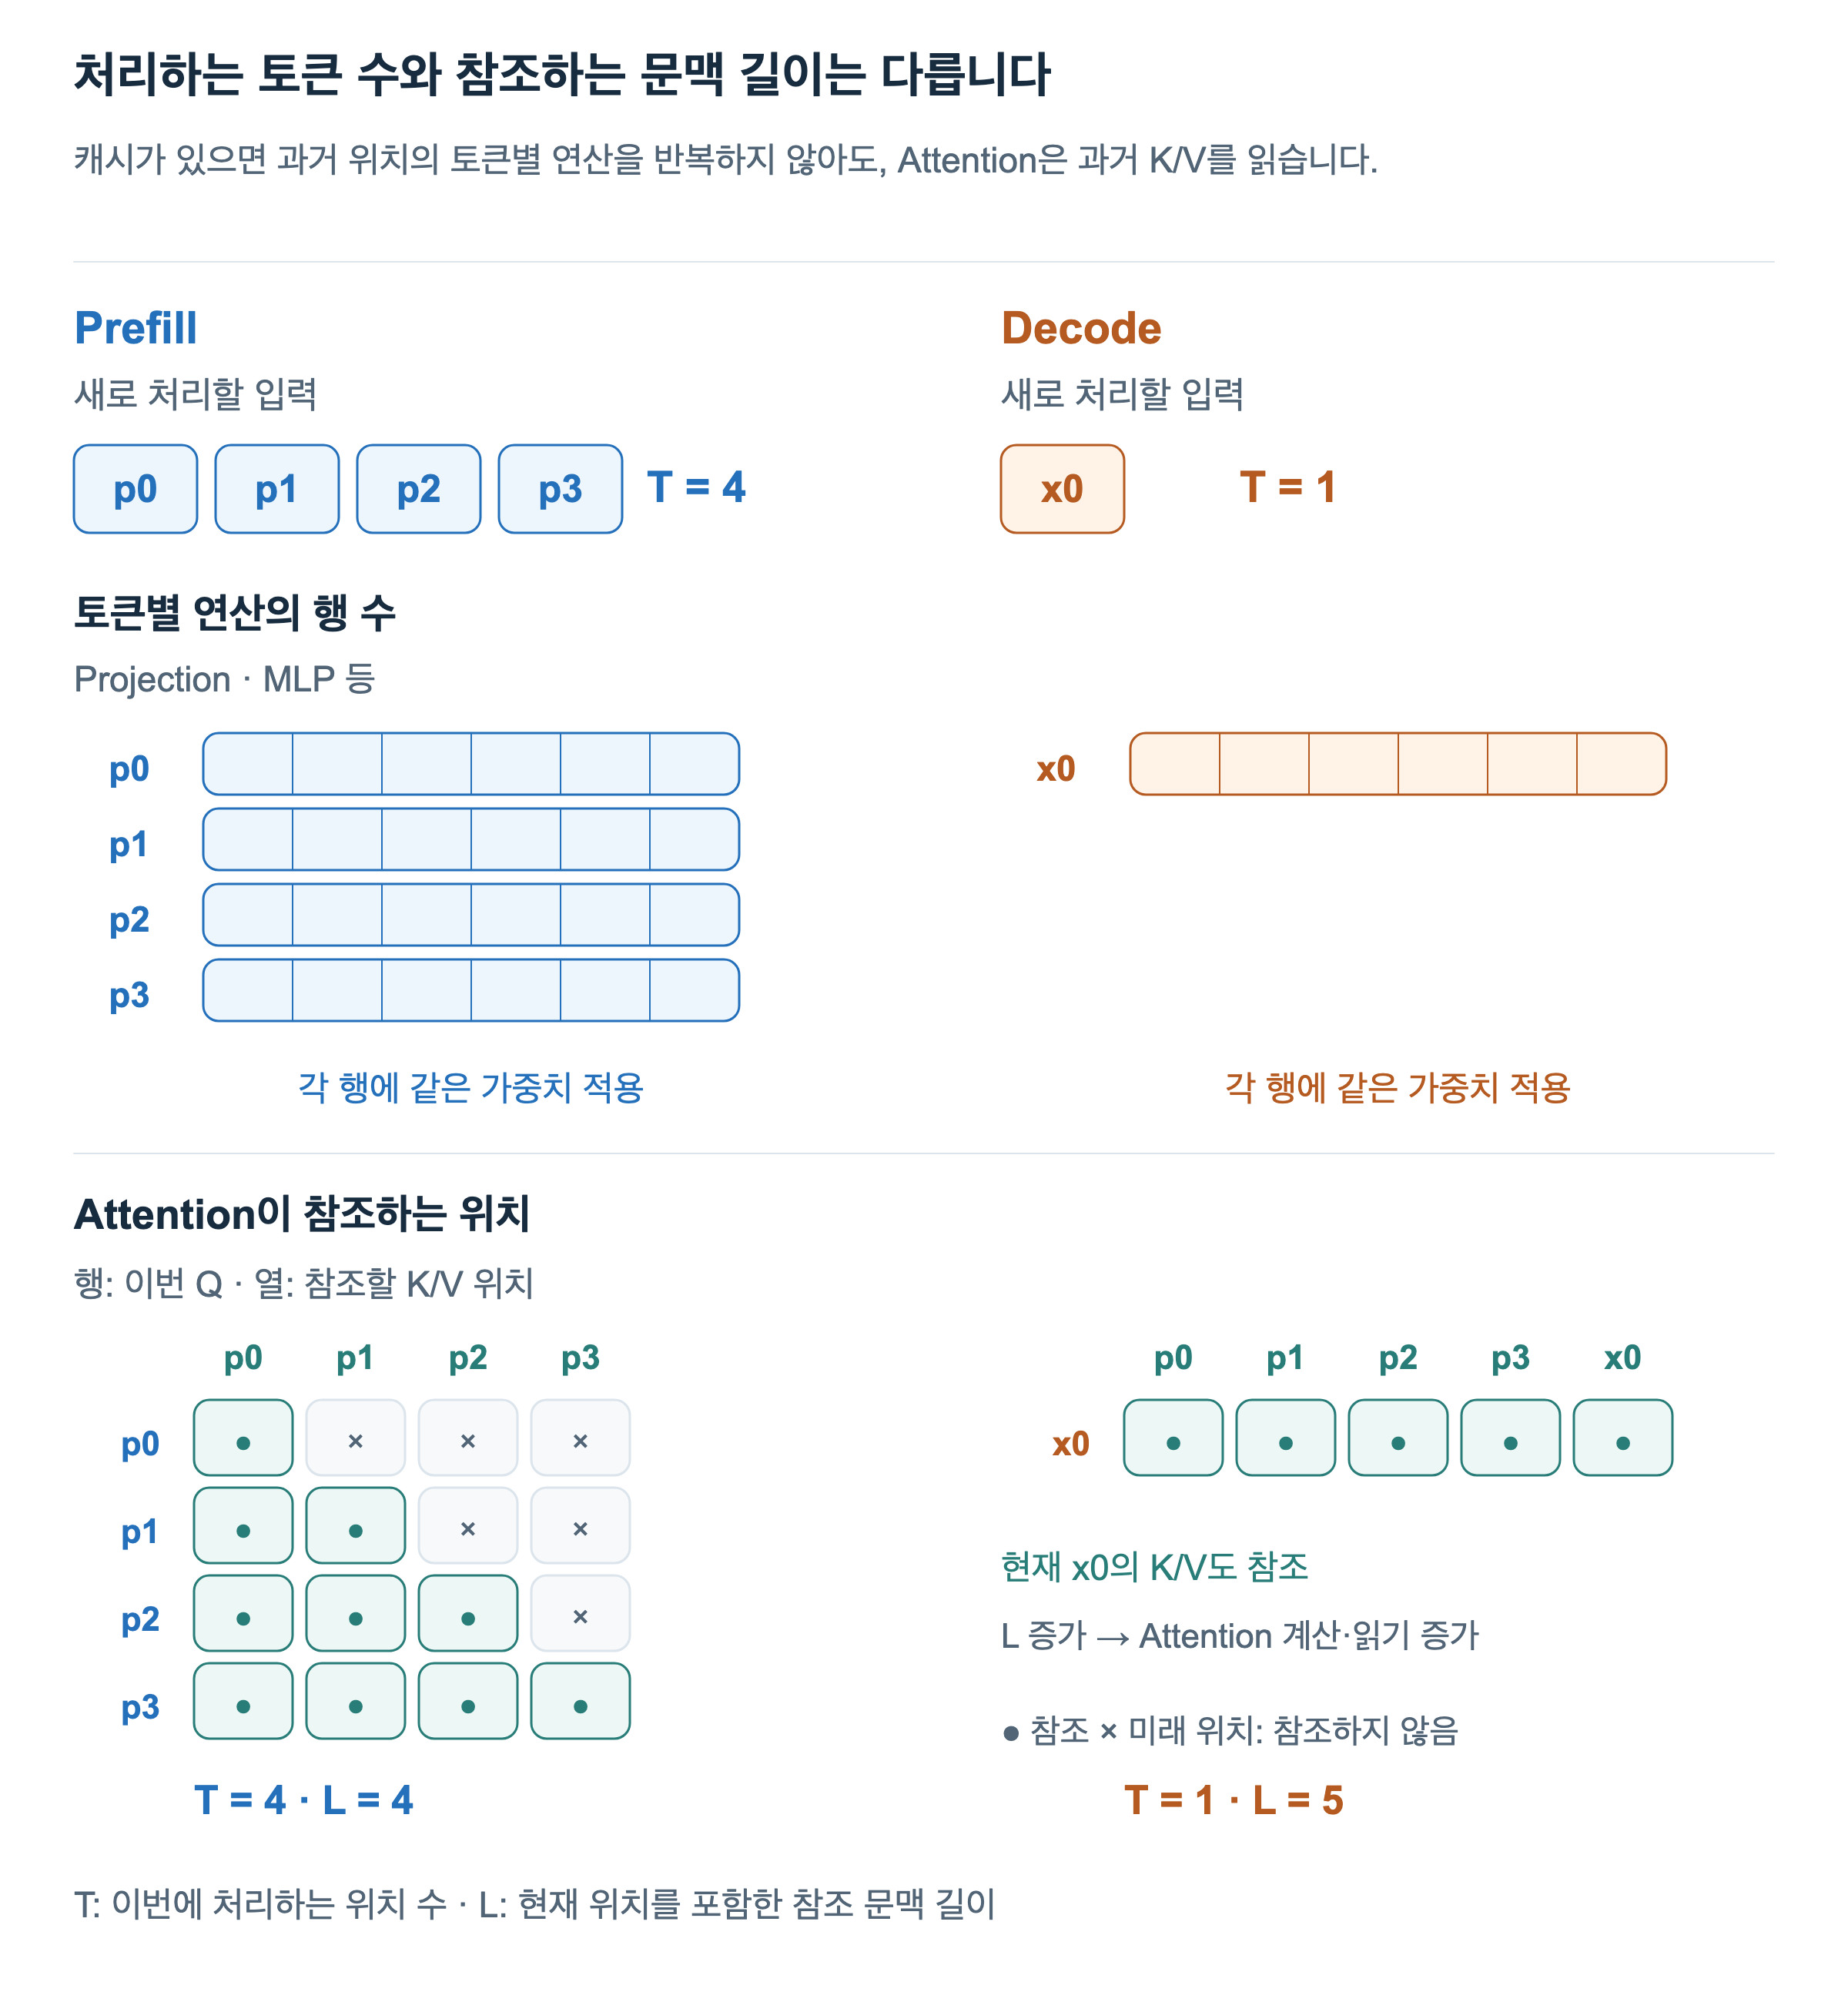
먼저 그림 위쪽의 토큰별 연산을 보겠습니다. Q/K/V를 만드는 Projection과 Attention 출력의 Projection, MLP의 행렬 곱은 각 토큰 위치의 벡터에 같은 가중치를 적용합니다. 모델의 크기가 같다면 이 선형 연산들의 계산량은 이번에 처리하는 토큰 수에 비례합니다. Prefill에서는 네 행을 계산하고, 이어지는 Decode에서는 새 입력 x0의 한 행만 계산합니다. 과거 p0부터 p3까지의 Projection과 MLP를 다시 실행하지 않습니다.
그림 아래쪽의 Attention은 참조 범위가 다릅니다. 행은 이번에 계산한 Q의 위치이고, 열은 참조할 K/V의 위치입니다. Prefill에서는 네 위치의 Q를 함께 계산하되, 각 위치가 자기 위치와 앞부분만 참조합니다. 그래서 참조하는 칸이 삼각형을 이룹니다. Decode에서는 새 Q 하나가 과거 네 위치와 현재 x0의 K/V를 참조합니다. 새로 처리하는 토큰은 하나여도, Attention은 다섯 위치를 사용합니다.
생성이 이어져 문맥이 길어져도 일반적인 Decode의 새 입력은 요청당 하나입니다. 따라서 요청 하나의 Projection과 MLP 계산량은 대체로 같지만, Attention에서 참조할 KV와 그에 따른 계산량은 늘어납니다. 처리 토큰 수만으로 모델 전체의 계산량을 설명할 수 없는 이유입니다. Transformers의 캐시 설명도 새 Q가 과거와 현재 K/V를 함께 사용하는 관계를 보여줍니다.
여기서 한 토큰은 배치 전체가 아니라 요청당 한 토큰입니다. 요청 여덟 개를 한 배치로 묶어 Decode하면 이번에 처리하는 새 입력은 총 여덟 개입니다. 뒤에서는 이처럼 한 실행에 모인 전체 처리 토큰 수를 기준으로 가중치 재사용을 살펴보겠습니다.
같은 가중치로 여러 토큰 계산하기
모델의 가중치는 Prefill과 Decode에서 동일합니다. 토큰 하나를 처리하든 여러 개를 처리하든 같은 선형 계층의 가중치가 필요합니다. 차이는 읽어 온 가중치로 얼마나 많은 토큰을 계산할 수 있는가입니다.
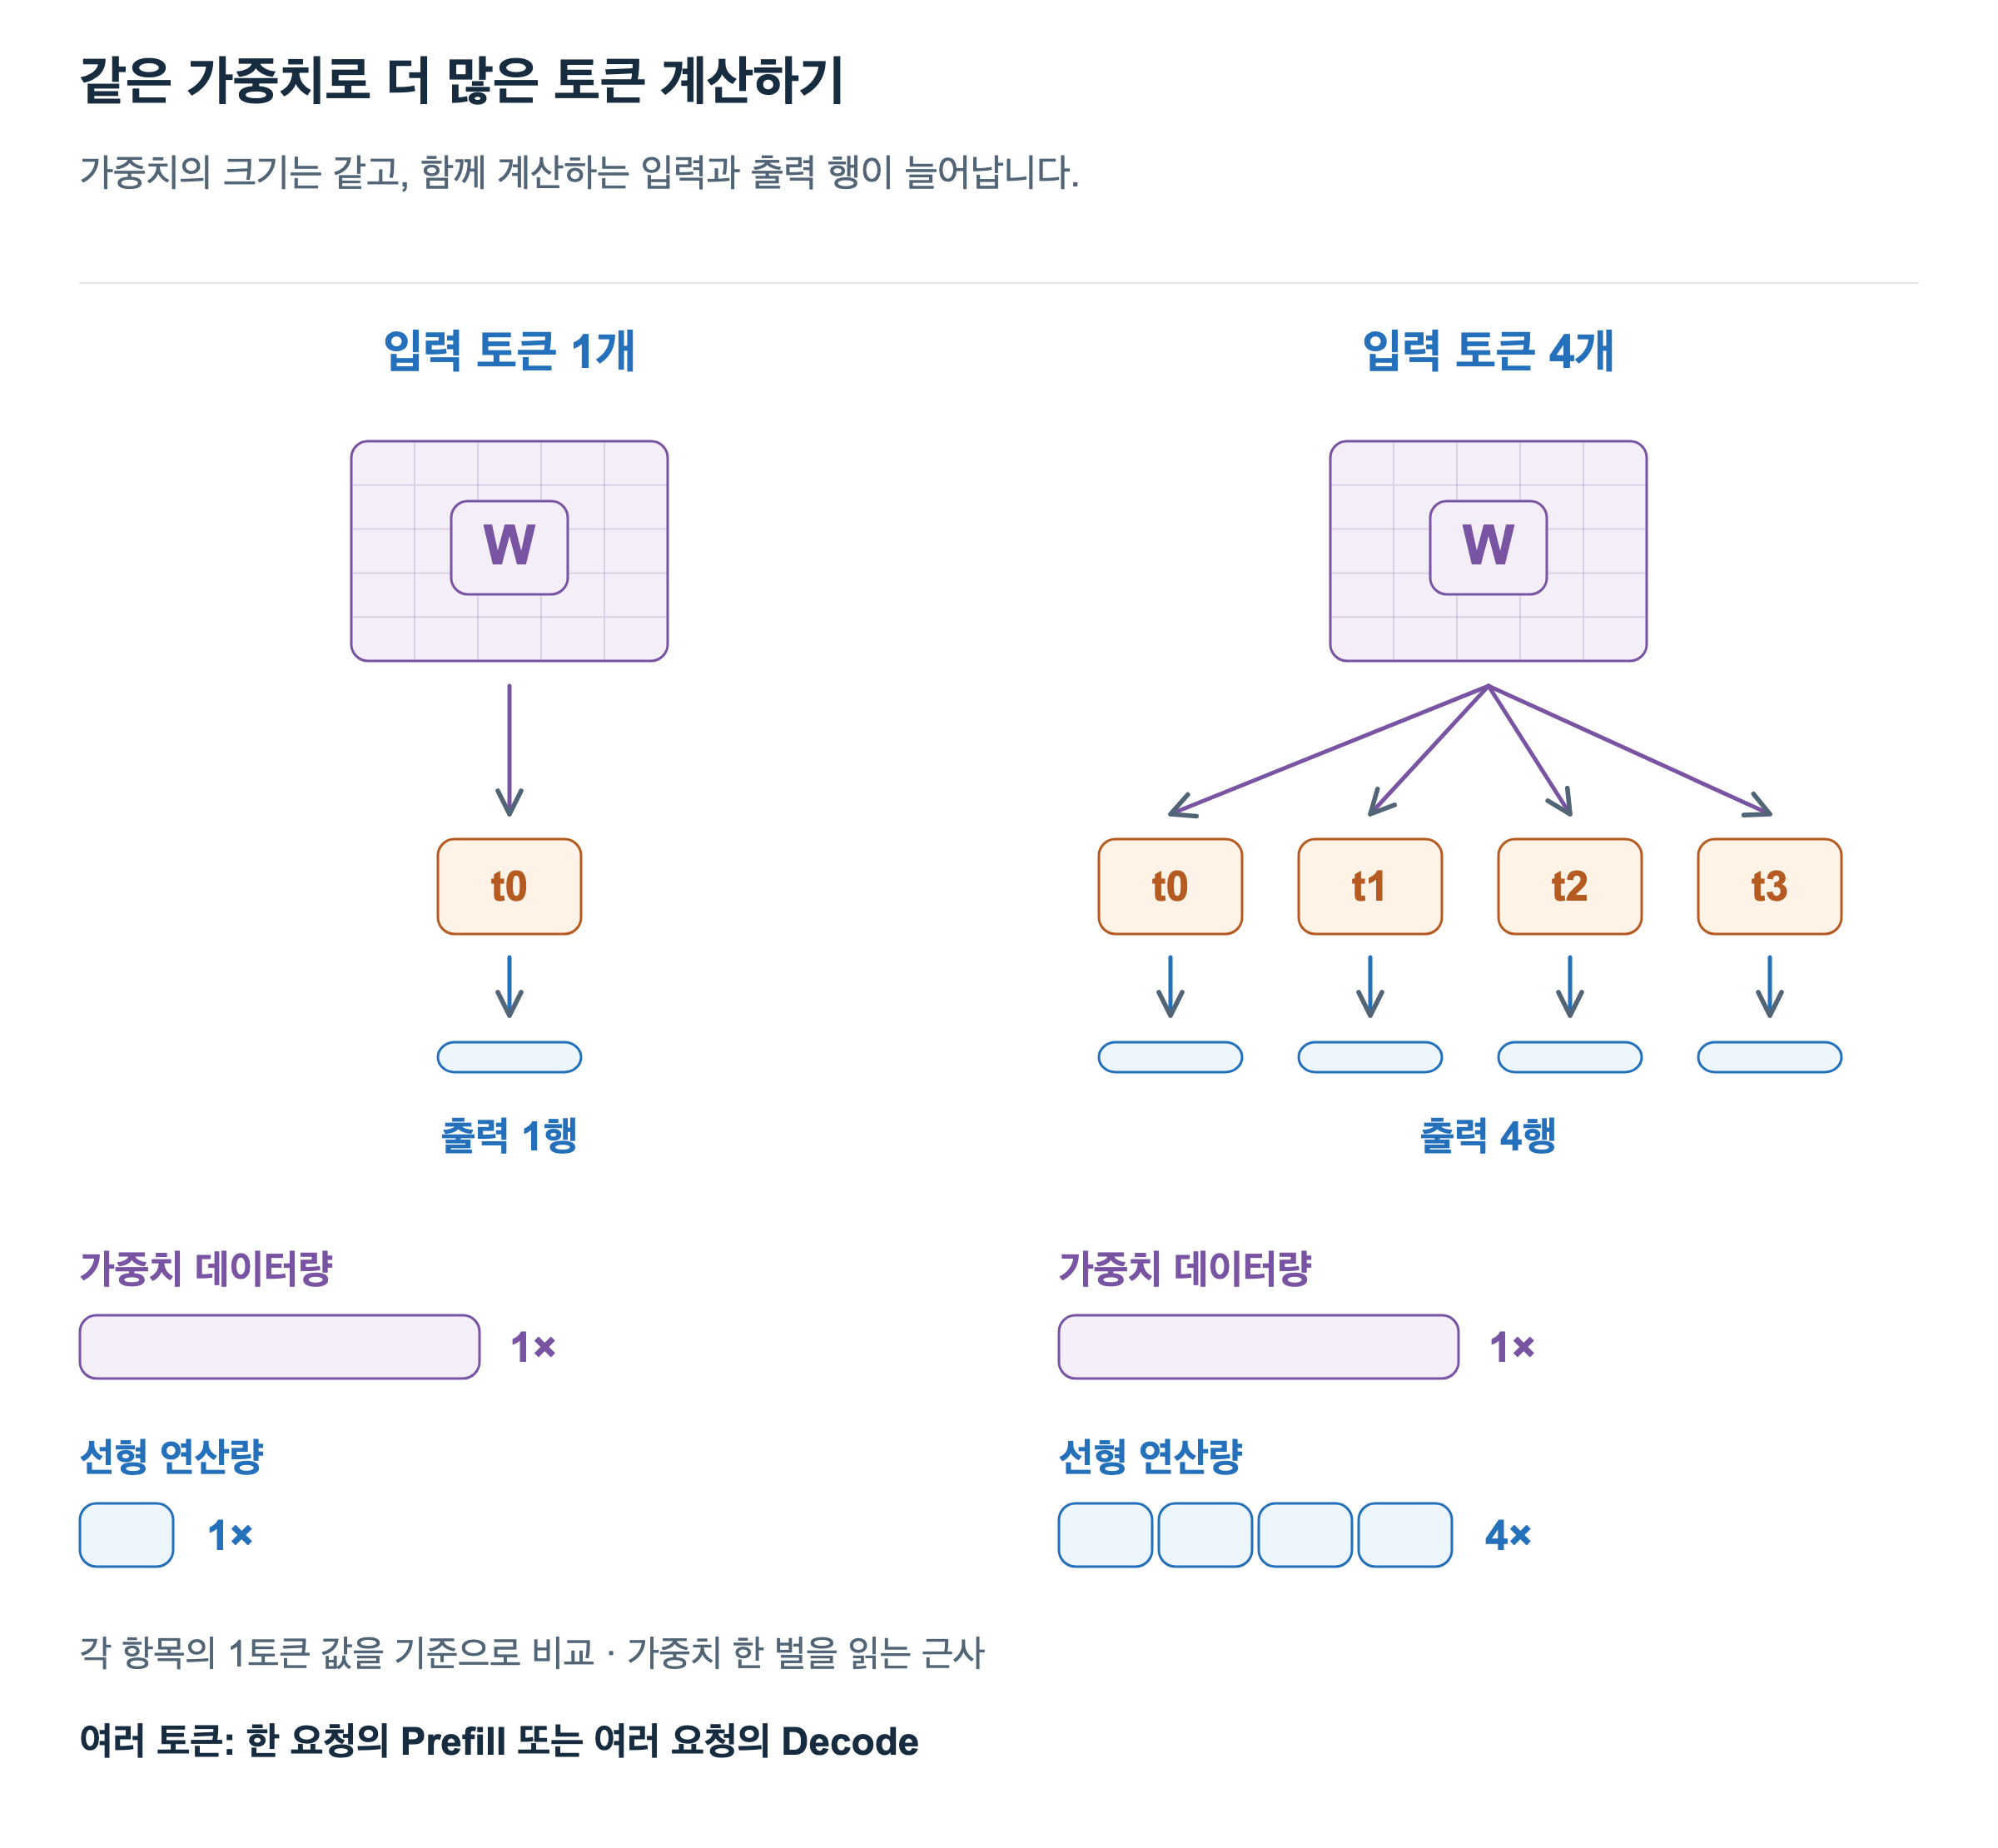
그림 3의 왼쪽은 W를 사용해 입력 한 행을 계산합니다. 오른쪽은 같은 W로 입력 네 행을 계산합니다. 가중치 데이터량은 그대로이고, 계산할 출력과 선형 연산량은 네 배가 됩니다. 여러 입력을 함께 계산하면 메모리에서 가져온 가중치를 각 행의 계산에 재사용할 수 있습니다. 한 요청의 Prefill 토큰들을 모아도, 여러 요청의 Decode 토큰들을 모아도 이런 기회가 생깁니다.
선형 연산 하나의 입력·출력 차원을 각각 d_in, d_out이라고 하면 이 관계는 다음과 같습니다. T는 이번 실행에서 함께 처리하는 토큰 수입니다.
X [T, d_in] × W [d_in, d_out] → Y [T, d_out]

연산량 ≈ 2 × T × d_in × d_out FLOPs
가중치 원소 수 = d_in × d_out
곱셈과 덧셈을 각각 한 FLOP으로 세면, T가 늘 때 연산량은 그에 비례해 늘어납니다. W의 크기는 바뀌지 않습니다. 이때 가중치 읽기가 데이터 이동의 큰 부분을 차지한다면, 더 많은 토큰을 함께 처리할수록 데이터 이동량에 비해 계산량이 커집니다. NVIDIA의 행렬 곱 성능 설명도 이 연산량과 데이터 이동량의 비율을 사용해 병목을 분석합니다.
그림은 가중치 한 벌을 읽는다고 단순화한 비교입니다. 실제로는 입력과 출력도 이동하고, 커널의 처리 방식과 캐시에 따라 같은 가중치를 다시 읽을 수도 있습니다. 여기서 볼 것은 실제 메모리 접근 횟수의 고정된 비율이 아니라, 같은 가중치를 더 많은 계산에 재사용할 수 있다는 관계입니다.
Prefill과 Decode의 병목
산술 강도와 Roofline에서 살펴본 것처럼, 산술 강도는 데이터 이동량에 대한 연산량의 비율입니다. 여기서는 GPU 메모리인 HBM에서 읽고 쓰는 바이트 수를 기준으로 생각하겠습니다. 같은 양의 데이터를 옮겨 더 많은 계산을 하면 산술 강도가 높아집니다.
Roofline은 이 비율을 GPU의 메모리 대역폭과 연산 성능에 연결합니다. 가로축은 산술 강도, 세로축은 초당 수행하는 연산량입니다. 메모리가 공급할 수 있는 데이터량과 연산 장치가 처리할 수 있는 계산량을 모두 만족해야 하므로, 두 조건 중 낮은 쪽이 처리량의 상한을 정합니다.
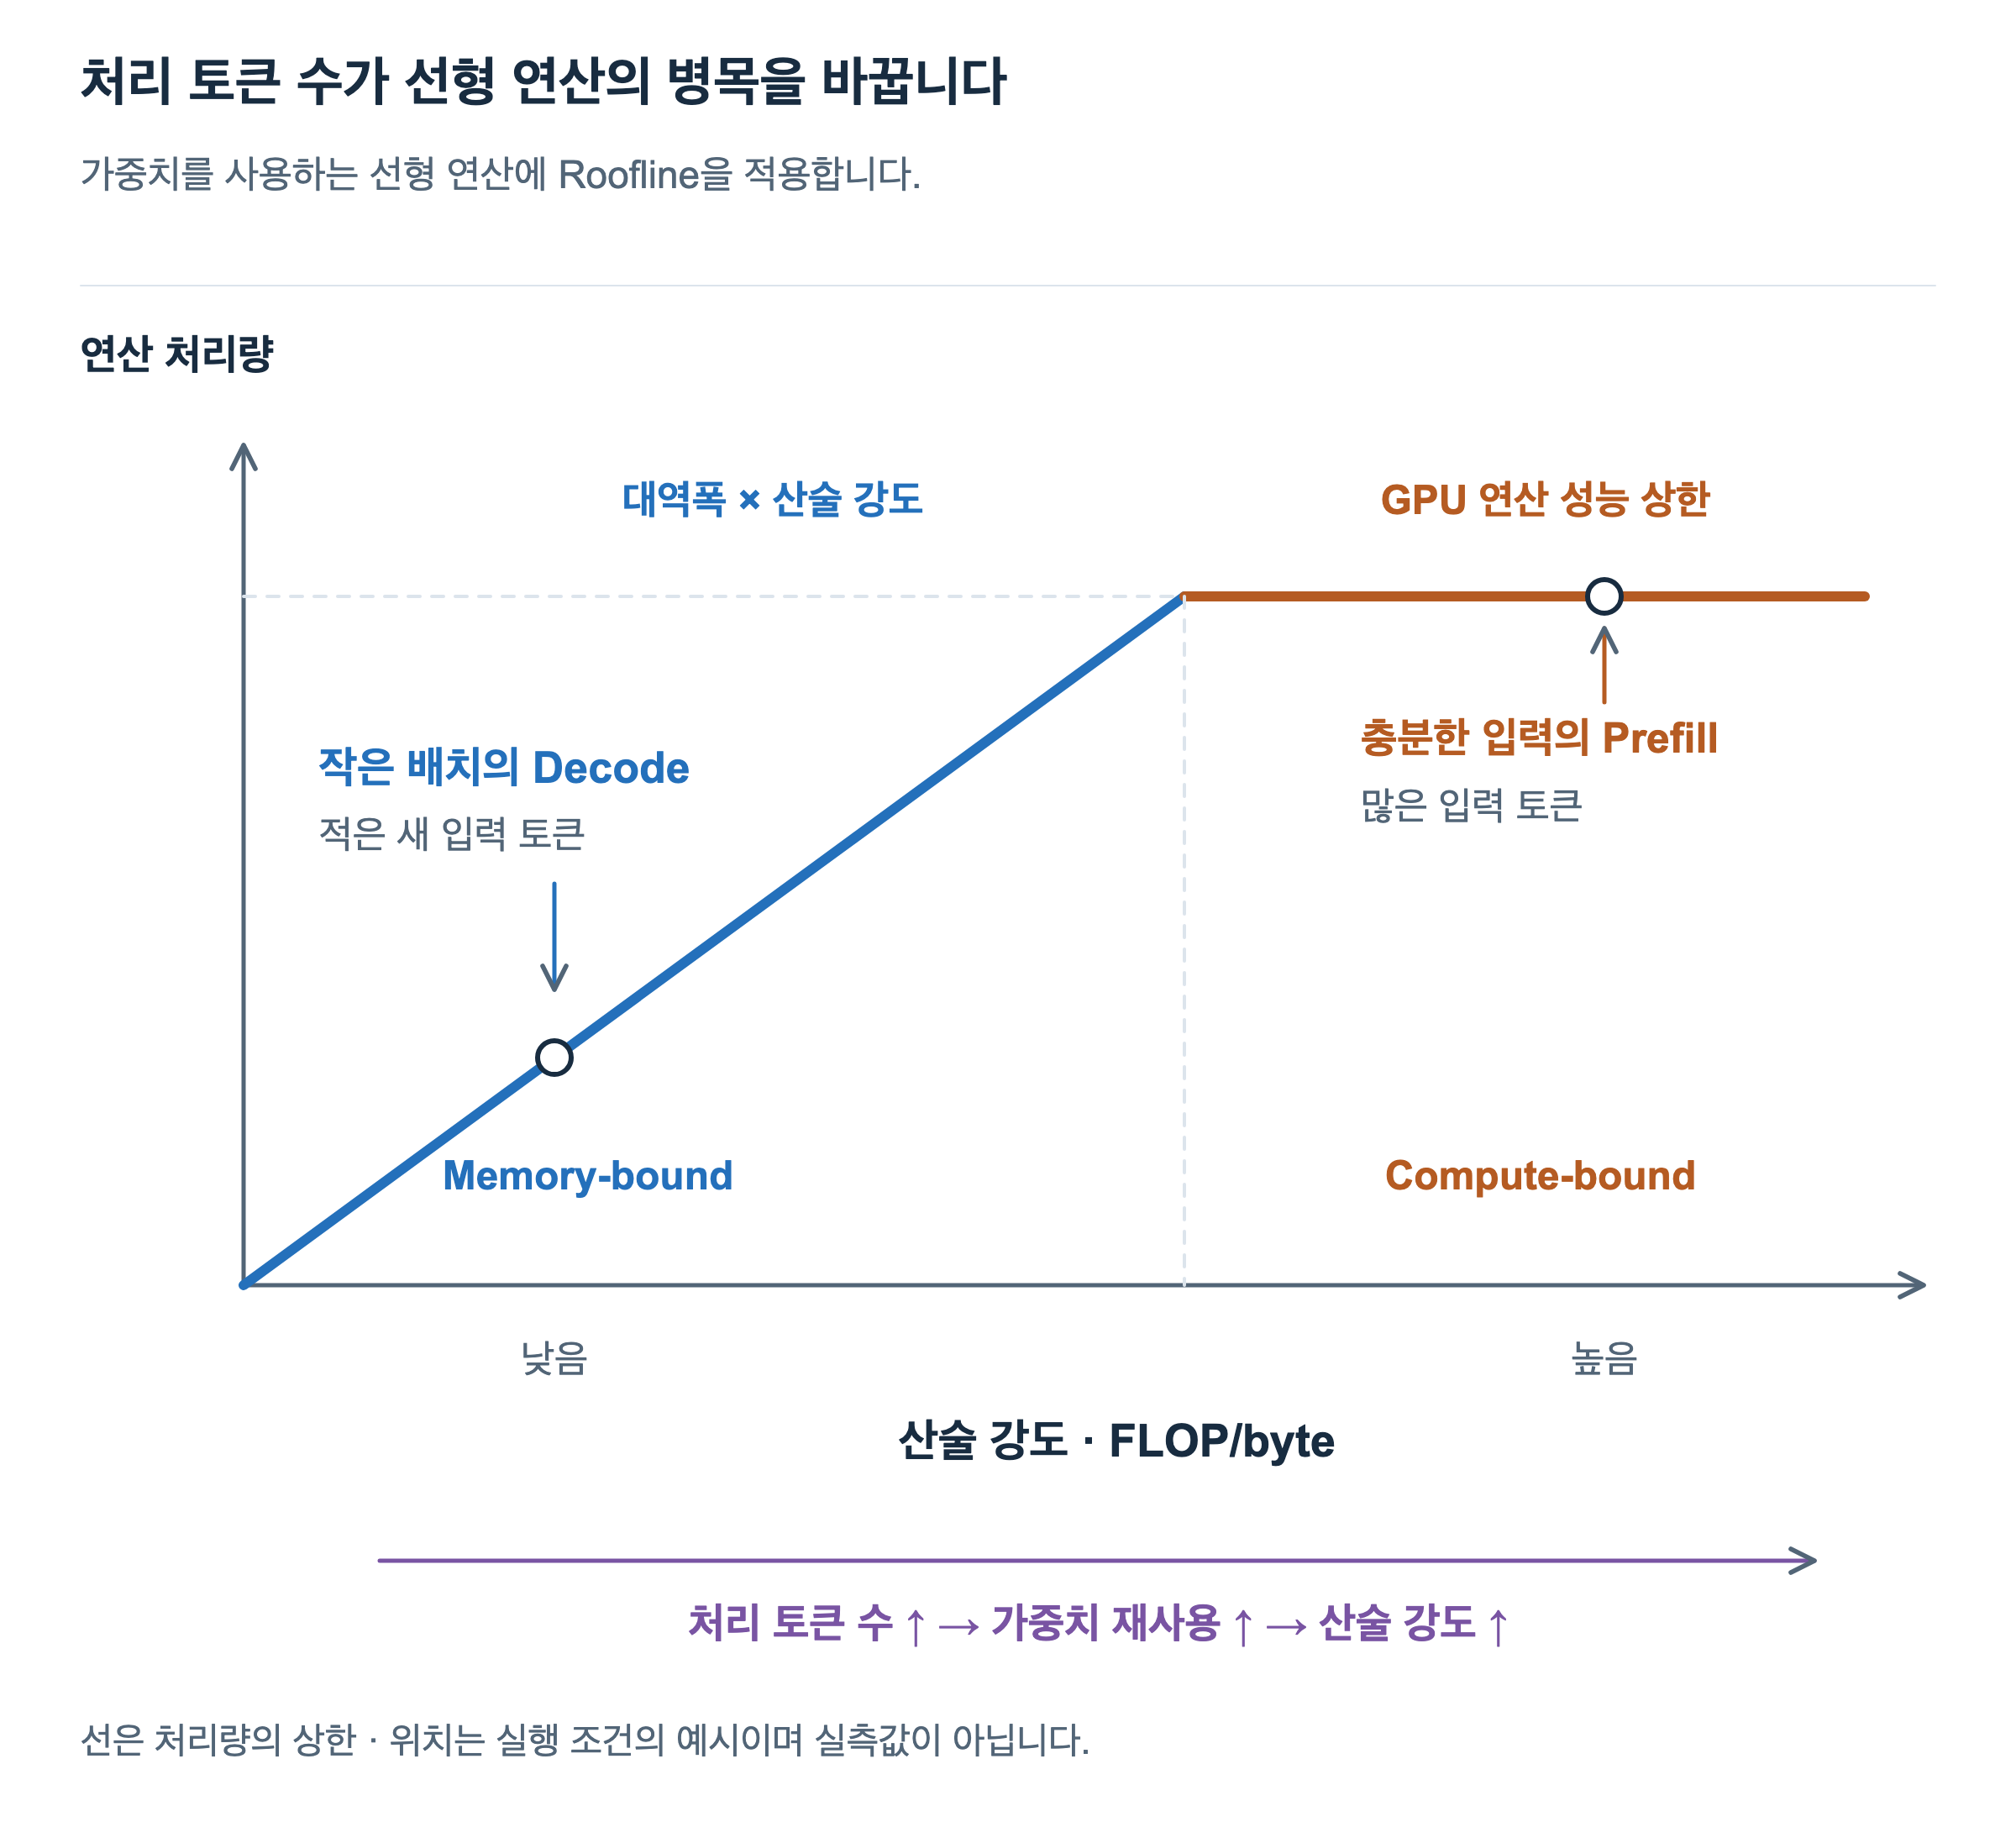
그림 4의 왼쪽에서는 데이터를 옮기는 양에 비해 계산이 적습니다. GPU에 계산할 여력이 있어도 필요한 데이터를 충분히 빠르게 공급하지 못합니다. 이런 경우를 메모리 바운드(memory-bound)라고 합니다. 여기서 메모리의 한계는 저장 공간의 부족이 아니라 데이터를 옮기는 속도입니다.
큰 모델의 가중치를 HBM에서 가져와야 하는 작은 배치의 Decode가 이 조건에 놓이기 쉽습니다. 요청 하나라면 이번에 처리할 새 입력은 하나뿐인데, 그 계산에도 모델의 가중치가 필요합니다. 많은 가중치를 읽고도 각 값으로 수행하는 계산이 적으므로, GPU의 높은 연산 성능을 충분히 활용하기 어렵습니다.
반대로 그림 오른쪽에서는 데이터 이동에 비해 계산이 많아, 연산 장치가 계산을 끝내는 속도가 상한을 정합니다. 이런 경우를 컴퓨트 바운드(compute-bound)라고 합니다. 충분히 긴 입력의 Prefill은 많은 토큰을 함께 처리하며 가중치를 재사용하므로, 선형 연산이 이 조건에 도달하기 쉽습니다. 요청이 하나여도 그 안에 처리할 토큰이 많기 때문입니다.
Decode도 여러 요청의 새 입력을 모으면 선형 연산의 가중치 재사용이 늘어납니다. 따라서 Prefill과 Decode라는 이름만으로 병목이 고정되는 것은 아닙니다. 한 실행에서 함께 처리하는 토큰 수가 중요합니다. 짧은 입력의 Prefill과 큰 배치의 Decode는 그림에 표시한 예시와 다른 위치에 놓일 수 있습니다.
이 그림은 가중치를 사용하는 선형 연산에 Roofline을 적용한 것입니다. 선과 두 표시는 성능 상한과 실행 조건을 설명하며, 특정 모델의 실측값은 아닙니다. 실제 처리량은 커널의 실행 효율 등에 따라 상한보다 낮을 수 있고, 병목이 바뀌는 토큰 수도 GPU와 모델, 자료형에 따라 달라집니다.
배칭의 효과와 KV 읽기
여기까지는 가중치 재사용을 중심으로 살펴보았습니다. 그러면 Decode 배치를 계속 키우면 메모리 병목을 해결할 수 있을까요? 실제 Decode에서는 가중치뿐 아니라 요청마다 다른 KV 캐시도 읽어야 한다는 점을 함께 봐야 합니다.
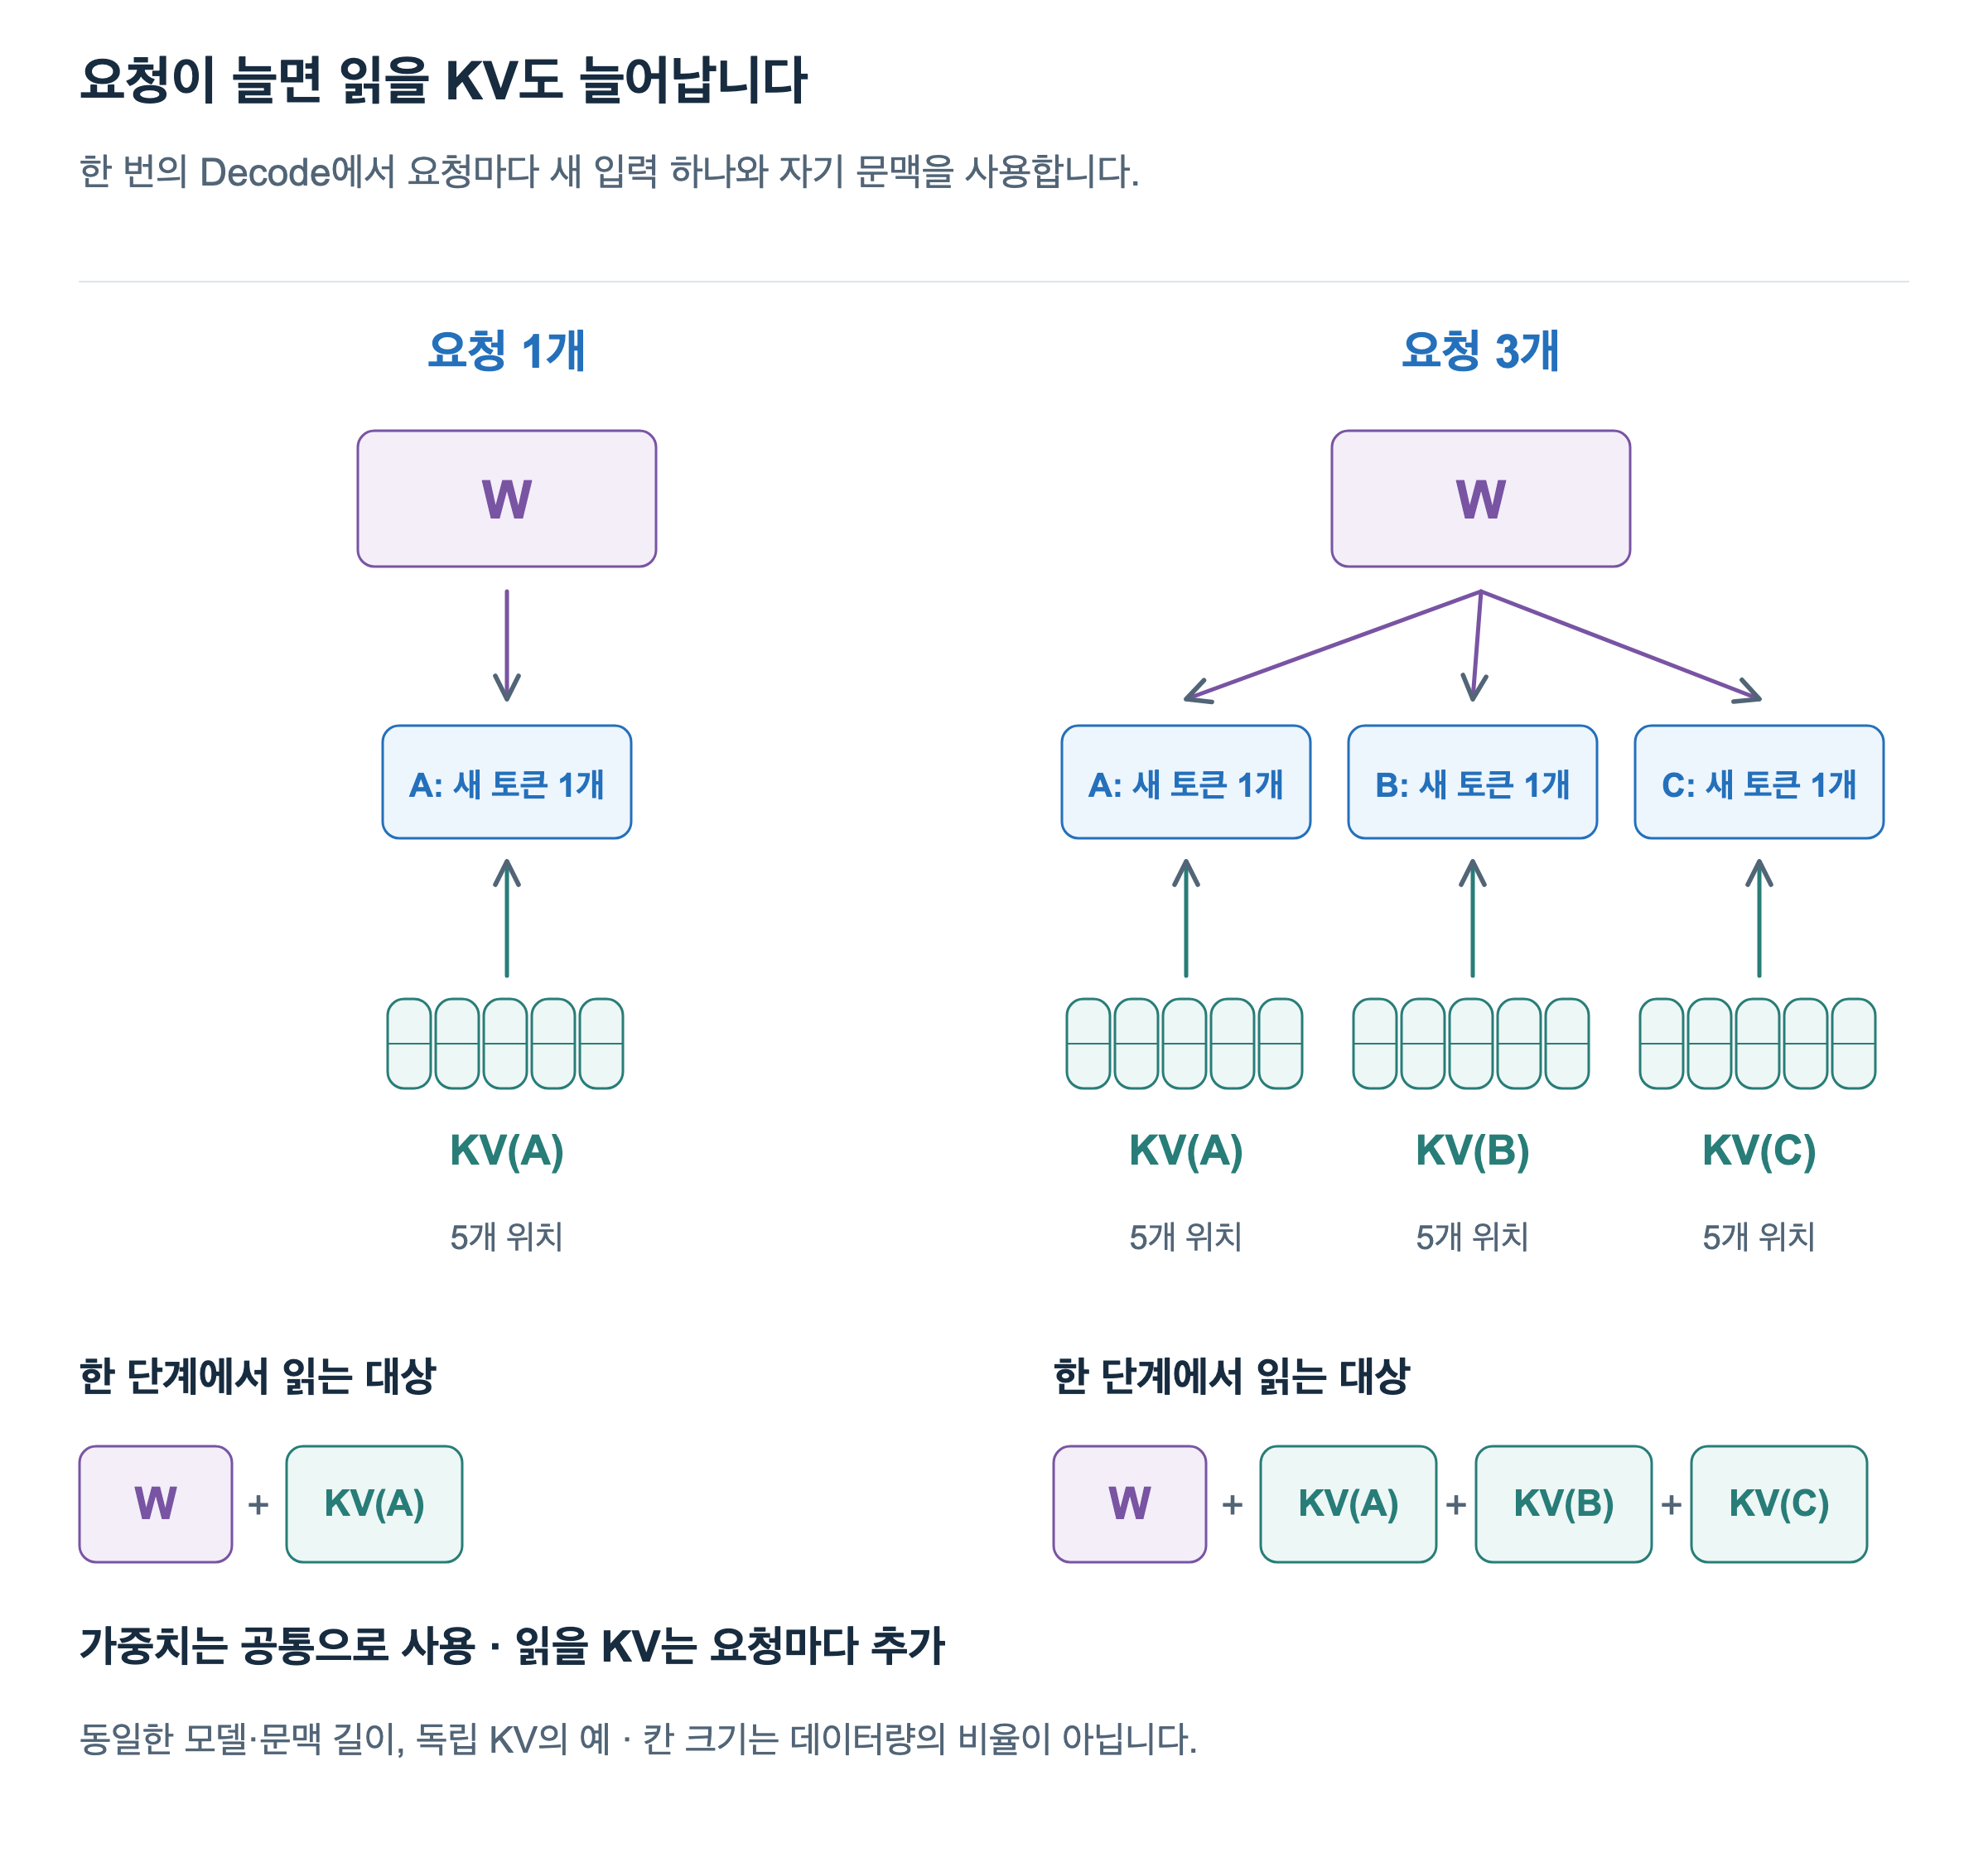
그림 5는 각 요청이 현재 입력을 포함해 다섯 위치를 참조하는 예입니다. 요청 A 하나일 때는 W와 A의 KV를 사용합니다. B와 C를 함께 처리하면 같은 W를 더 많은 토큰 계산에 재사용하지만, B와 C의 KV도 각각 읽어야 합니다. 한 요청의 문맥이 길어질 때도 그 요청에서 읽을 KV가 늘어납니다. JAX Scaling Book의 추론 분석은 이처럼 선형 연산의 가중치 비용과 Attention의 KV 비용을 구별합니다.
따라서 배칭으로 가중치 재사용을 늘릴 수 있어도, 요청별 KV 읽기 비용까지 없어지는 것은 아닙니다. 특히 KV 읽기의 비중이 커지면 배치를 늘리는 효과에도 한계가 생깁니다. 앞선 Roofline의 가중치 재사용 설명을 Decode 전체에 그대로 확대해서는 안 되는 이유입니다.
여러 요청을 함께 실행하는 것은 Decode의 효율을 높이는 중요한 방법입니다. 다만 실제로는 요청마다 도착 시점과 문맥 길이가 다르고, 사용할 수 있는 GPU 자원도 제한되어 있습니다. 다음 글에서는 배치와 스케줄링을 다루며 이 요청들을 어떤 단위로 모으고, 다음 실행에 무엇을 넣을지 살펴보겠습니다.